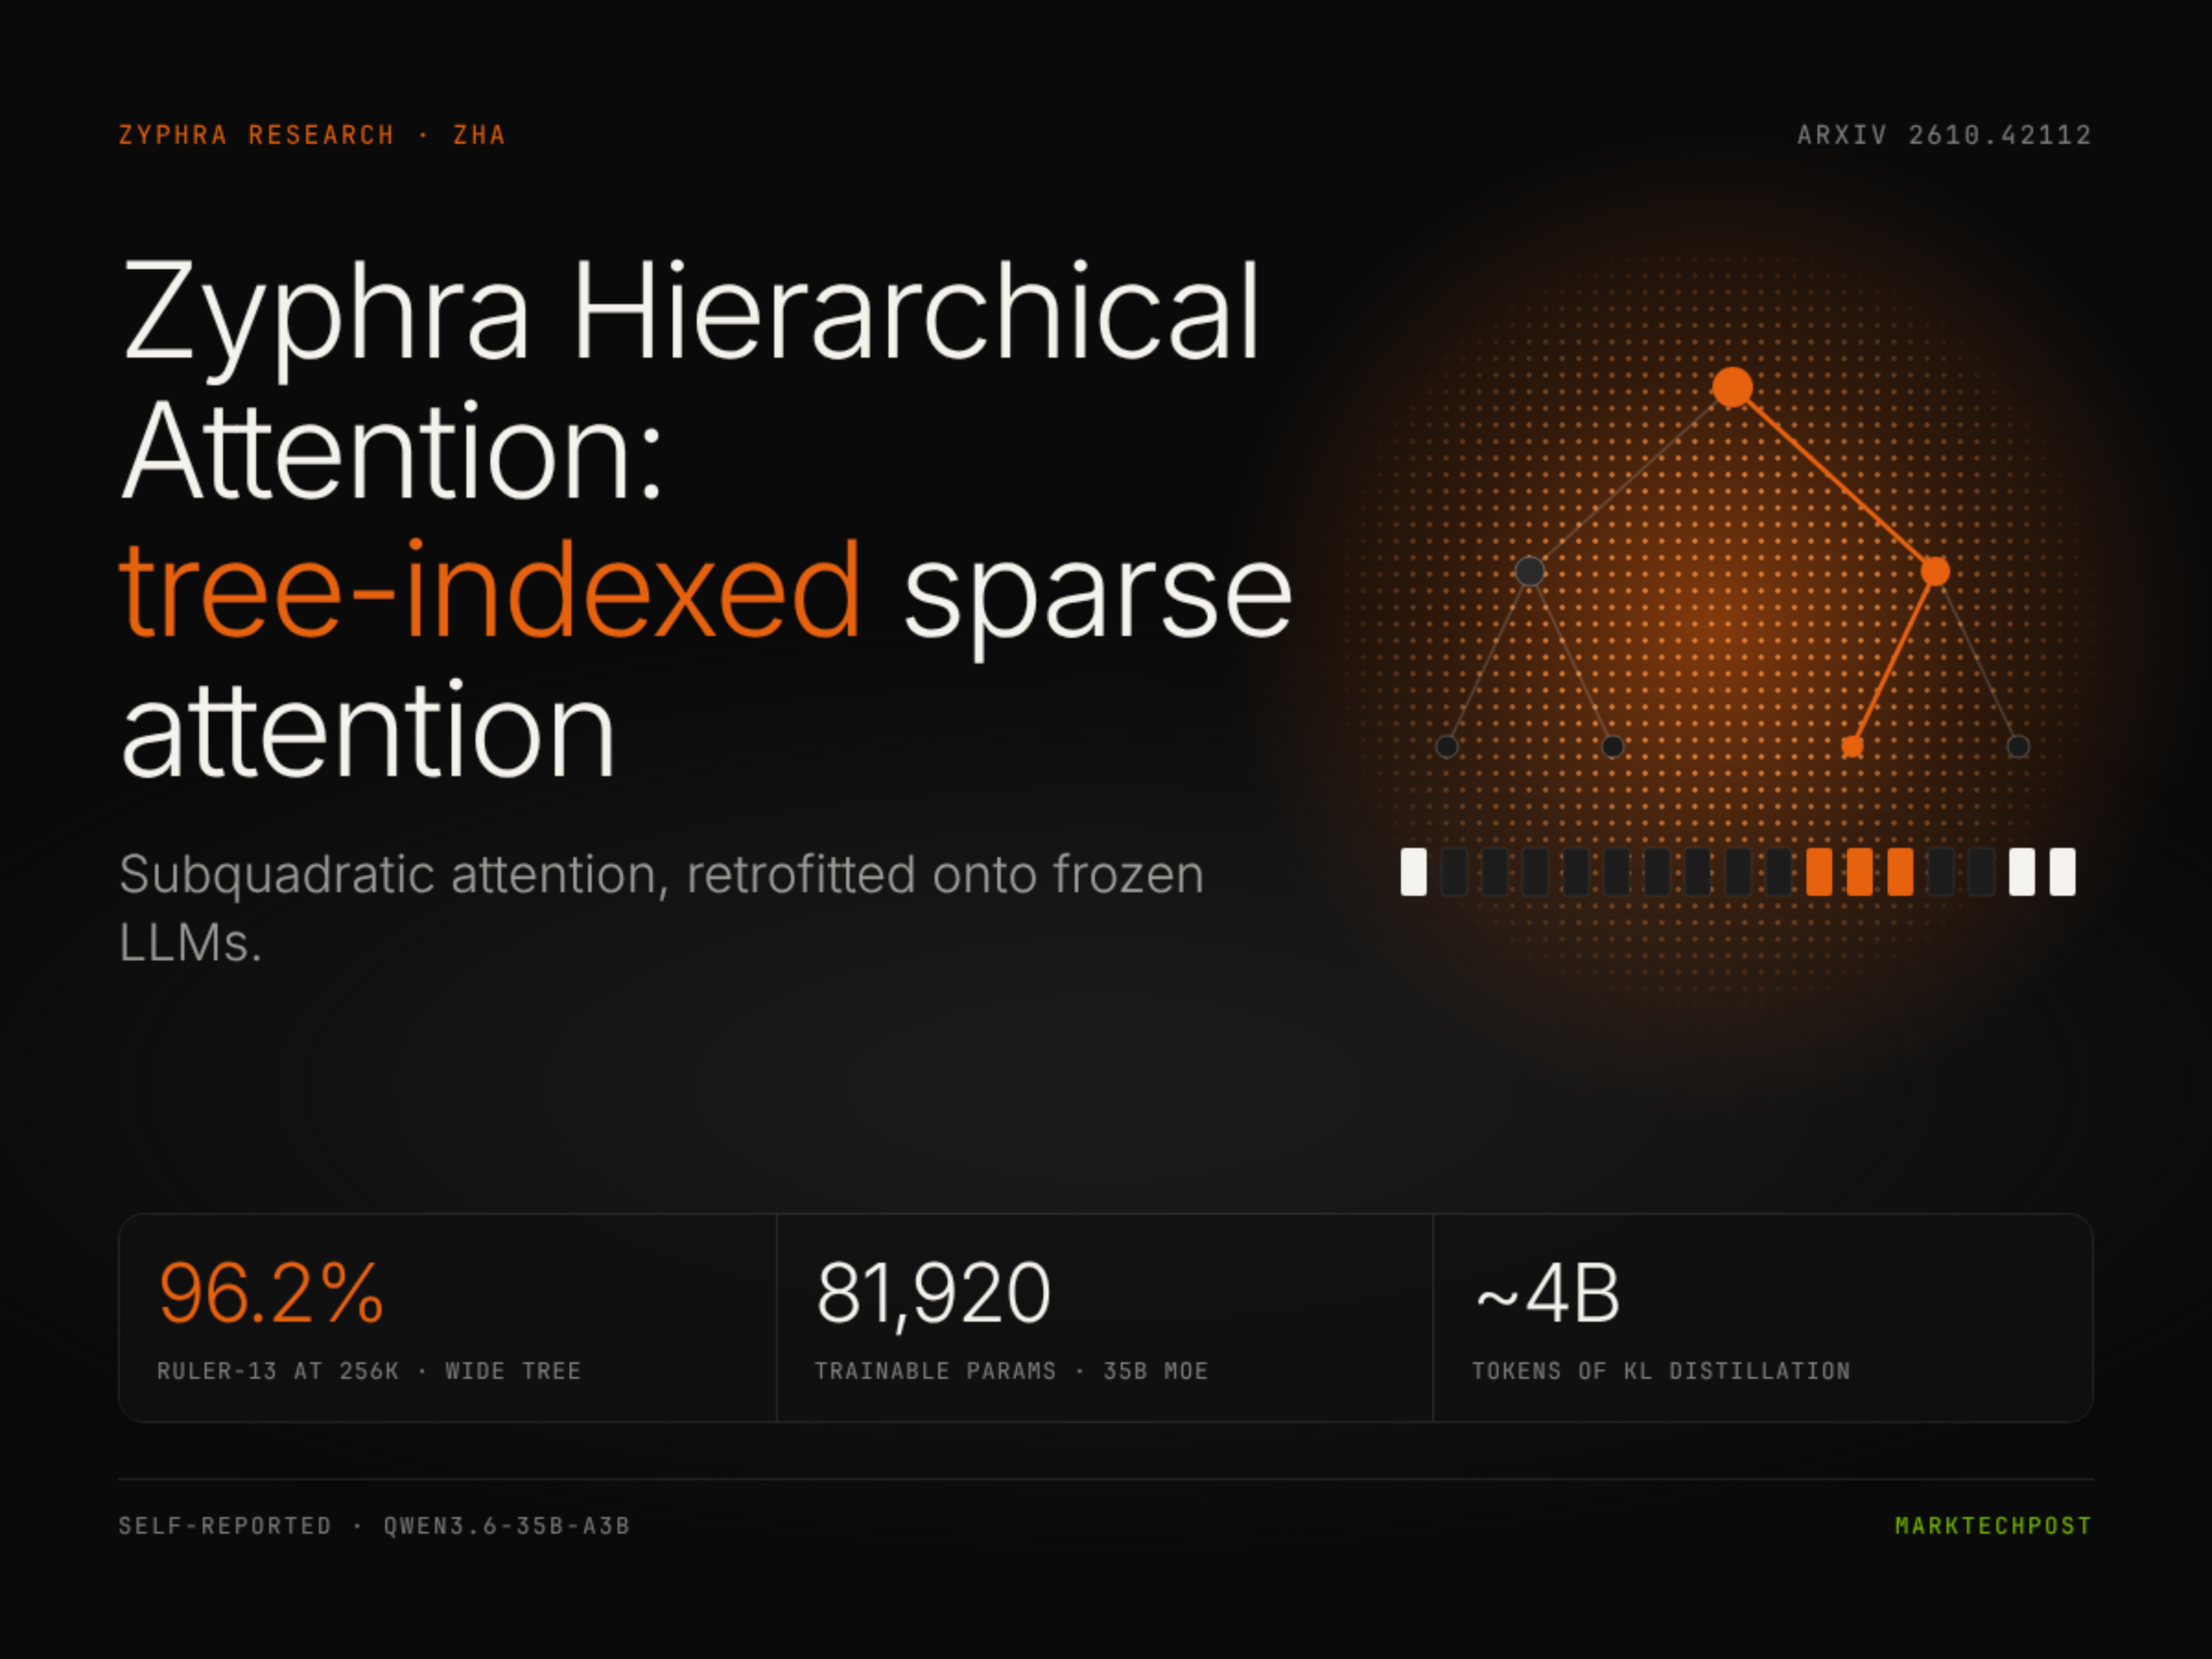
Segun MarkTechPost (AI/ML News), Zyphra ha presentado Zyphra Hierarchical Attention (ZHA), un enfoque de atención esparsa diseñado para optimizar el uso de recursos en modelos de inteligencia artificial. Esta innovación se centra en resolver un problema conocido en los sistemas de atención: el índice que selecciona las claves relevantes aún debe revisar el contexto completo, lo que consume tiempo y capacidad. ZHA introduce una estructura jerárquica basada en un índice en forma de árbol, que determina qué claves del caché se leen a cada consulta, sin necesidad de recorrer todos los tokens almacenados.
El método permite integrarse a modelos preentrenados ya existentes, como Qwen3.6-35B-A3B, mediante un proceso de calentamiento (KL warmup) con 4 billones de tokens y contexto de hasta 32 mil. Aunque se añaden 81.920 parámetros entrenables —equivalente al 0,00024% del tamaño total del modelo—, los resultados muestran un rendimiento muy cercano al de la atención densa en múltiples pruebas. En benchmarks de razonamiento, codificación y recuperación de información de 256 mil tokens, ZHA alcanza puntuaciones que solo varían en unos puntos respecto al modelo completo. Por ejemplo, en LongBench v2, el rendimiento en un árbol profundo alcanza el 63,4%, frente al 58,0% en atención densa, utilizando solo el 1,1% de las claves. Sin embargo, en casos específicos, como el modelo Nemotron-3.5-Lightning-30B-A3B, se observa una caída de 25,3 puntos en el rendimiento en la prueba RULER-13.
La solución se basa en mantener el caché completo de claves y valores (KV cache), mientras que el árbol jerárquico selecciona solo las entradas pertinentes para cada consulta. Esto permite reducir significativamente el tiempo de búsqueda, especialmente en contextos largos, donde métodos tradicionales como los de ventana deslizante o los modelos de estado fijo (SSMs) alcanzan su límite de rendimiento. Estudios citados indican que cerca de 60 a 90 por ciento del tiempo de ejecución de una capa se dedica a indexar, lo que ZHA busca minimizar mediante un enfoque más eficiente.
Para el lector peruano, esta evolución en inteligencia artificial tiene implicaciones directas en el acceso a herramientas de análisis y automatización. Aunque actualmente los modelos de IA de alto rendimiento son accesibles principalmente en entornos corporativos, tecnologías como ZHA podrían reducir costos operativos y aumentar la eficiencia en aplicaciones como el análisis financiero, la gestión de datos de empresas o la automatización de procesos administrativos. Al permitir que los modelos funcionen con menos recursos sin perder calidad, se abre la posibilidad de que empresas más pequeñas o medianas en el país adopten soluciones de IA más sostenibles, sin necesidad de infraestructura costosa. Esto podría acelerar el uso de inteligencia artificial en sectores clave como el comercio, la banca o la administración pública.