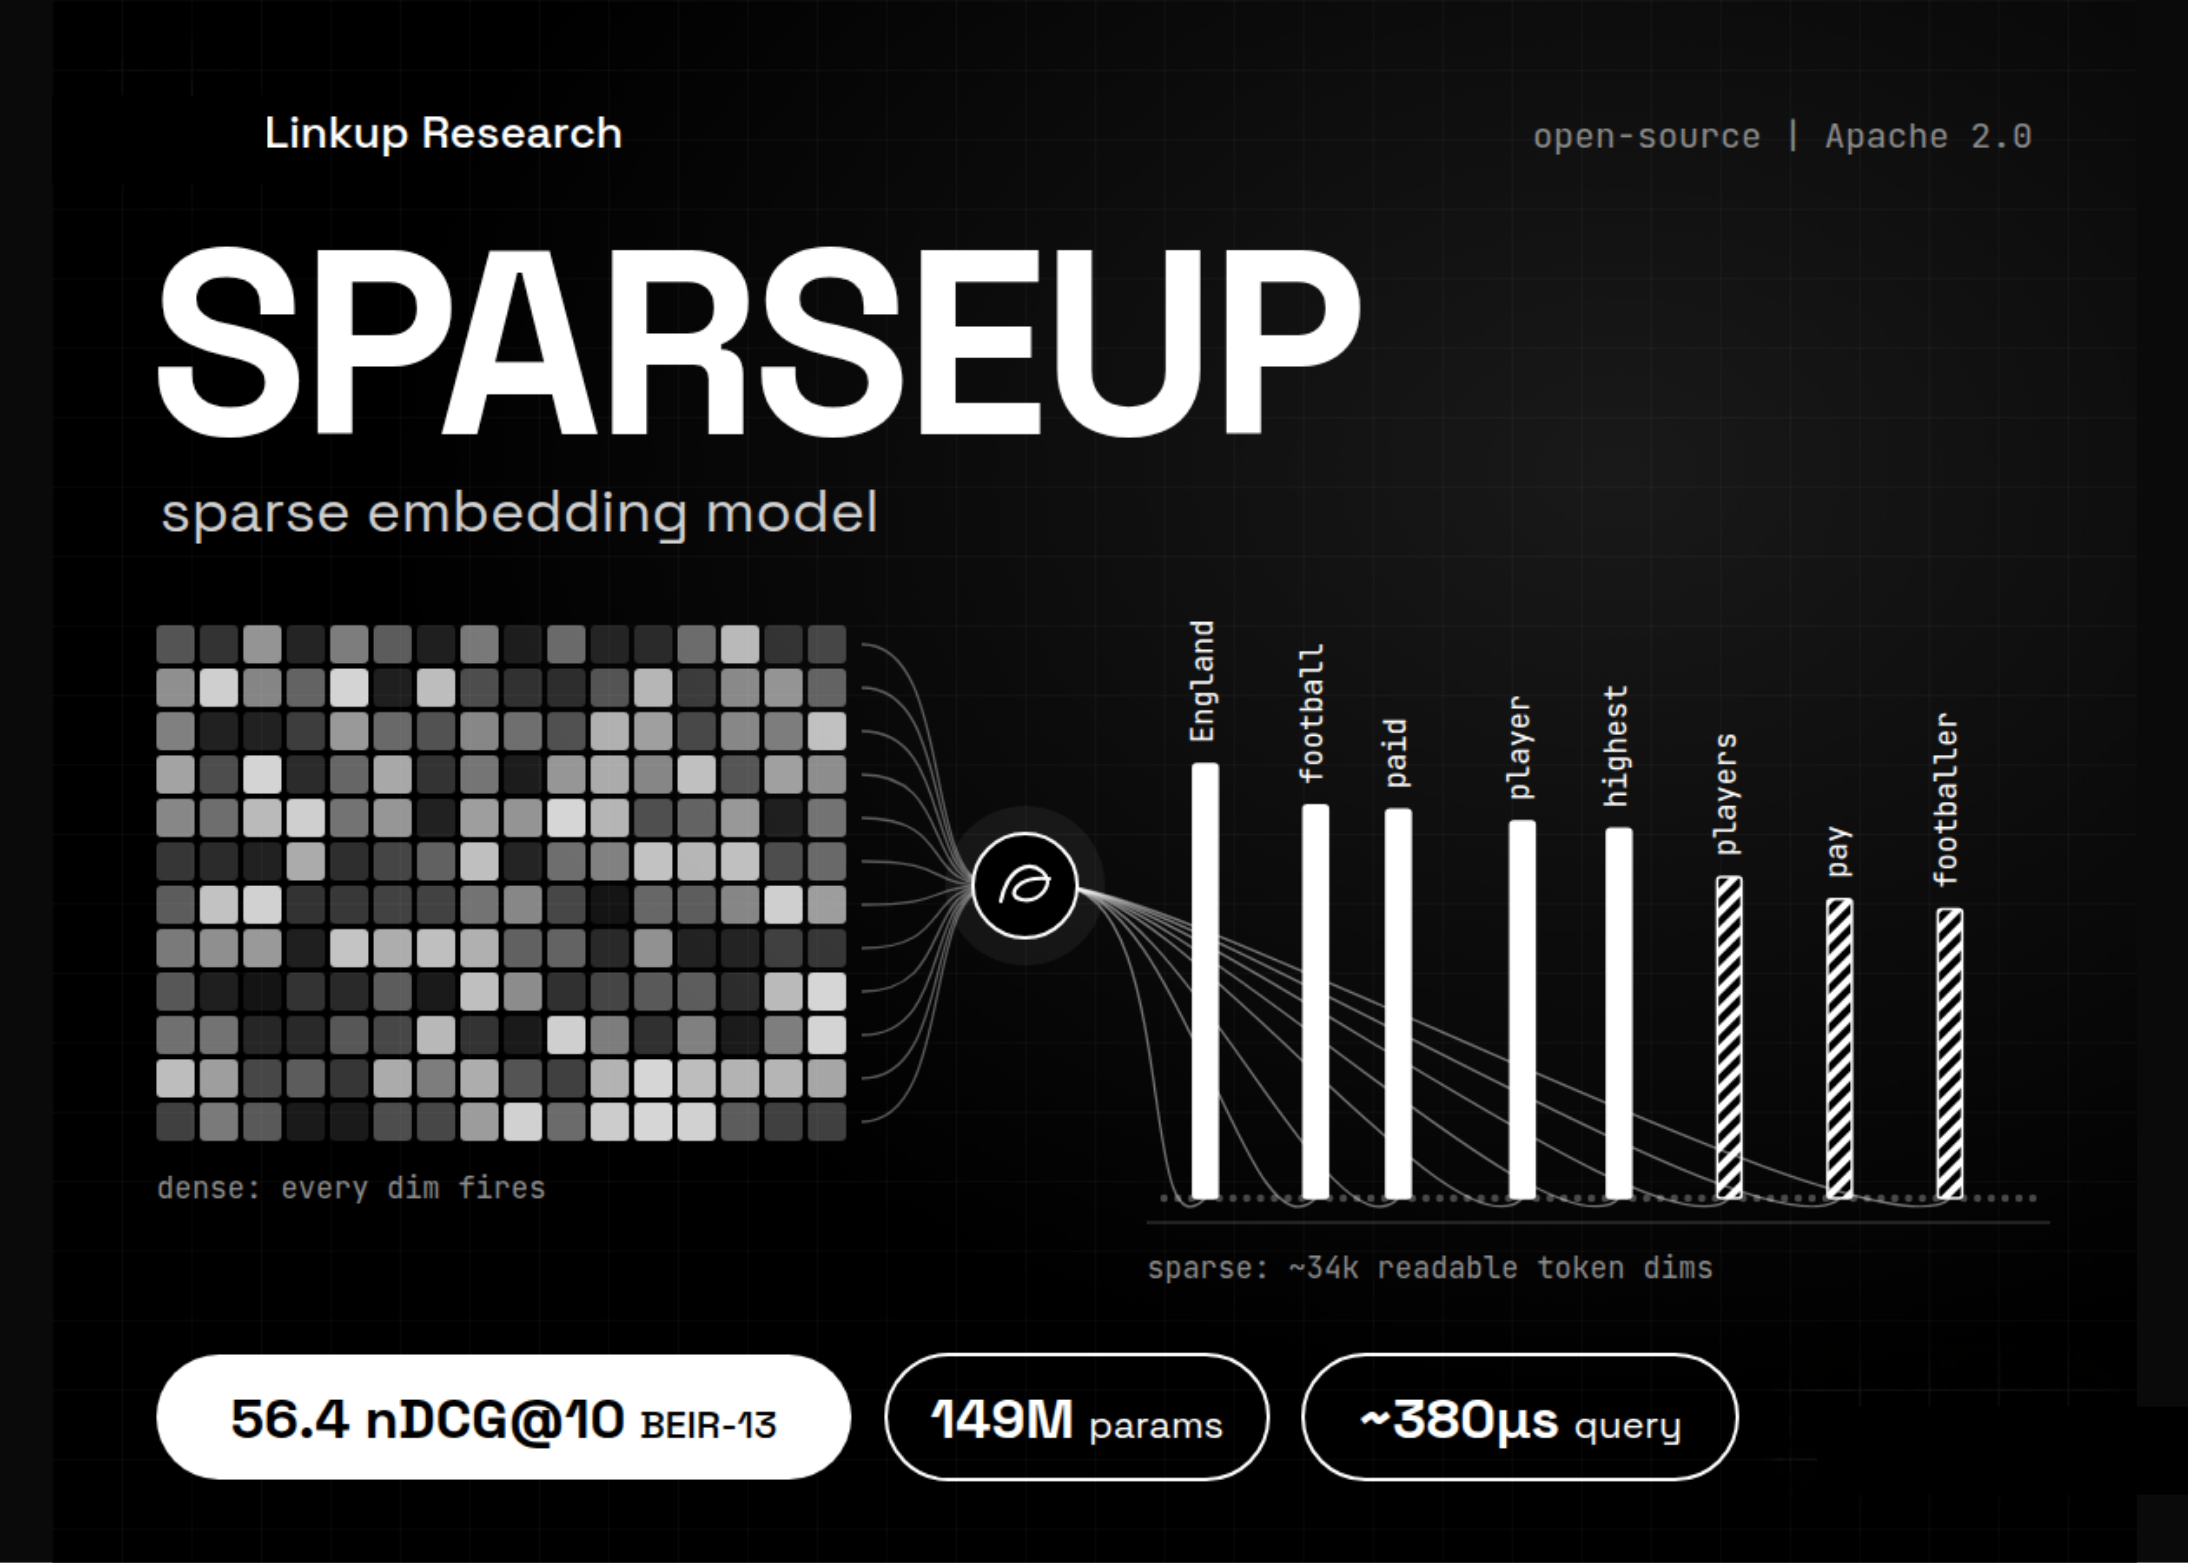
Segun MarkTechPost (AI/ML News), el equipo de investigación de Linkup ha lanzado SPARSEUP, un modelo de embeddings esparsos abierto y diseñado para mejorar la recuperación de información en sistemas de búsqueda. Este modelo se basa en un núcleo de ModernBERT con 149 millones de parámetros y opera bajo la licencia Apache 2.0, garantizando su disponibilidad para uso académico y comercial. Los resultados obtenidos en el conjunto de datos BEIR-13 muestran un promedio de 56.4 en nDCG@10, posicionándolo como el más potente modelo basado en vocabulario esparsos con menos de 150 millones de parámetros. Los pesos del modelo están disponibles en Hugging Face y pueden cargarse mediante herramientas como Transformers o Sentence Transformers, utilizando la opción trust_remote_code=True.
La innovación de SPARSEUP radica en su estructura esparsa, que contrasta con los modelos densos tradicionales, donde cada texto se representa mediante un único vector. En cambio, SPARSEUP asigna dimensiones a tokens reales del vocabulario, permitiendo que los resultados se alineen con índices invertidos y sean más comprensibles para humanos. Esta característica también mejora la detección de palabras raras, un aspecto crítico en aplicaciones donde la precisión en temas específicos es clave. El impulso para este desarrollo se dio con la publicación de LightOn, que abrió datos de entrenamiento, una receta de entrenamiento y modelos densos y de interacción tardía. SPARSEUP completa la línea de modelos disponibles, permitiendo comparar directamente tres estilos de recuperación: densos, esparsos y de interacción tardía, todos basados en el mismo núcleo.
El entrenamiento se inició desde un punto previo de LightOn sin cabeza de máscara (MLM), donde se reintrodujo la capa original de ModernBERT. El proceso de afinamiento utilizó una mezcla de datos de LightOn y aprendizaje por contraste, con la selección de 7 negativos duros por consulta, extraídos de una base de 50 opciones y aplicados dentro del lote. No se implementó distilación con decodificadores cruzados, y el proceso completo se ejecutó en una sola unidad H100. Un experimento preliminar con una versión estándar de SPLADE generó conjuntos de datos saturados por paradas de significado, lo que llevó a tres correcciones clave: el desplazamiento de logits mediante la función log(1 + ReLU(x - 15)), que evita la saturación en el inicio del entrenamiento; y el uso de top-k por posición, donde cada token conserva solo sus 12 dimensiones más fuertes antes de la operación de max pooling, lo que limita el crecimiento excesivo de dimensiones.
Para el lector peruano, este avance en inteligencia artificial tiene implicaciones directas en la eficiencia de los sistemas de búsqueda en plataformas locales, como los motores de búsqueda de servicios públicos o herramientas de soporte administrativo. Al mejorar la precisión en la recuperación de información, SPARSEUP puede optimizar el tiempo de respuesta en entornos donde la calidad del contenido es esencial, como en la gestión de información gubernamental o en servicios de salud. Aunque el modelo aún requiere adaptación a contextos específicos, su disponibilidad abierta y su rendimiento promedio en pruebas internacionales lo posicionan como una pieza clave en el futuro de la inteligencia de búsqueda accesible.