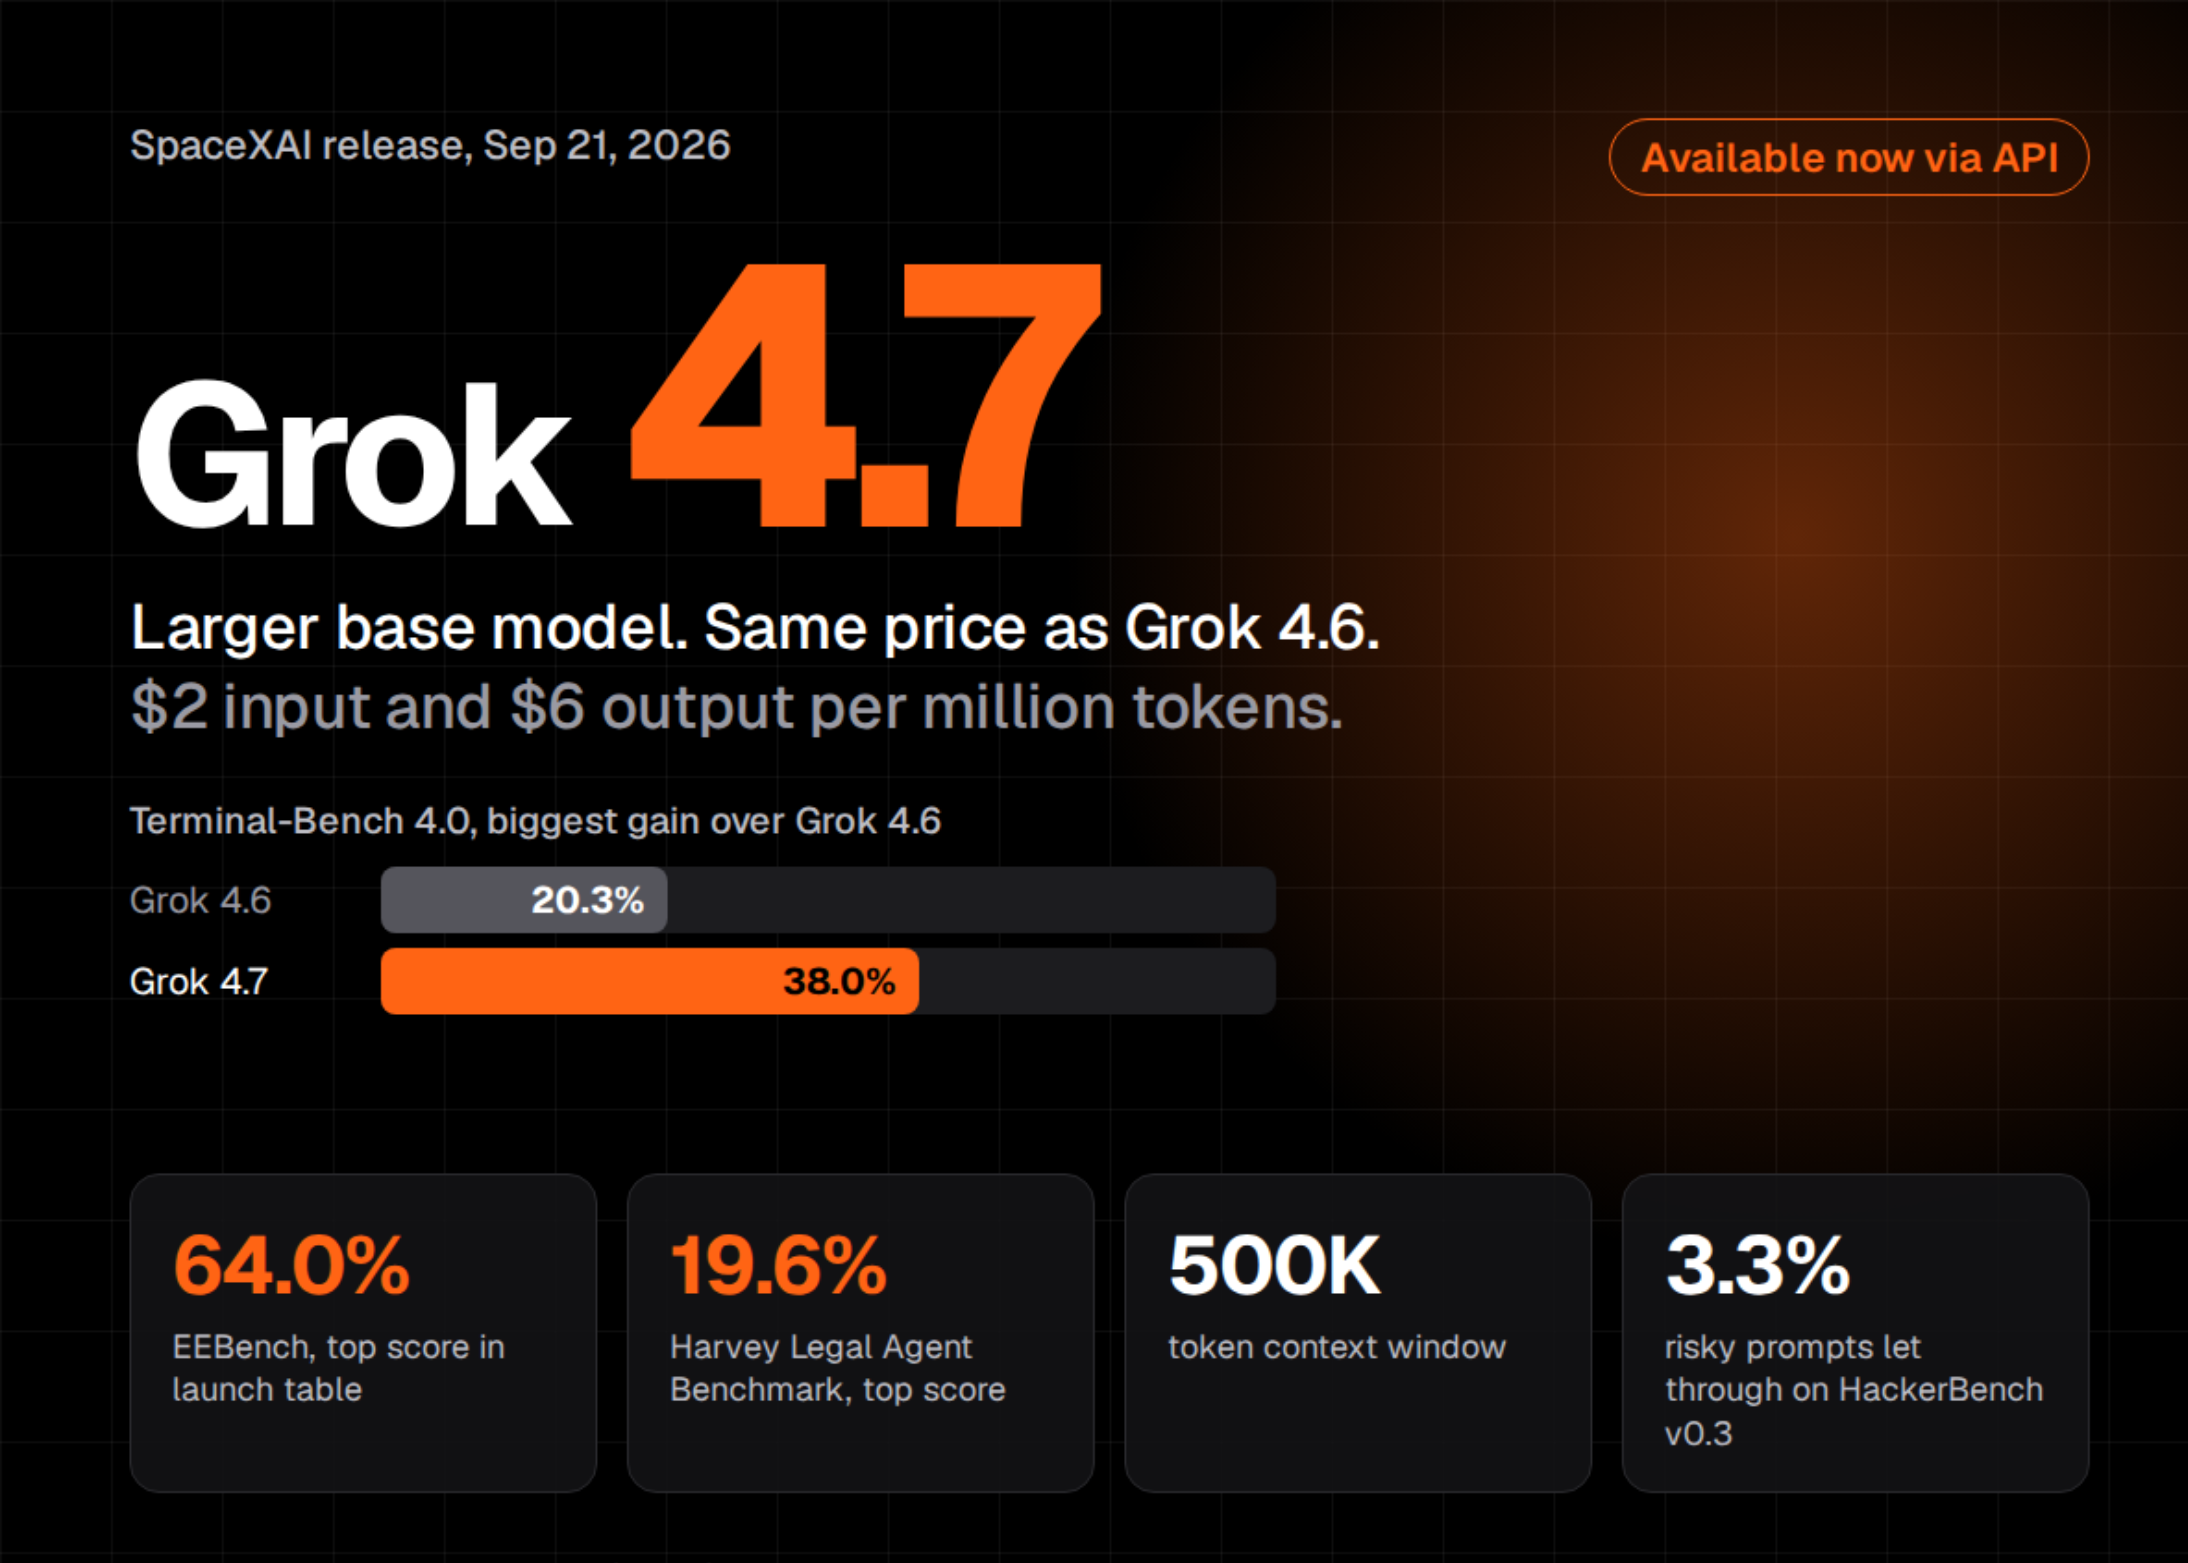
Según MarkTechPost (AI/ML News), SpaceXAI ha presentado Grok 4.7, una versión actualizada de su modelo de inteligencia artificial diseñada para tareas técnicas, desarrollo de código y trabajo de conocimiento. Esta nueva iteración se basa en un modelo base más amplio y ha sido entrenada con una secuencia de aprendizaje por reforzamiento más extensa, enfocada en desafíos complejos que requieren horas de procesamiento. A pesar de estas mejoras internas, el modelo mantiene el mismo precio y velocidad que su predecesor, Grok 4.6, ofreciendo una solución accesible para desarrolladores y profesionales que requieren herramientas de inteligencia artificial en tiempo real.
El avance técnico se manifiesta en cuatro dimensiones clave: el modelo base ha sido completamente reemplazado por uno más grande; el entrenamiento se ha profundizado en tareas de larga duración, lo que mejora su capacidad para resolver problemas complejos; el sistema incluye mecanismos de autoverificación que permiten revisar sus propias respuestas; además, ha sido optimizado para interactuar con el entorno de bot de Grok, facilitando su uso en conversaciones y tareas de consulta. Actualmente, el modelo está disponible como servicio a través de APIs de plataformas como xAI, Cursor, Grok Build, OpenRouter, Vercel y Cloudflare.
Los resultados de pruebas muestran un crecimiento significativo en desempeño. En el test Terminal-Bench 4.0, Grok 4.7 aumenta su puntuación de 20.3% a 38.0%, mientras que en EEBench alcanza 64.0%, lo que representa un salto de 11 puntos y posiciona al modelo como líder en este indicador. En el desafío de asesoría legal, obtiene un 19.6% frente a 6.7% del modelo Fable 5.1 Max. Sin embargo, no domina todos los escenarios: Fable 5.1 Max supera a Grok 4.7 en cuatro de siete pruebas, incluyendo un puntaje de 57.9% en Terminal-Bench. El modelo GPT-5.6 Sol Max mantiene el mejor resultado en DeepSWE v1.1, con 72.7%. En cuanto al costo, Fable 5.1 Max exige cinco veces más por entrada y casi ocho veces más por salida, mientras que GPT-5.6 Sol Max requiere doble costo de entrada y tres veces más de salida. Grok 4.7 se posiciona en el límite de eficiencia precio-rendimiento en el test CursorBench 4.0, y logra una destacada puntuación en el test GDPval, que evalúa competencias en trabajo profesional.
Para los lectores peruanos, este desarrollo representa una oportunidad clave en el acceso a tecnologías de inteligencia artificial. En un contexto donde muchas empresas aún enfrentan barreras para adoptar herramientas digitales avanzadas, Grok 4.7 ofrece una alternativa de bajo costo y alto rendimiento, especialmente útil para emprendedores, profesionales del sector tecnológico y estudiantes que buscan mejorar su productividad. Aunque no es el mejor en todos los aspectos técnicos, su disponibilidad a precios accesibles y su capacidad para automatizar tareas de desarrollo y conocimiento lo convierten en una opción viable para la innovación local, especialmente en sectores como la tecnología, la administración y el comercio digital.