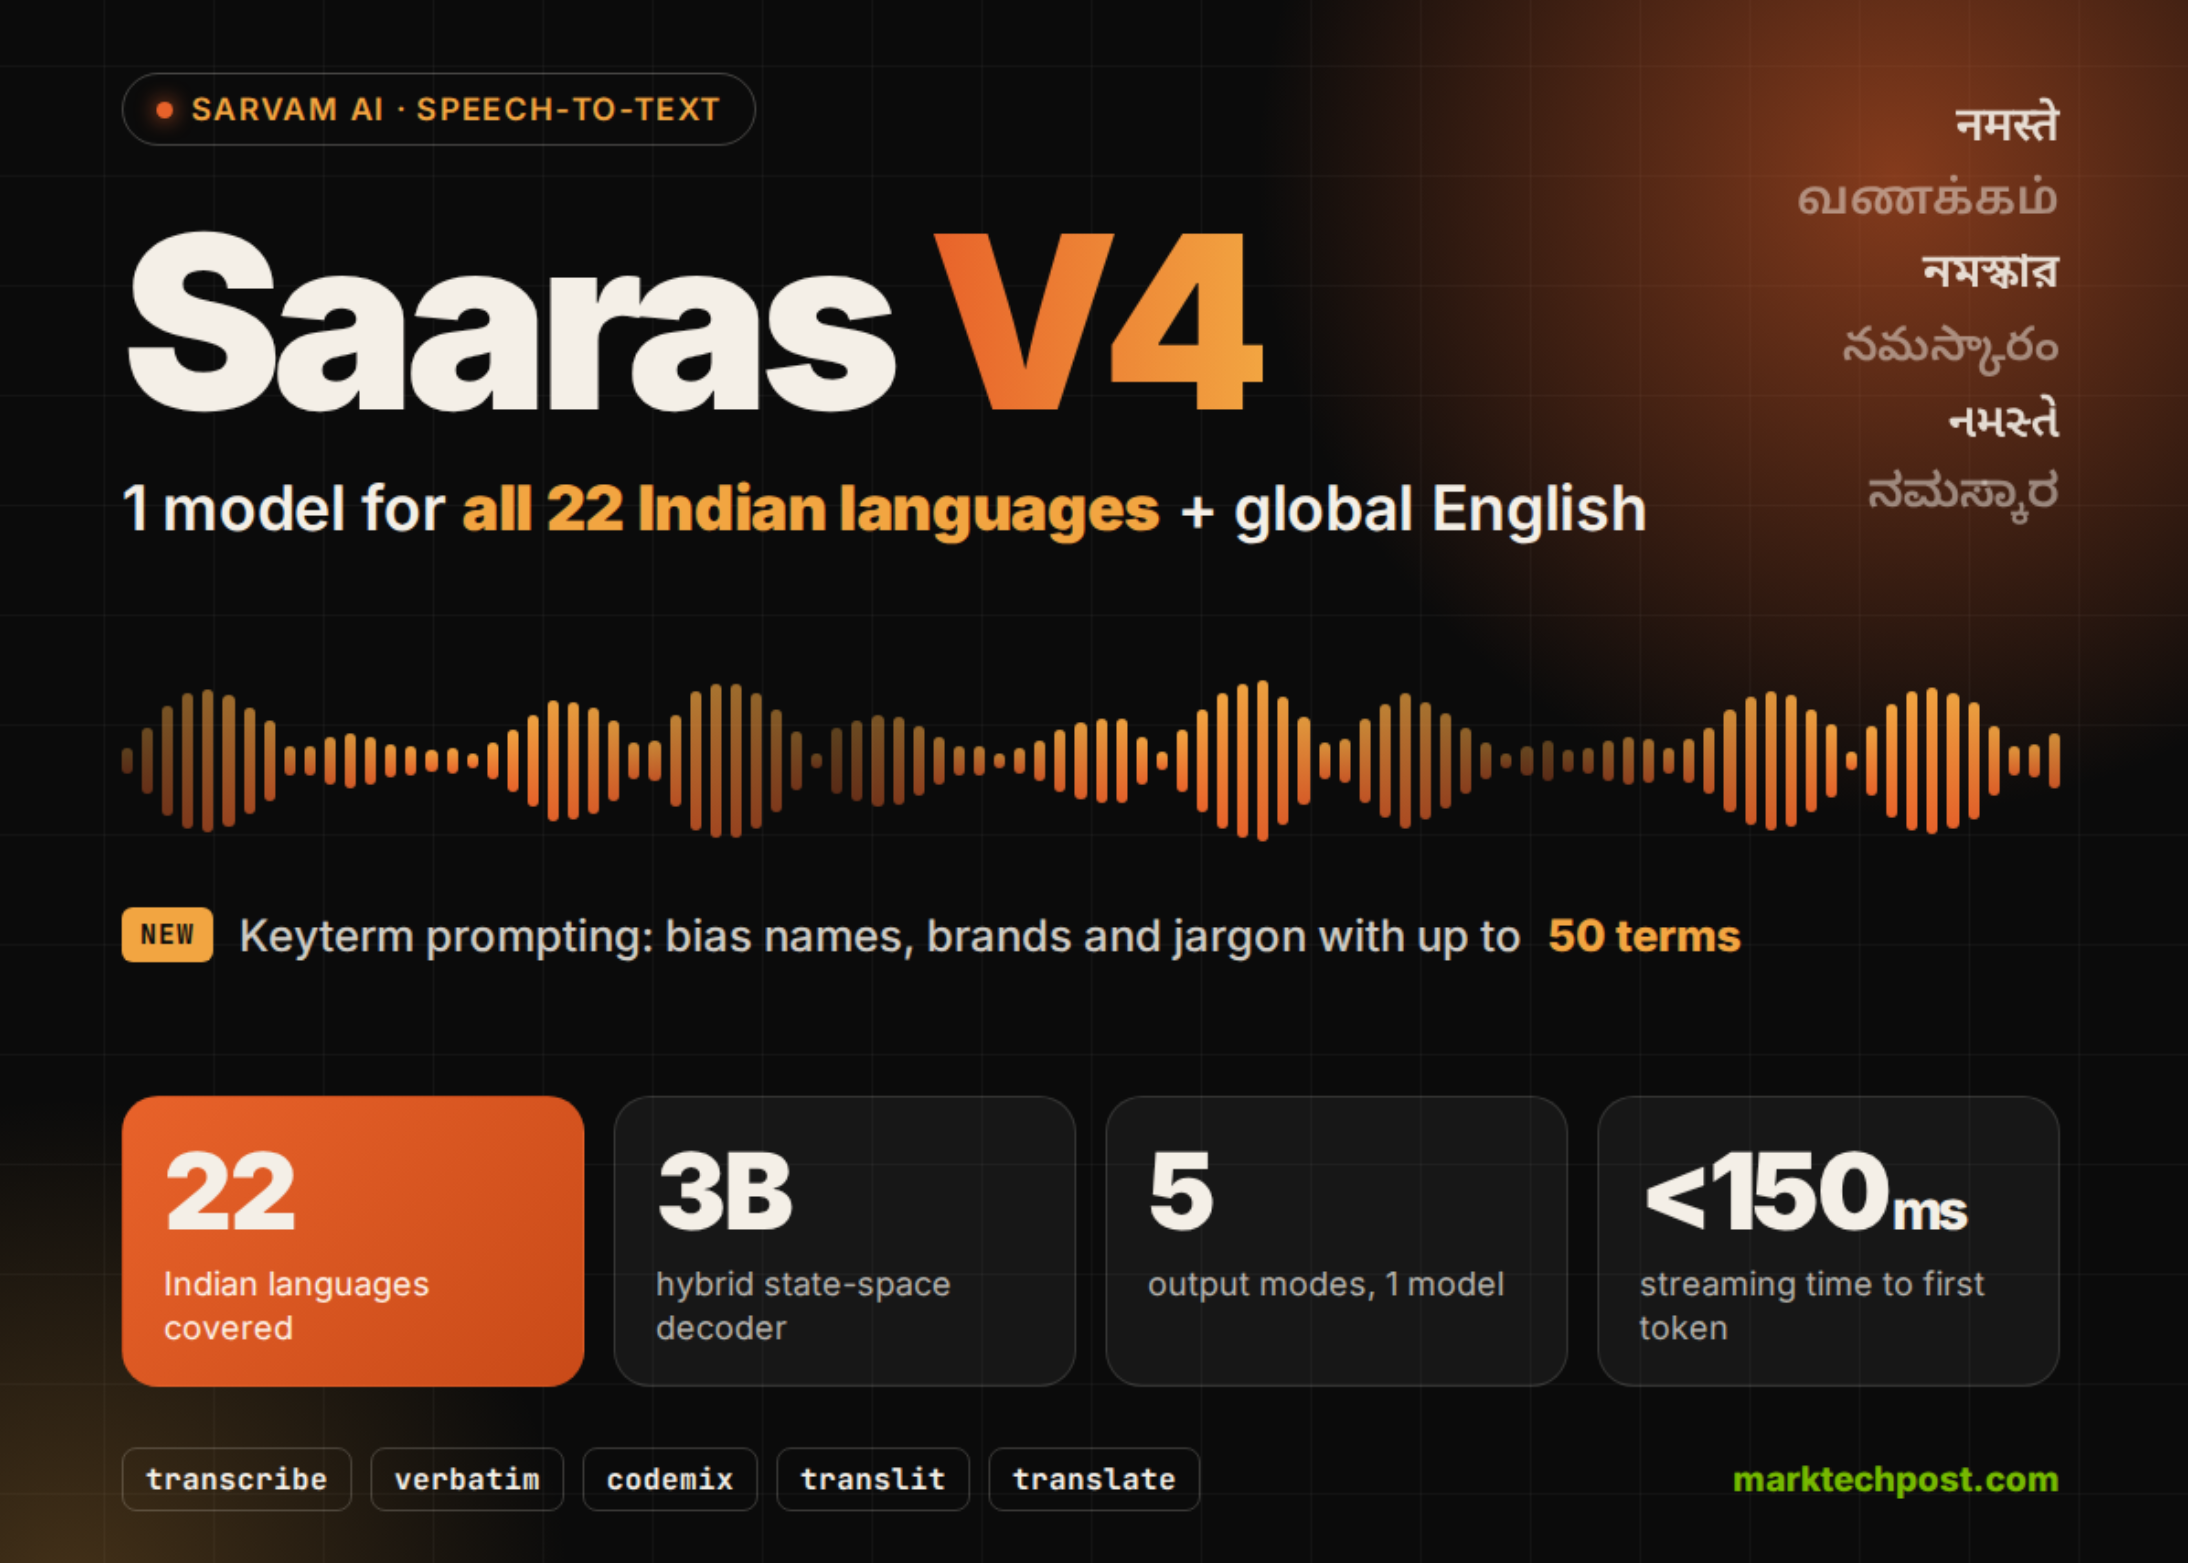
Según MarkTechPost (AI/ML News), Sarvam AI ha lanzado Saaras V4, una versión actualizada de su modelo de reconocimiento de voz que abarca todos los 22 idiomas oficiales de India junto con el inglés global, incluyendo acentos internacionales. Este avance tecnológico logra una precisión de punta en cada uno de los idiomas, según pruebas internas. El modelo está disponible inmediatamente a través de la API de Sarvam, bajo la configuración "model=saaras:v4", aunque los pesos del modelo no se han compartido públicamente. Documentación técnica actualmente solo cubre la versión anterior, Saaras v3, en entornos de autogestión mediante SageMaker.
El diseño técnico de Saaras V4 se basa en un sistema codificador-decodificador. El proceso comienza con un codificador acústico que transforma la señal de audio en representaciones numéricas que conservan detalles fonéticos y acústicos. Posteriormente, un adaptador que reduce la longitud temporal de la secuencia proyecta los datos hacia el espacio de embeddings del modelo principal. Esta estrategia permite manejar grabaciones largas sin exceder el límite de contexto del sistema. El decodificador en cuestión es Sarvam-3B, un modelo de lenguaje híbrido basado en espacio de estados con 3 mil millones de parámetros, entrenado desde cero en sus propios servidores. Este componente analiza tanto los datos acústicos como una instrucción textual, generando una transcripción de forma autoregresiva, donde cada palabra se vuelve entrada para la siguiente generación.
En pruebas específicas, Saaras V4 alcanza el mejor promedio de error de reconocimiento (WER) entre los modelos evaluados por Sarvam. Los datos se obtuvieron de siete conjuntos distintos: seis provenientes del leaderboard de Hugging Face (AMI, GigaSpeech, LibriSpeech clean, LibriSpeech other, SPGISpeech y VoxPopuli), y uno específico de acentos indios del proyecto AI4Bharat (Svarah). La calibración se realiza mediante el código normalizador del leaderboard. En idiomas indios, se midieron resultados en 10 lenguas utilizando tanto WER como LLM-WER, un indicador que evalúa no solo errores ortográficos sino también la coherencia semántica. Este enfoque permite detectar discrepancias en significado, algo crítico en escrituras como el Devanagari o el Bengali. Además, en escenarios de audio ruidoso —como grabaciones comprimidas, con clip o con fondo fuerte—, el error de Saaras V4 es inferior al 50% del de Deepgram Nova-3 y GPT-4o Transcribe, demostrando robustez frente a condiciones reales.
Para los lectores peruanos, este avance es relevante no solo por su aplicación en tecnologías de comunicación, sino por la posibilidad de integrar modelos que comprenden idiomas locales con alta precisión. En un contexto donde el uso de lenguas indígenas o dialectos regionales en sistemas digitales sigue siendo limitado, herramientas como Saaras V4 abren puertas a inclusión tecnológica más equitativa. Aunque el modelo aún no está disponible para usuarios del extranjero, su diseño podría inspirar desarrollos similares en América Latina, especialmente en países donde la diversidad lingüística es amplia.