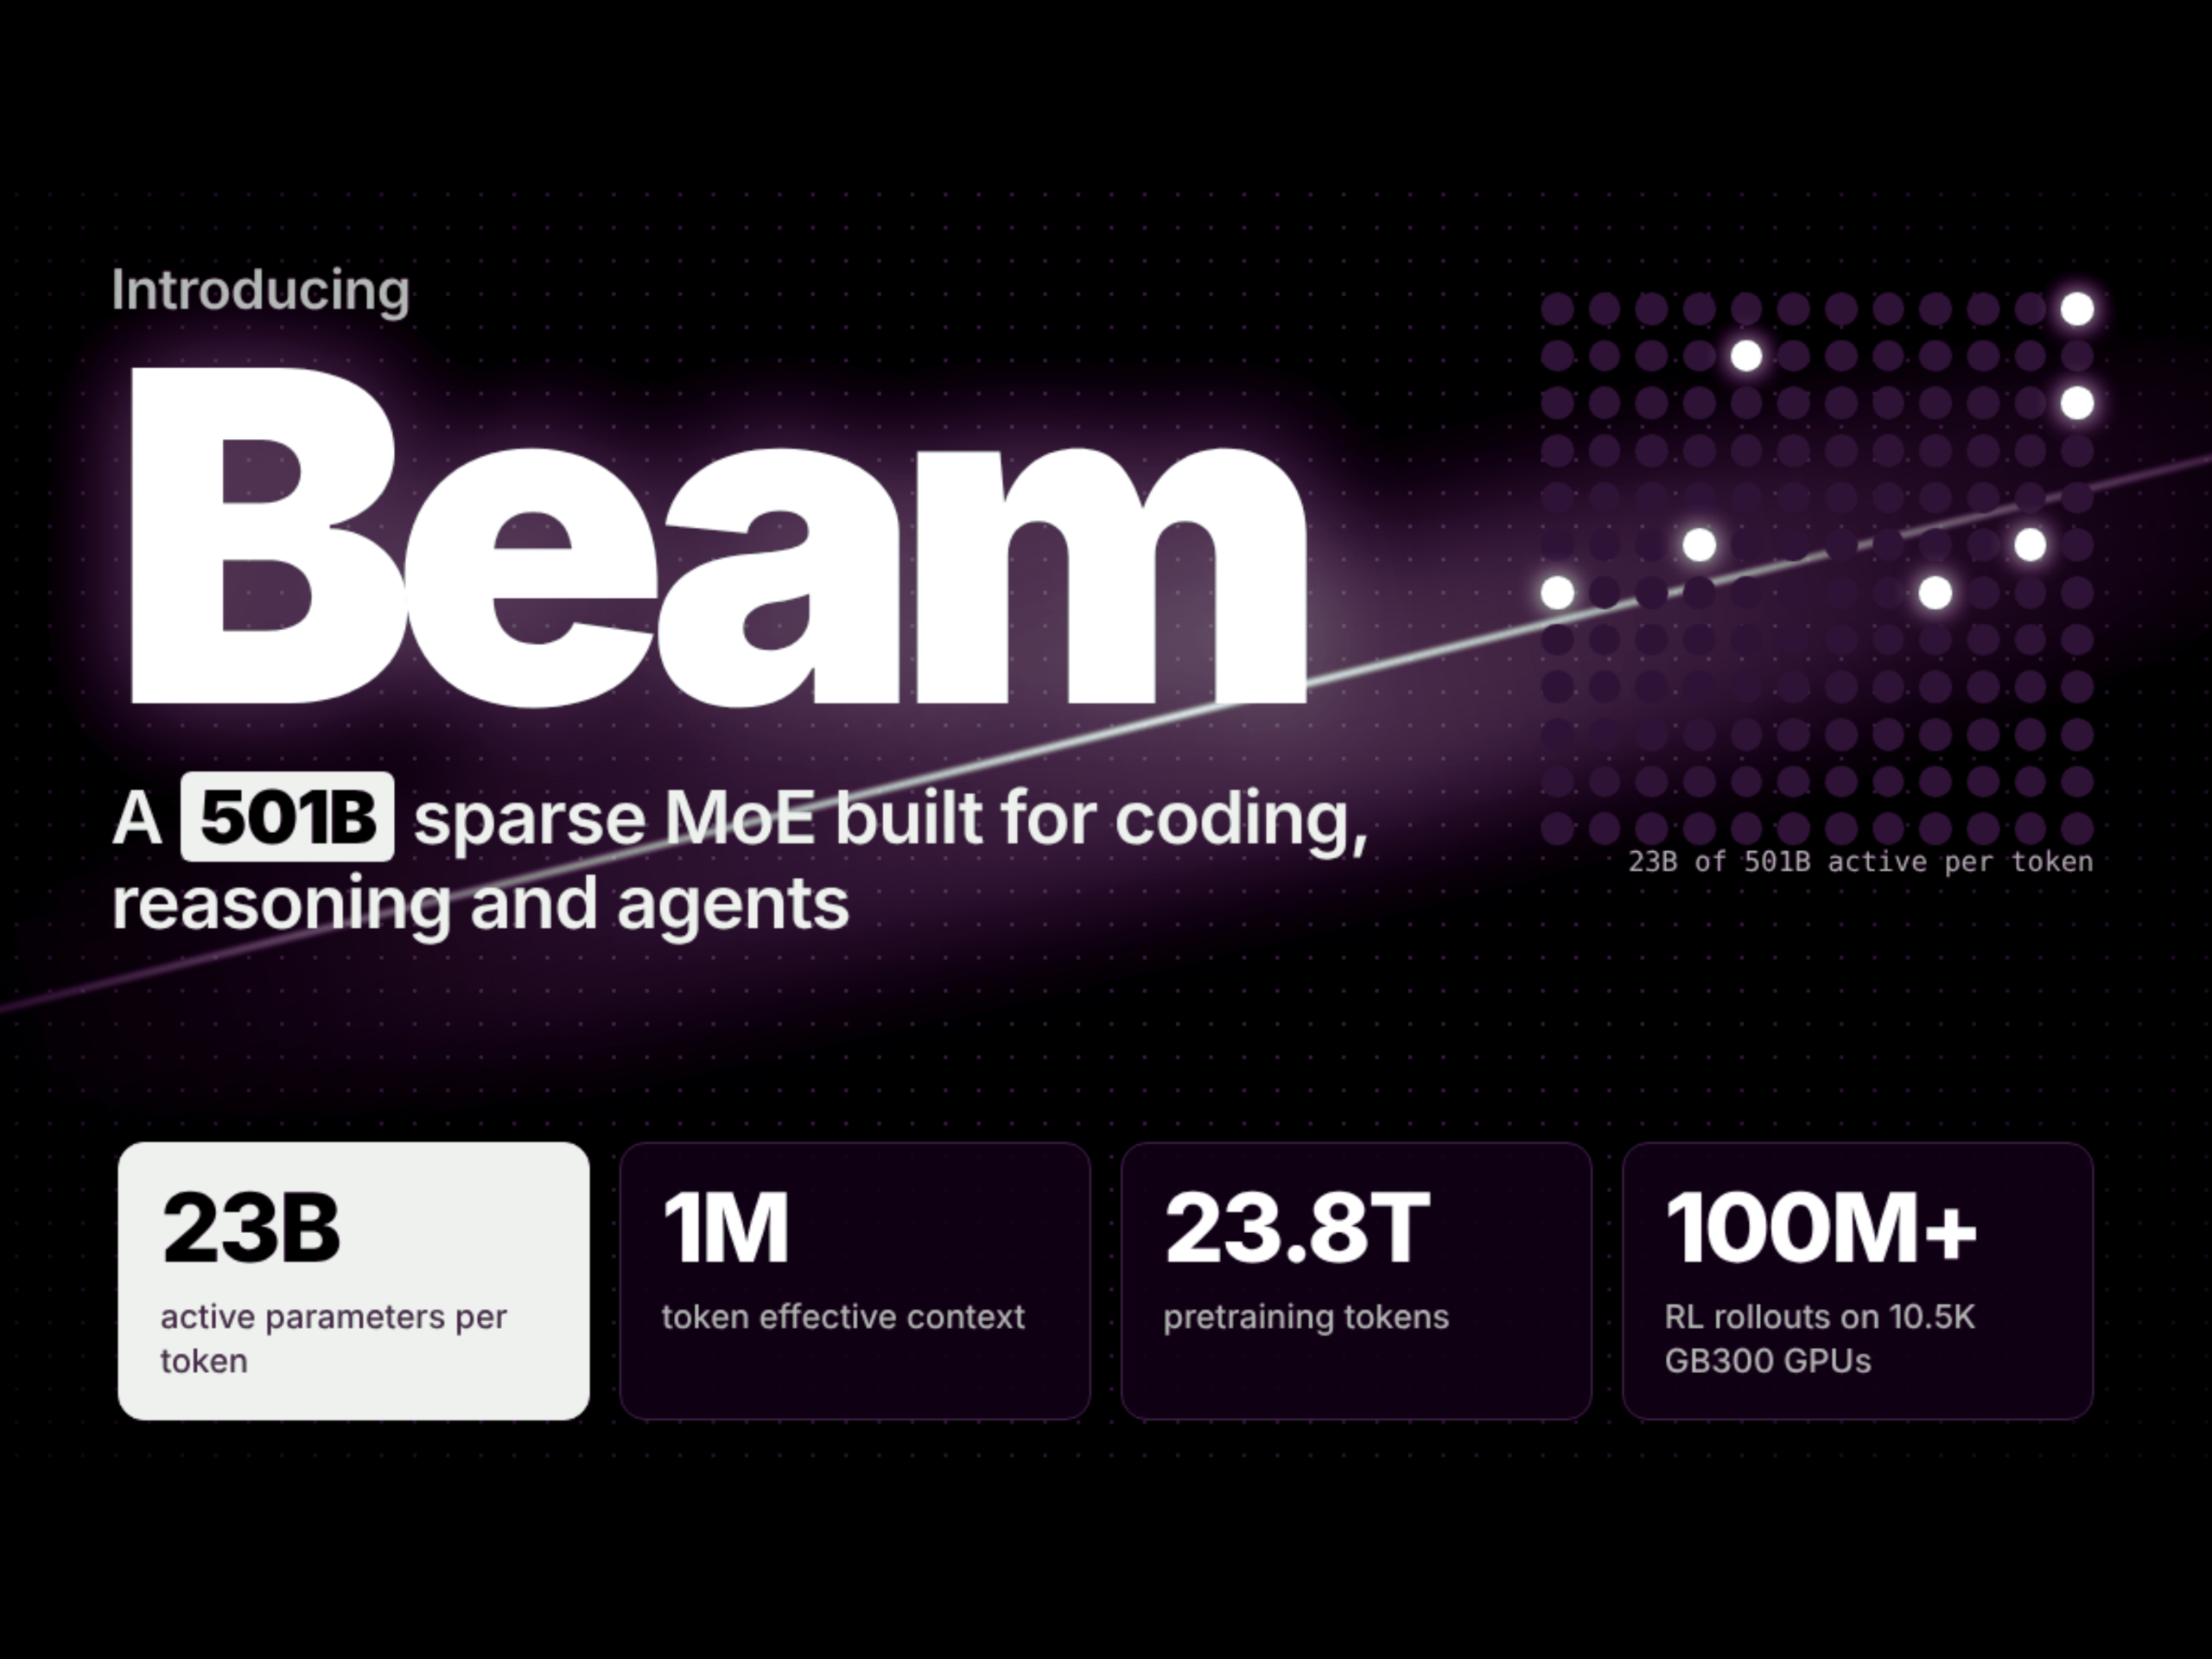
Segun MarkTechPost (AI/ML News), Reflection AI ha lanzado Beam, su primer modelo abierto de peso completo, diseñado específicamente para tareas de codificación, razonamiento y operaciones agentes. Este sistema se basa en una arquitectura de mezcla de expertos (MoE) con 501 billones de parámetros totales, de los cuales 23 billones se activan por token. La eficiencia del modelo se destaca en su capacidad de operar con hasta un 3 a 4 veces menos de consumo de computación en pruebas de razonamiento comparadas con grandes modelos abiertos como GLM 5.2. Aunque ya está en fase final de pruebas de seguridad y robustez, aún no se puede implementar en entornos de auto-hospedaje. Los usuarios interesados pueden acceder a una versión preliminar a través de una lista de espera en la plataforma de Reflection.
El modelo fue entrenado desde cero y se enfoca en entornos empresariales donde se requieren aplicaciones dinámicas y autónomas. Reflection posiciona Beam como un avance significativo en el panorama de modelos abiertos en el mundo occidental. Aunque en capacidades brutas, como las demostradas por Kimi K3, aún no supera a los competidores, su ventaja radica en el rendimiento energético y en el tiempo de respuesta durante las operaciones de razonamiento. Los usuarios pueden ajustar un parámetro de esfuerzo cognitivo que controla el nivel de profundidad en las respuestas. Configuraciones bajas generan respuestas rápidas y concisas, ideales para tareas simples, mientras que ajustes elevados permiten profundidades mayores en desafíos complejos, adaptándose al presupuesto de recursos disponibles.
El entrenamiento de Beam se realizó sobre 23.8 billones de tokens extraídos de fuentes web, publicas y conjuntos de datos licenciados. El equipo de investigación afirmó que el proceso de selección eliminó aproximadamente el 95% de los tokens inútiles del internet bruto, conservando alrededor de 1.8 billones de tokens de alta calidad que normalmente serían descartados por filtros estándar. La arquitectura integra atención local y global, junto con expertos de ruta finamente calibrados. Se incorporó una técnica de equilibrio de carga inspirada en DeepSeek-V3, pero con una variación de decaimiento coseno en las actualizaciones de sesgo de expertos. Al final del entrenamiento, el experto más solicitado alcanzó solo un 1.04 veces la carga promedio. A través de escalado por profundidad, uso de SandwichNorm y puertas de atención, los valores de norma residual se mantuvieron dentro de límites establecidos en todas las 52 capas. Este proceso concluyó en menos de cuatro semanas utilizando 6.144 GPUs NVIDIA GB30.
Para el lector peruano, esta evolución en modelos de inteligencia artificial ofrece una oportunidad clave para empresas que buscan soluciones escalables y eficientes en desarrollo de software. Aunque los costos de implementación aún son altos, el enfoque de Beam en reducir el uso de recursos computacionales puede ser especialmente relevante para entidades con límites presupuestarios. En un contexto donde la digitalización de procesos es clave, el acceso a modelos abiertos que permiten razonamientos autónomos sin requerir infraestructura extremadamente potente, puede transformar la forma en que se construyen aplicaciones tecnológicas locales. Es un paso importante en la democratización de la inteligencia artificial, aunque aún requiere validación práctica en escenarios reales.