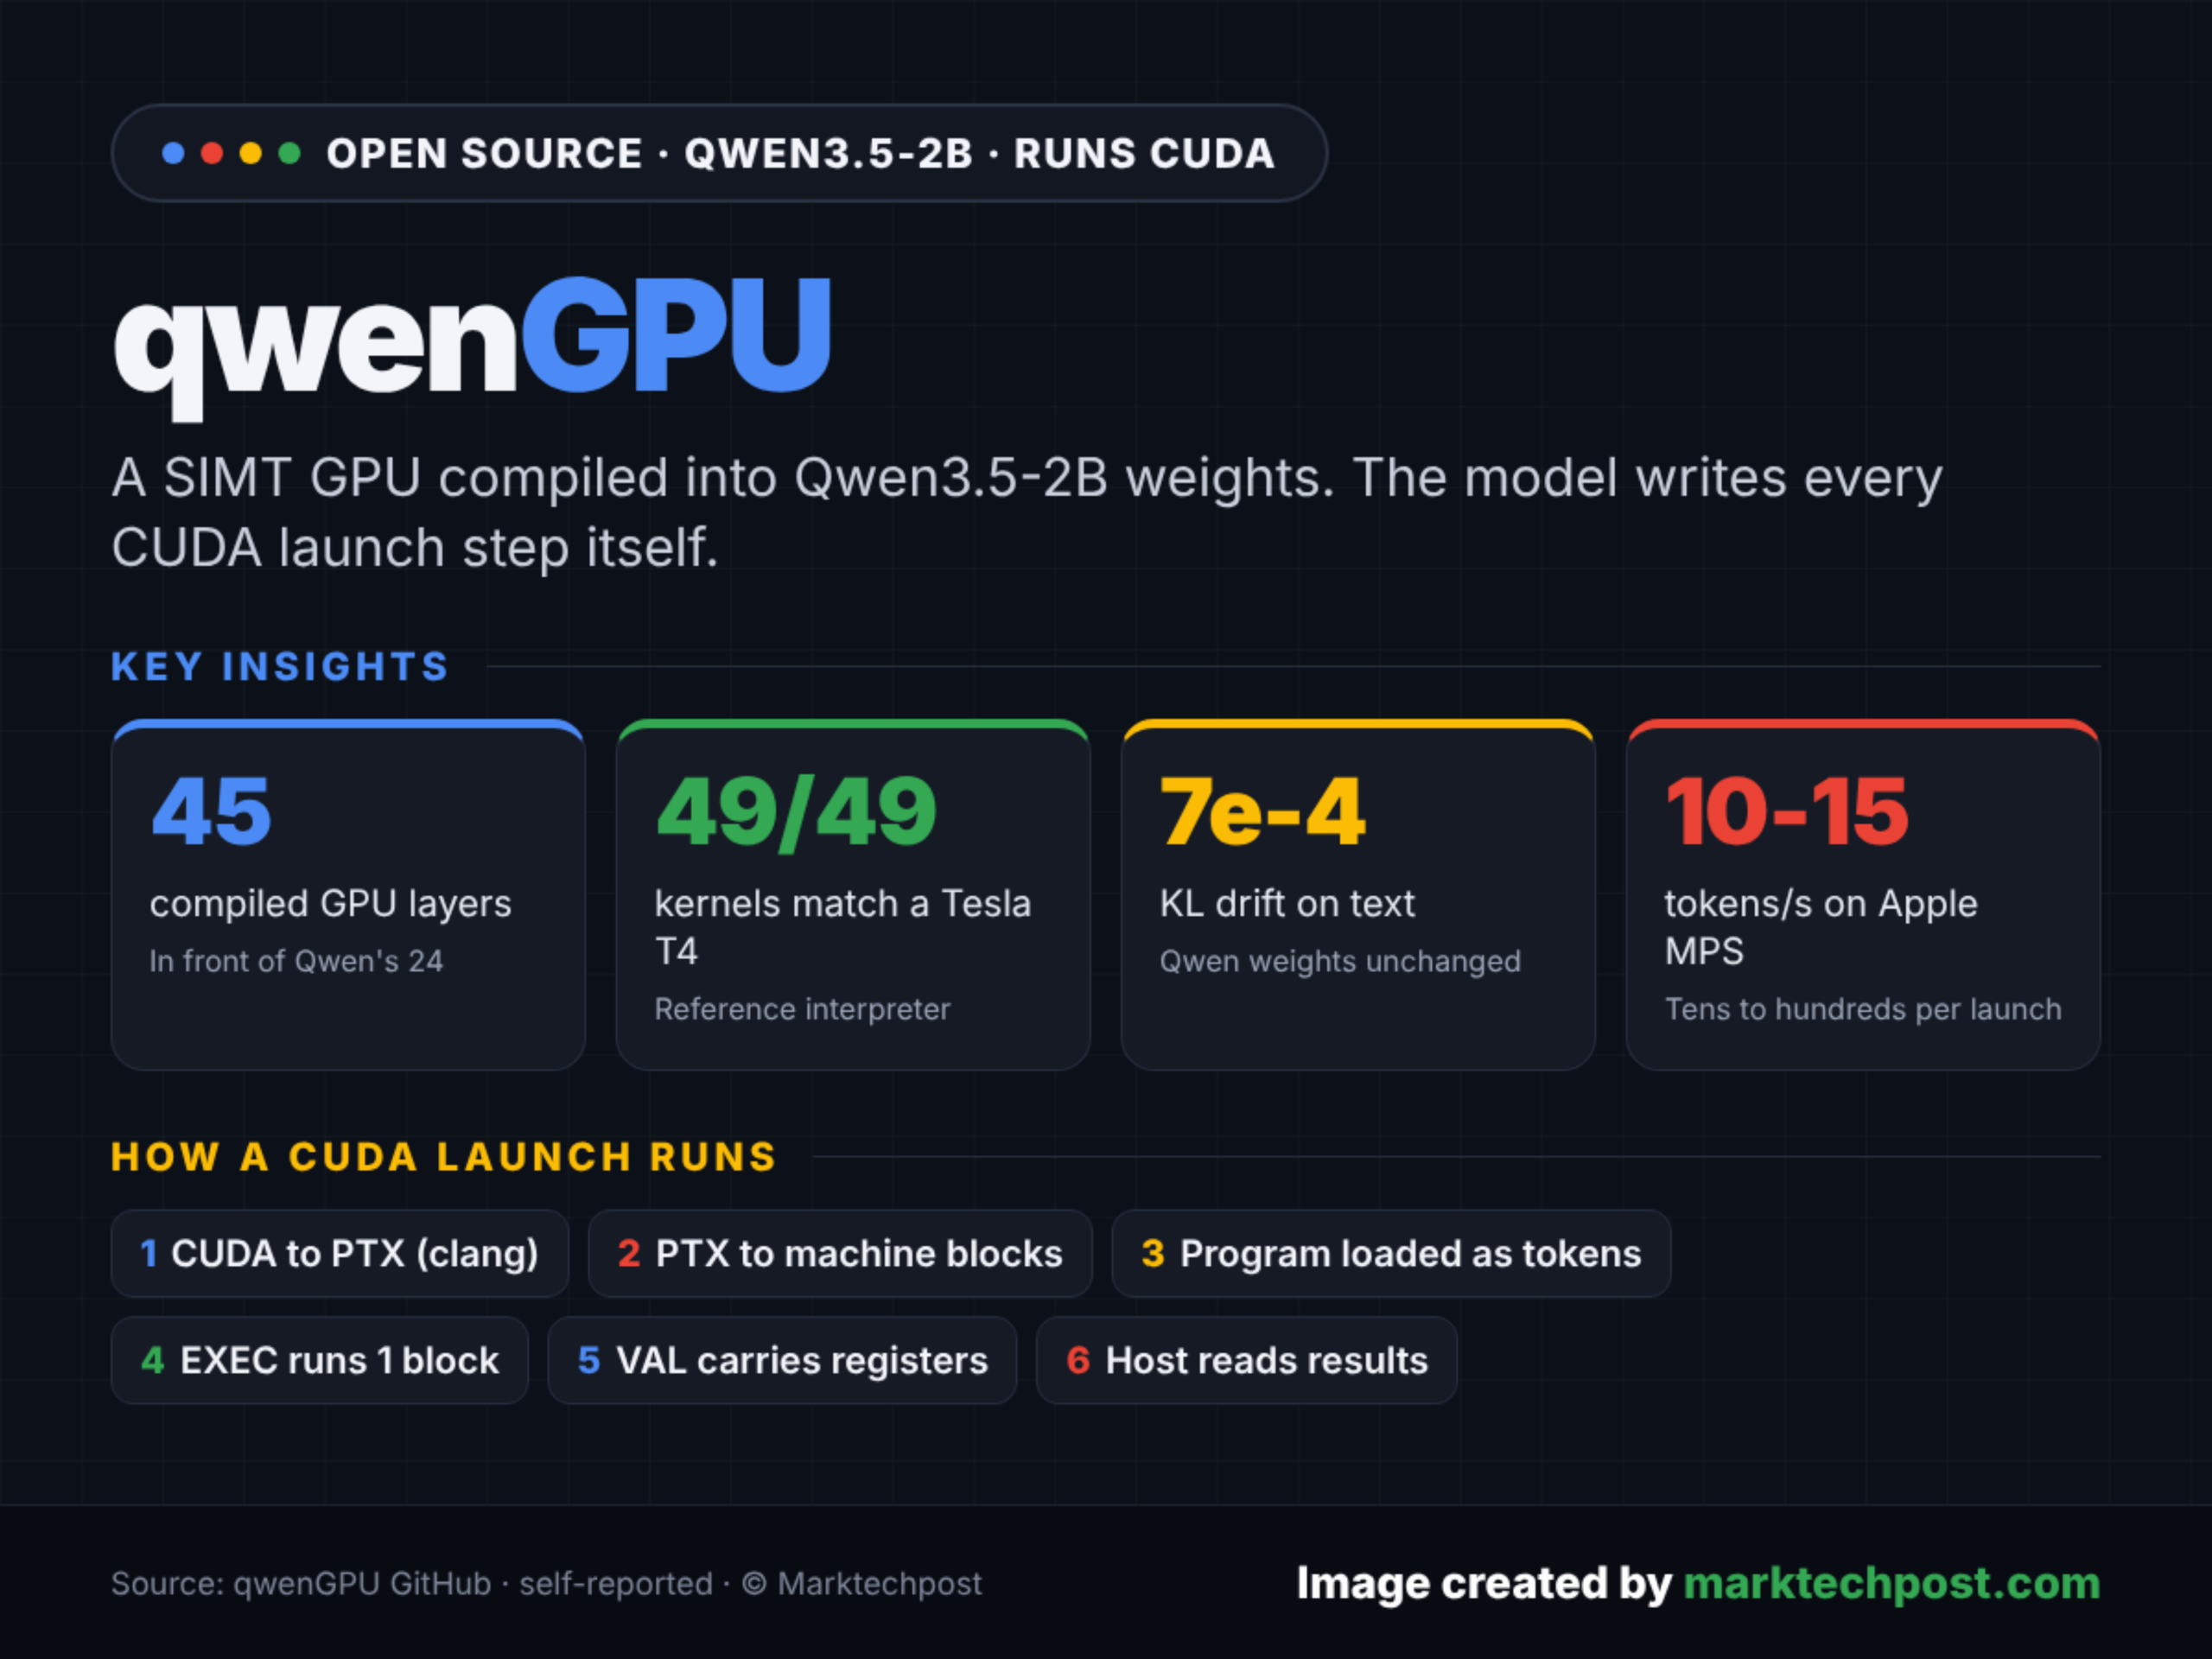
Segun MarkTechPost (AI/ML News), un equipo de desarrollo ha presentado una innovación en inteligencia artificial que redefine cómo se ejecutan las operaciones en modelos preentrenados. La solución, llamada qwenGPU, integra directamente una arquitectura de procesamiento gráfico (GPU) en las capas del modelo Qwen3.5-2B, transformando así el entorno de cálculo dentro de la propia red neuronal. Esta versión experimental fue lanzada por el desarrollador Vixhal en GitHub bajo licencia MIT, permitiendo a los usuarios ejecutar código real de CUDA, compilado al formato PTX de NVIDIA, dentro de los pasos de avance del modelo.
El sistema combina 24 capas originales del modelo Qwen3.5-2B con 45 capas adicionales compiladas, que funcionan como un núcleo de procesamiento paralelo. Estas capas no fueron entrenadas de forma independiente, sino que fueron generadas por un compilador que transforma cada peso en operaciones que replican el comportamiento de un procesador SIMT. El diseño aprovecha estructuras específicas del modelo, como el Gated DeltaNet y los bloques SwiGLU, para simular una unidad de memoria en cada fila. Cada actualización sobre esas filas se realiza con precisión, reemplazando exactamente una fila y leyendo su contenido mediante una consulta de tipo uno-hot, lo que permite que cada fila actúe como una celda de memoria.
El sistema se ejecuta en plataformas que incluyen procesadores de Apple Silicon, GPUs NVIDIA y CPUs, siempre que se disponga de al menos 16 gigabytes de memoria libre. No cuenta con versiones cuantizadas, lo que garantiza una precisión completa en todos los cálculos. En los tests realizados, el despliegue del modelo mostró una divergencia textual mínima de 7×10⁻⁴, indicando que los resultados se mantienen estables frente a la ejecución original. En 49 de 49 kernels, el intérprete de referencia coincidió con el rendimiento de una GPU NVIDIA Tesla T4. Sin embargo, en dispositivos como los de Apple, la velocidad de ejecución se redujo a entre 10 y 15 tokens por segundo, mientras que el código CUDA generado por Qwen superó solo cuatro de cinco pruebas de rendimiento.
Para el lector peruano, esta innovación plantea una vía viable para que desarrolladores locales, especialmente en entornos de educación o startups tecnológicas, puedan experimentar con inteligencias artificiales sin depender de infraestructuras de alto costo. Aunque aún se encuentra en fase experimental, el enfoque de integrar hardware en el software de manera directa podría abrir caminos para soluciones más rápidas, eficientes y accesibles. En un contexto donde el acceso a GPUs potentes sigue siendo limitado, herramientas como qwenGPU podrían democratizar el desarrollo de modelos de IA, permitiendo a equipos más pequeños replicar funcionalidades que antes requerían equipos especializados.