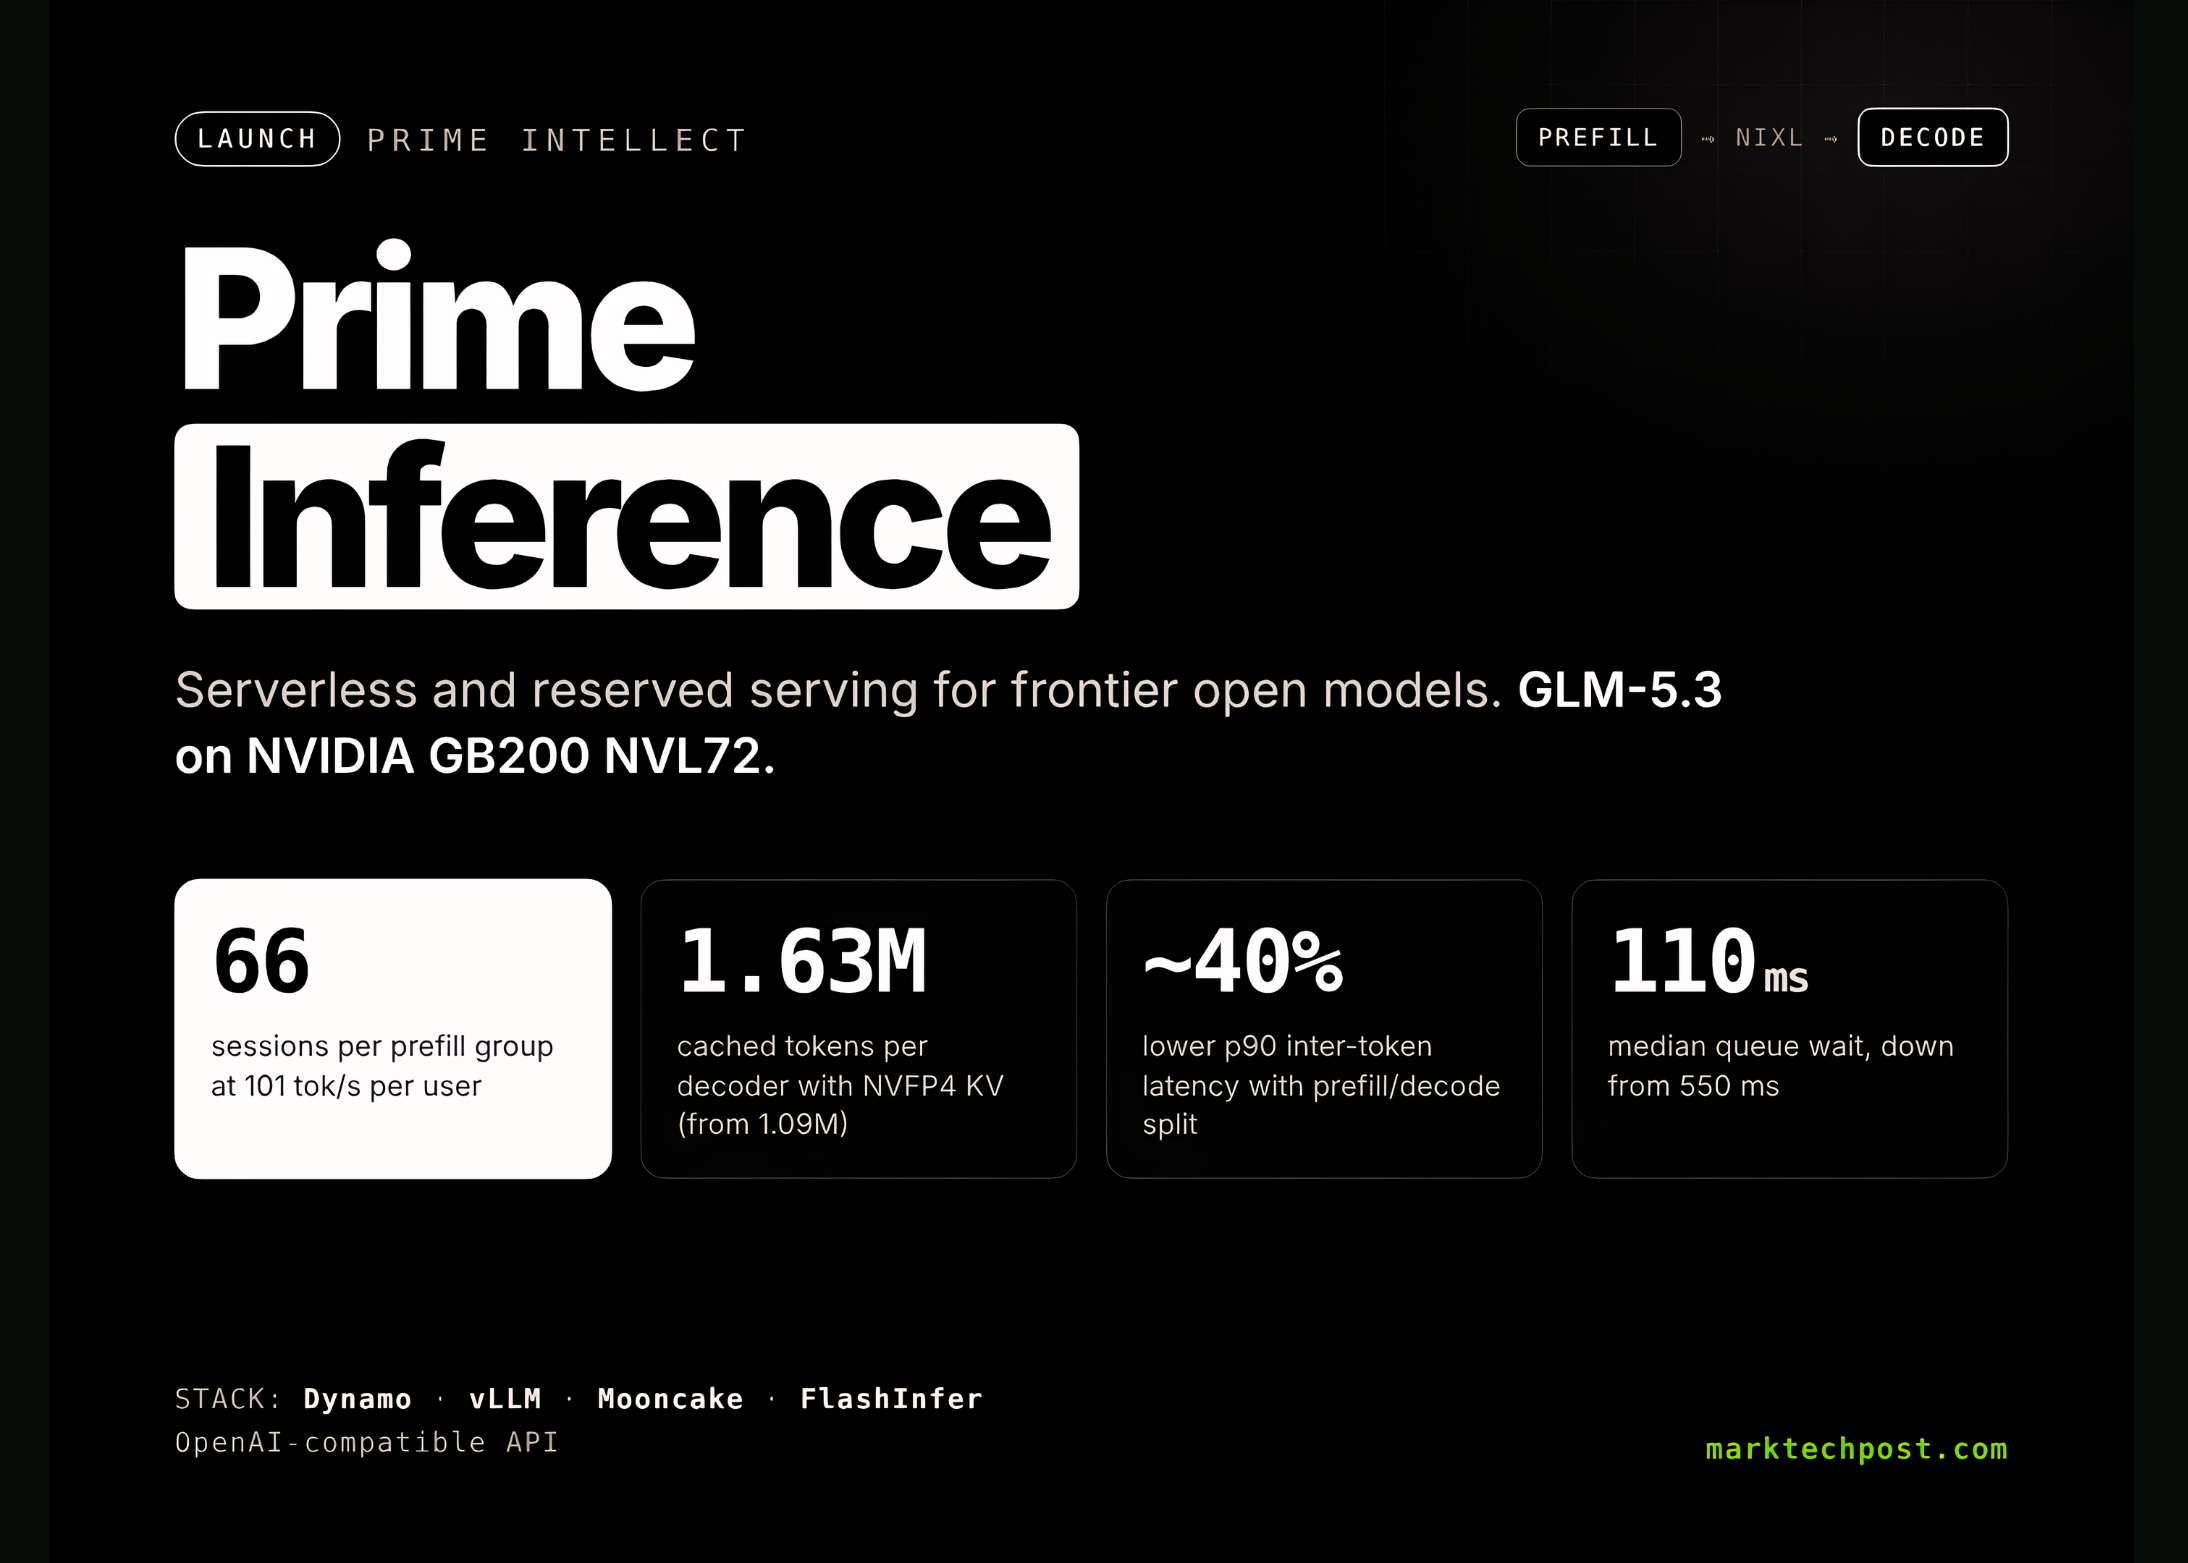
Segun MarkTechPost (AI/ML News), Prime Intellect ha presentado Prime Inference, una solución de servicio diseñada para modelos abiertos de vanguardia. La plataforma permite ejecutar endpoints sin servidor y asignar capacidad reservada en GPUs propias, distribuidas en múltiples centros de datos. Antes de su lanzamiento público, procesó casi un trillón de tokens diarios internamente, generados por pruebas de aprendizaje por refuerzo, creación de datos sintéticos, evaluaciones y agentes de codificación en ejecución continua.
El servicio constituye la capa de ejecución dentro de la pila de entrenamiento abierta de la empresa, complementando herramientas ya disponibles como prime-rl, verificadores y entornos de sandbox. Esta integración permite que modelos desplegados generen registros de producción que, a su vez, alimenten ciclos de entrenamiento, creando un bucle de mejora continua. El punto de conexión GLM-5.3 de Prime Inference se posiciona entre los más rápidos en OpenRouter, con un error de llamada a herramientas casi nulo y una disponibilidad del 100% desde su puesta en marcha.
La plataforma opera en dos modos: endpoints sin servidor para demandas variables y capacidad reservada para trabajos prolongados. Es compatible con la interfaz de OpenAI, lo que permite conectar cualquier SDK de OpenAI directamente a https://api.pinference.ai/api/v1. El sistema incluye recuperación automática de tráfico en caso de fallo, redistribuyendo la carga a instalaciones funcionales. El hardware actual se basa en GPUs NVIDIA Blackwell, con el modelo Vera Rubin programado para su introducción en el futuro cercano. El sistema de facturación ofrece seguimiento por equipos y niveles de uso, aunque aún no se han publicado los precios por modelo en detalle.
El funcionamiento de la pila se apoya en tecnologías como NVIDIA Dynamo, vLLM, Mooncake y FlashInfer, desarrolladas en colaboración con Inferact y NVIDIA. Los cambios son integrados directamente en los sistemas de referencia. El objetivo principal es soportar entornos agenciales, donde cada interacción de un agente añade alrededor de 6.000 tokens a un prompt inicial de 140.000. En pruebas, se utiliza el agente SemiAnalysis AgentX, con llegadas frías introducidas para evaluar rendimiento. La separación entre prefill y decode permite ejecutar ambos procesos en grupos distintos de GPUs. Dynamo encarga la gestión de rutas, mientras que vLLM ejecuta el modelo en cada grupo. Los decodificadores recuperan los datos de KV a través de NIXL. En pruebas, Prime registra una reducción del 40% en la latencia inter-token en el percentil 90.
Para los inversionistas y profesionales del sector peruano, esta evolución refleja una convergencia creciente entre inteligencia artificial abierta y aplicaciones prácticas. Aunque los modelos aún están en fases iniciales de adopción en el mercado local, el crecimiento de soluciones como esta puede acelerar el desarrollo de agentes autónomos en sectores clave como salud, educación o servicios financieros. El acceso a infraestructuras de alto rendimiento, sin necesidad de inversiones directas en hardware, abre puertas a empresas medianas y pequeñas que buscan integrar IA sin costos excesivos. Este avance no solo transforma la eficiencia técnica, sino que también redefine el camino hacia la digitalización sostenible en el entorno latinoamericano.