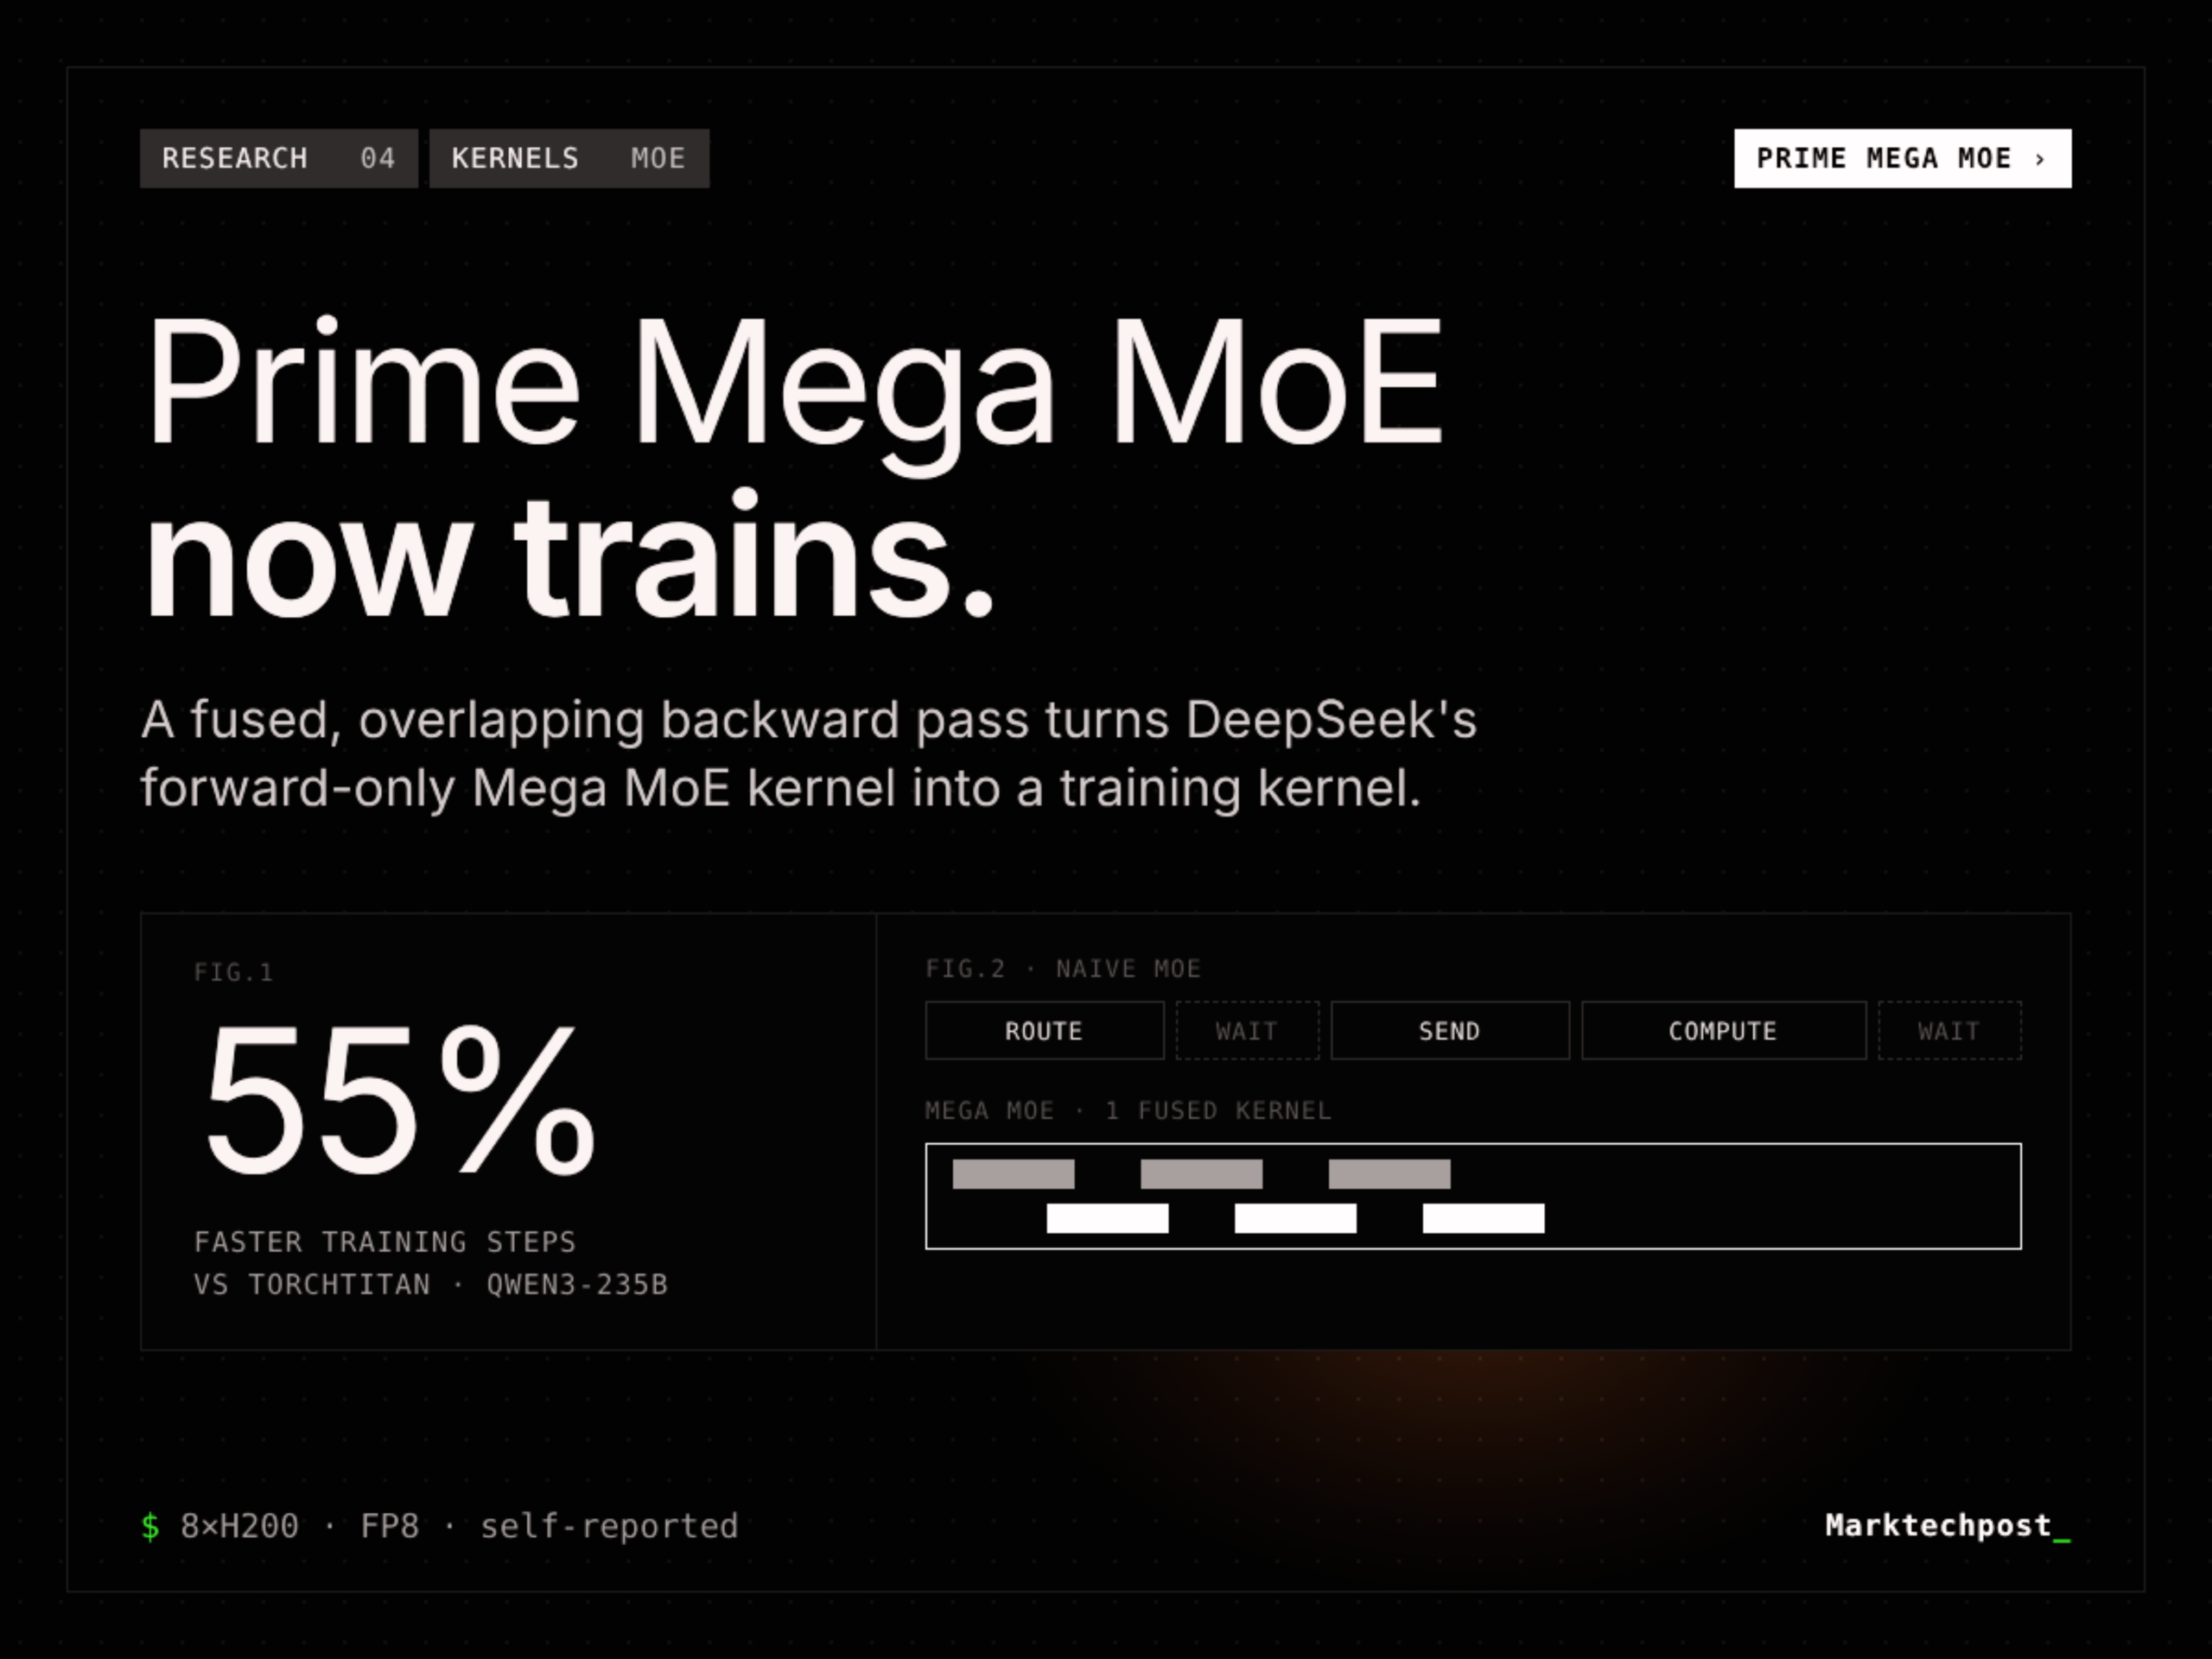
Segun MarkTechPost (AI/ML News), Prime Intellect ha presentado Prime Mega MoE, una extensión de kernel de entrenamiento basada en el núcleo fusionado de DeepSeek. A diferencia de su predecesor, que solo soportaba inferencia, esta nueva versión permite realizar pasos completos de entrenamiento, integrando un proceso de retropropagación optimizado y paralelizado. El avance se evidencia en pruebas con modelos Qwen3, donde los pasos de entrenamiento se aceleran hasta en un 34% respecto a la línea base de Prime RL, y alcanzan un incremento del 55% frente a TorchTitan.
El kernel está diseñado específicamente para operaciones en GPUs, no como un modelo completo. Su eficiencia se ha validado en configuraciones técnicas como Qwen3-30B-A3B y Qwen3-235B-A22B, ambos con 128 expertos y routing top-8. Los resultados se obtienen en arquitecturas NVIDIA Hopper (con precisión FP8 en bloque) y Blackwell (MXFP8), además de operar con BF16 en ambas plataformas. Los datos se basan en pruebas ejecutadas en 8 nodos de H200, con entre 32 y 128 GPUs en total.
En el escenario de paso forward, la mejora es notable: en el modelo Qwen3-30B-A3B, el tiempo de ejecución se reduce de 12.0 milisegundos a 3.9 milisegundos, lo que representa un aceleración de 3.11 veces. Sin embargo, en el caso de un modelo más grande, como el Qwen3-235B-A22B, el proceso de retropropagación registra una disminución más moderada, pasando de 30.5 a 24.6 milisegundos, un incremento de 1.24 veces. Este comportamiento indica que el rendimiento varía según el tamaño del modelo y la carga de cálculo distribuida.
El enfoque detrás de esta innovación radica en resolver un problema crítico del entrenamiento de modelos de múltiples expertos (MoE): la comunicación entre GPUs. En cada capa, los tokens se distribuyen a un subconjunto de expertos, que se encuentran en distintos dispositivos. Este proceso se repite tanto en la fase de adelante como en la fase de retropropagación. En entornos tradicionales, las operaciones se ejecutan de forma secuencial, generando pausas por la gestión de datos y la sincronización entre nodos. El kernel fusionado de Prime Intellect reduce estos tiempos de espera al superponer las operaciones de transporte y cálculo, logrando un flujo más continuo.
Para inversionistas y equipos técnicos en Perú, esta evolución es clave. El sector de inteligencia artificial en el país está creciendo rápidamente, especialmente en sectores como finanzas, logística y servicios públicos, donde los modelos de decisión complejos son cada vez más demandados. Aunque el rendimiento de Prime Mega MoE aún no está disponible para usuarios finales, su existencia indica una tendencia clara: el entrenamiento de modelos de gran tamaño se vuelve más eficiente, lo que puede reducir los costos operativos y acelerar el desarrollo de soluciones personalizadas. Este avance podría permitir a empresas locales, sin necesidad de grandes infraestructuras, acceder a capacidades de IA más potentes, acelerando su transformación digital.