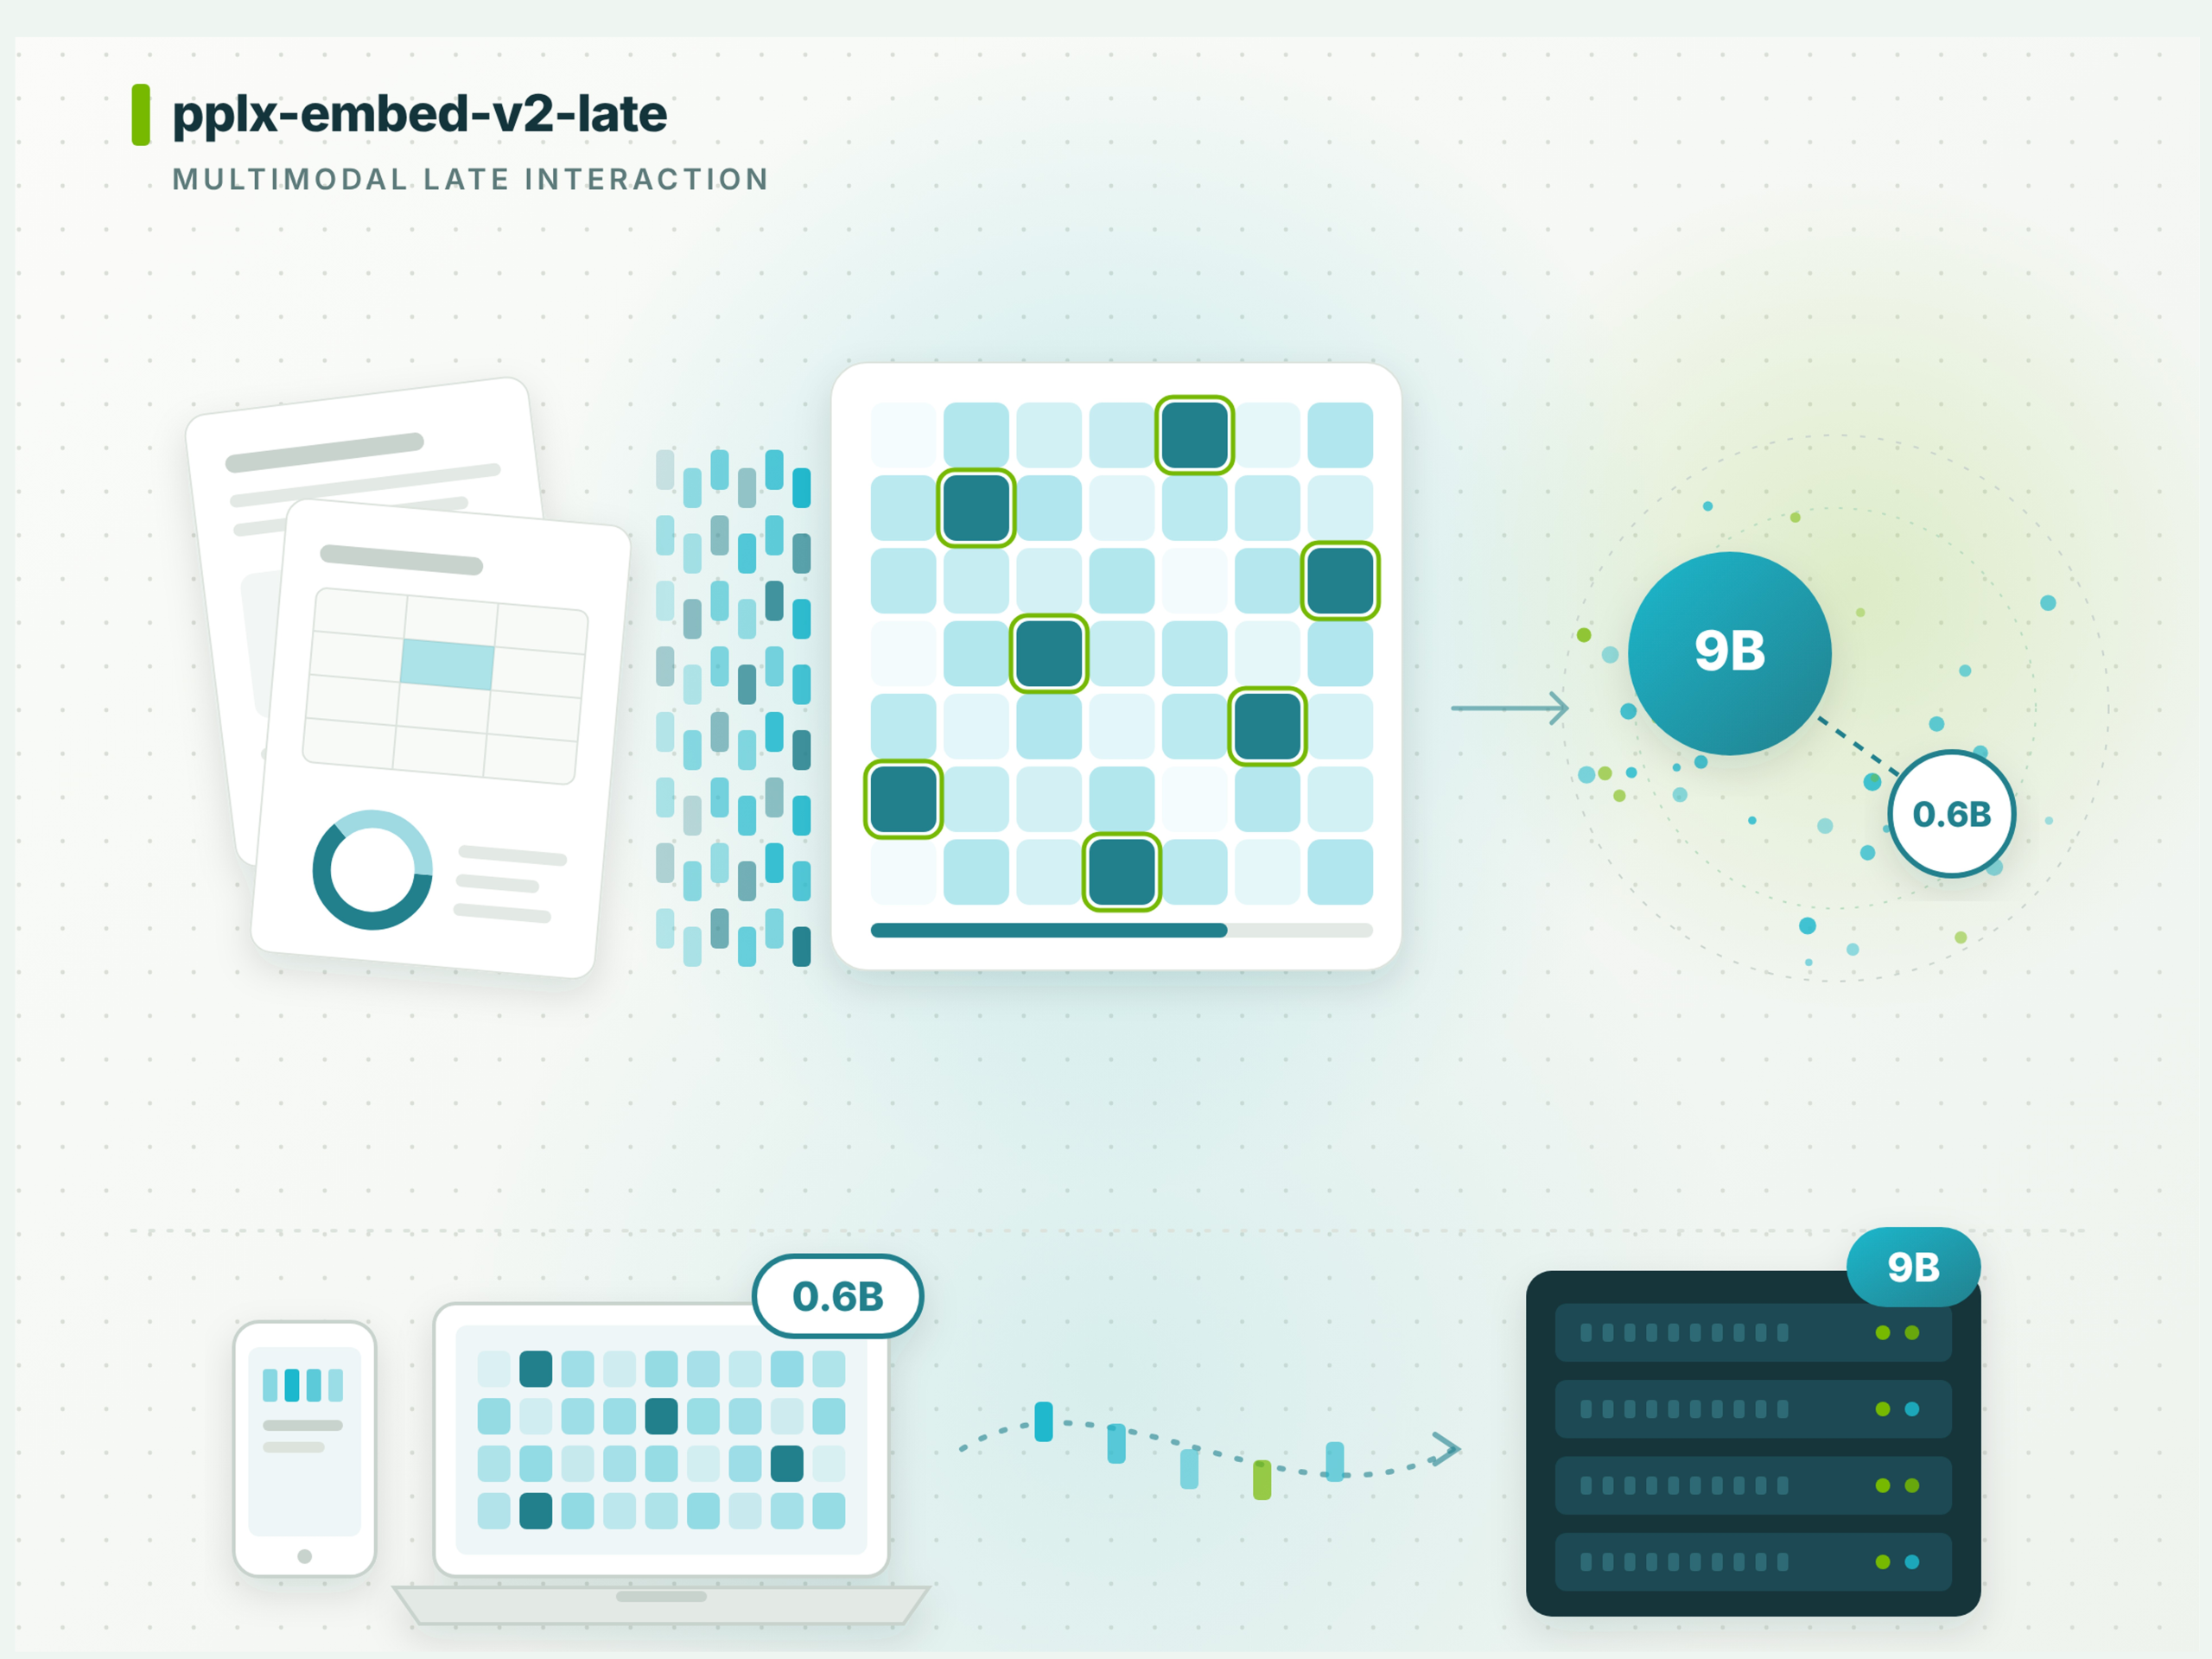
Segun MarkTechPost (AI/ML News), Perplexity ha presentado dos modelos de embeddings multimodales, pplx-embed-v2-late, diseñados para procesar texto, imágenes y páginas PDF generadas. Los modelos, basados en arquitecturas ColBERT, ofrecen dos versiones: una de 0.6B parámetros y otra de 9B, cada una con características específicas para distintos escenarios de uso. La versión ligera, con aproximadamente 340 millones de parámetros activos, se optimiza para aplicaciones en dispositivos de borde, permitiendo su ejecución en entornos con limitaciones de recursos. Por su parte, el modelo de 9B busca alcanzar precisión máxima, especialmente en tareas complejas de recuperación de información.
Ambos modelos comparten un espacio de embeddings común, facilitando la integración de múltiples tipos de datos. La eficiencia se evidencia en su diseño: los vectores tokenizados de 128 dimensiones son hasta 32 veces más compactos que los de competidores que operan con entre 2.048 y 4.096 dimensiones. Este ahorro de dimensiones impacta directamente en el consumo de memoria y en la velocidad de procesamiento. El rendimiento del 9B en el conjunto MADQA alcanza un 92.4%, destacándose como el mejor resultado registrado. En el benchmark BrowseComp+, supera al modelo más avanzado de densos por un margen de 8,7 puntos porcentuales. Sin embargo, en el test ViDoRe v3, el modelo de 0.6B registra un 61,2%, siendo aún el segundo mejor resultado en ese escenario, aunque no logra liderar el desempeño en recuperación visual.
El modelo no permite mezclar textos y imágenes en una sola entrada, lo cual limita su uso en aplicaciones híbridas. Además, el tamaño del índice crece proporcionalmente al largo de los documentos, lo que puede generar escalabilidad problemática en bases de datos grandes. Aunque Perplexity afirma que los modelos están disponibles bajo licencia MIT, permitiendo su uso comercial, no se ha publicado aún un informe técnico completo. Los resultados son autoinformados, lo que sugiere una necesidad de validación independiente. Los modelos requieren versiones mínimas de bibliotecas: sentence-transformers 6.0.0 o superior y transformers 5.4.0 o más recientes. Los datos de memoria se estiman en 2 bytes por parámetro, aunque los checkpoints oficiales se almacenan en precisión de 32 bits (F32), lo que duplica el tamaño de descarga.
Para inversores y profesionales del sector peruano, esta evolución en modelos de IA multimodal representa una oportunidad de integrar tecnologías más eficientes en entornos de búsqueda, gestión de documentos y servicios digitales. En un contexto donde el acceso a información visual y textual se vuelve crítico, especialmente en sectores como educación, salud o administración pública, estos modelos pueden optimizar la recuperación de datos. Aunque aún no están disponibles en servicios públicos, su potencial para automatizar procesos de búsqueda en entornos locales —como registros oficiales o contratos— es notable. El desarrollo de infraestructuras sencillas y rápidas, como los modelos de borde, puede acercar la inteligencia artificial a pequeñas y medianas empresas que aún no cuentan con recursos tecnológicos avanzados.