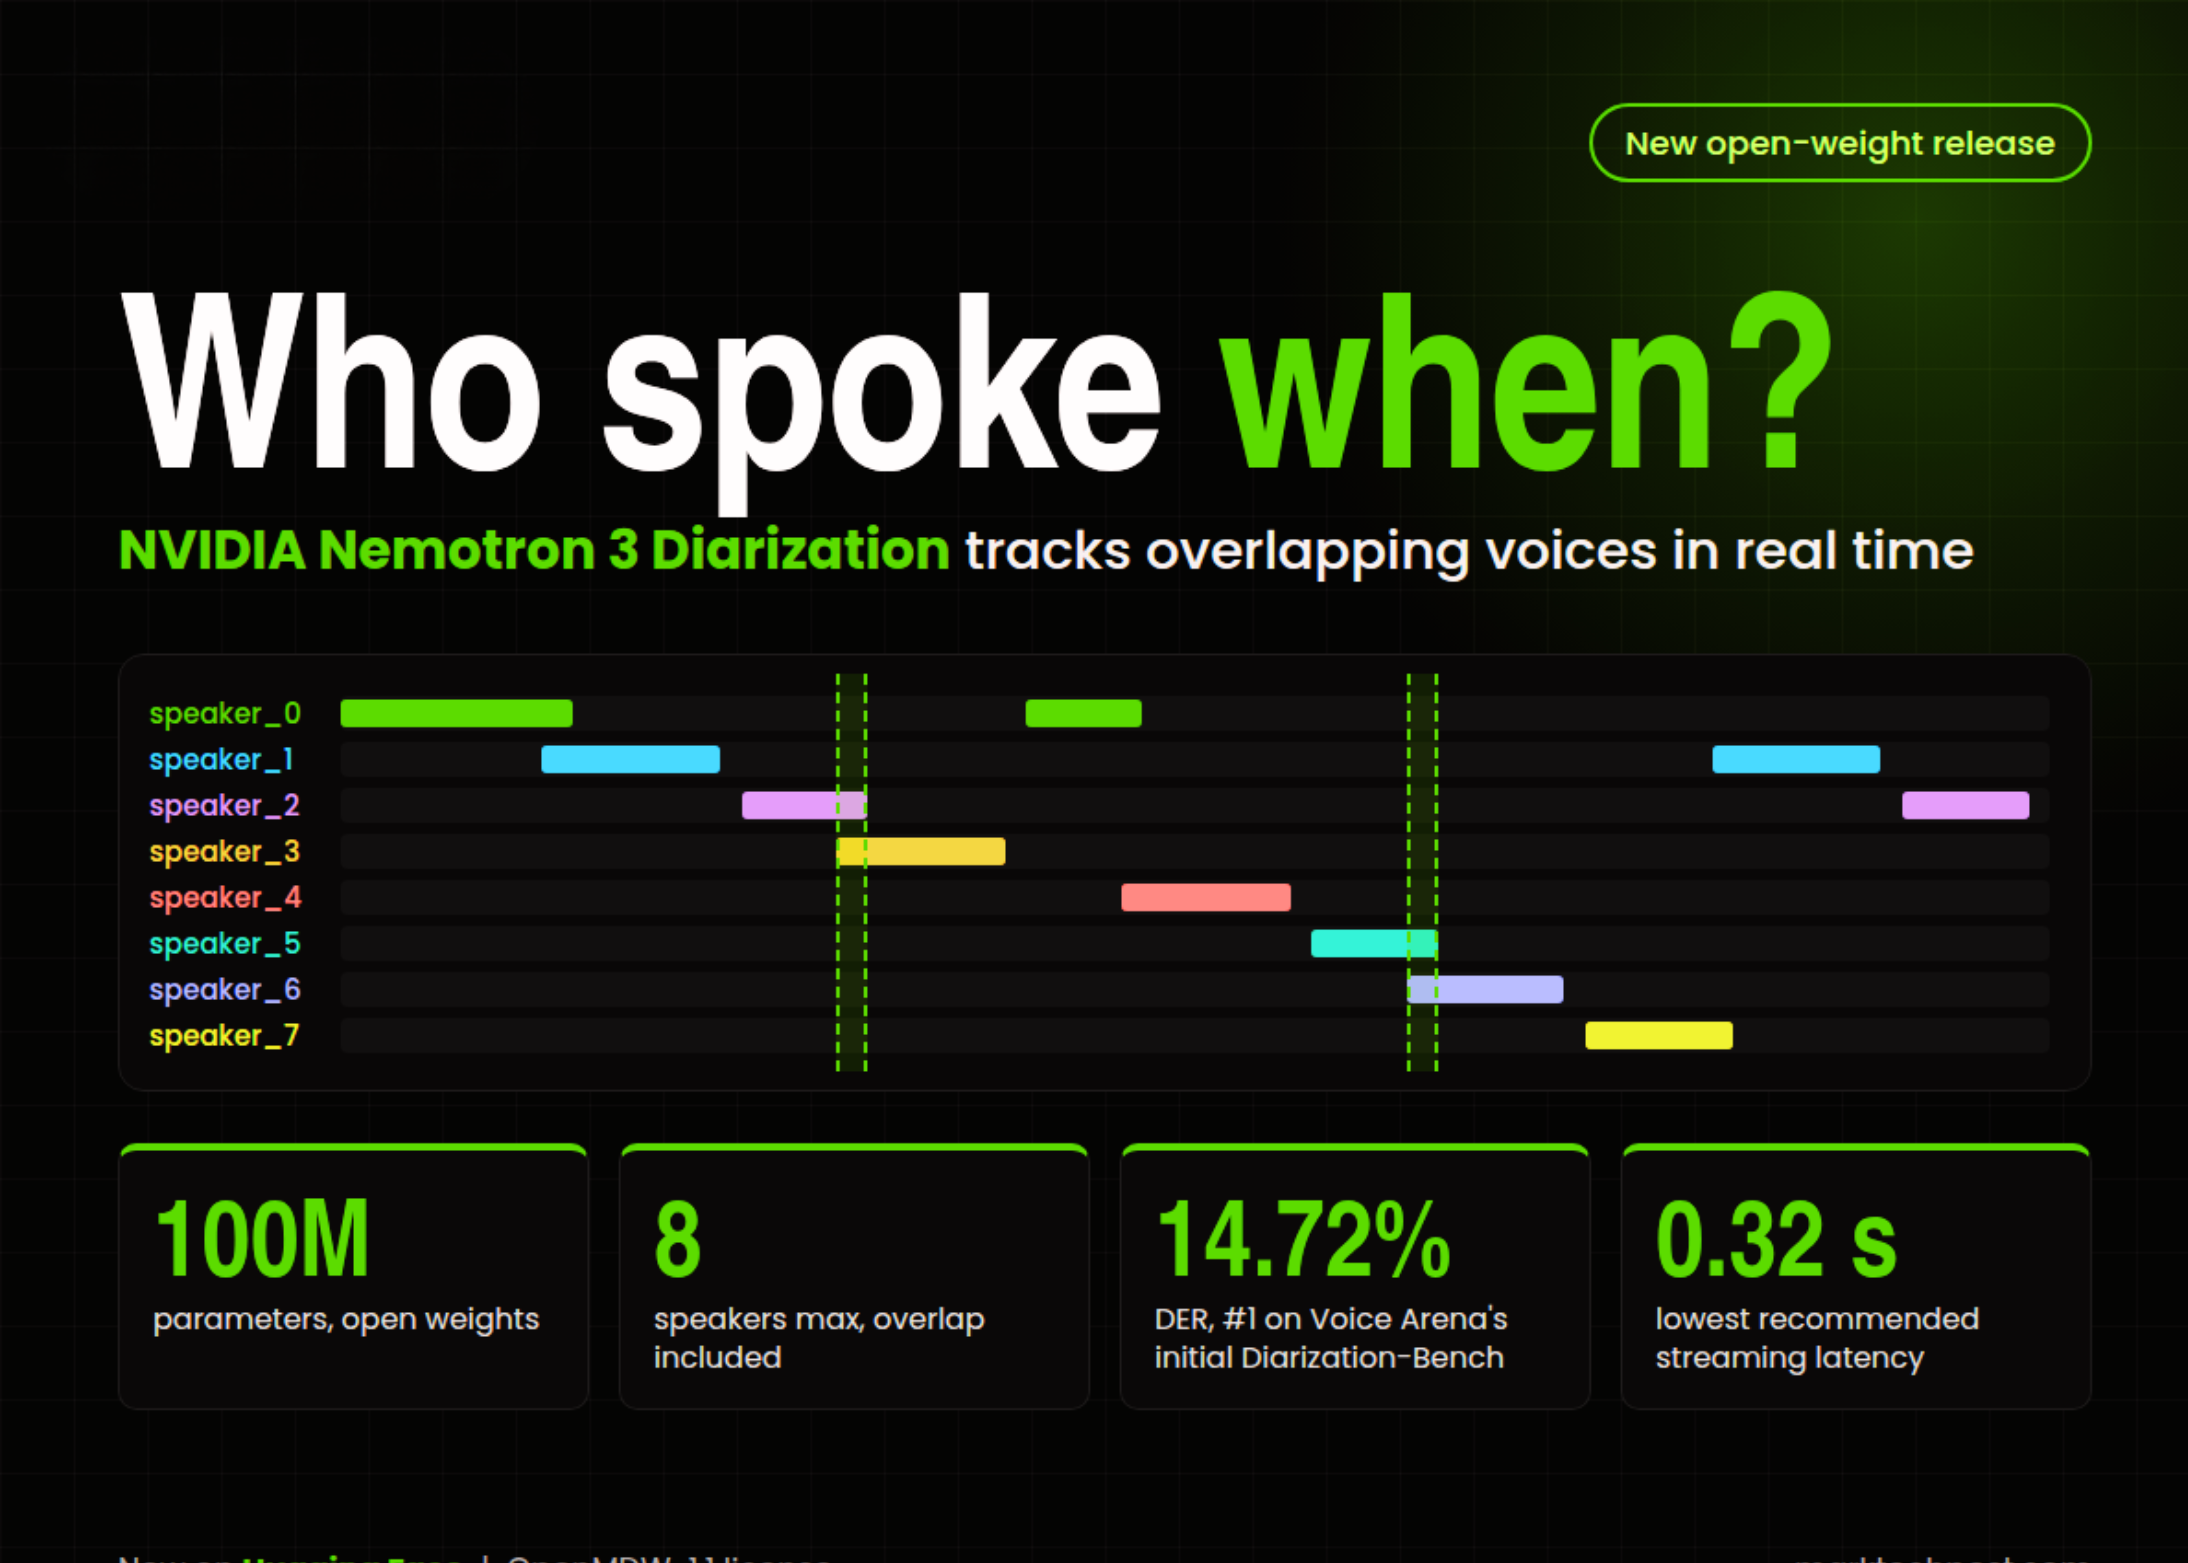
Segun MarkTechPost (AI/ML News), NVIDIA ha lanzado Nemotron 3 Diarization, un modelo de identificación de hablantes abierto, disponible en Hugging Face. Este sistema, con 100 millones de parámetros, permite distinguir hasta ocho voces simultáneamente en audio, incluso cuando las personas hablan al mismo tiempo. La novedad radica en que el modelo procesa tanto grabaciones oflines como streams en tiempo real, lo que lo convierte en una herramienta práctica para entornos dinámicos. Sus pesos están licenciados bajo la OpenMDW 1.1, lo que permite su uso en aplicaciones comerciales. Para su ejecución, se requiere un entorno Linux y una tarjeta gráfica NVIDIA de generación Ampere, Ada Lovelace, Hopper o Blackwell, mediante el entorno NeMo.
El problema que resuelve este modelo es fundamental en el procesamiento de voz: mientras que el reconocimiento automático de voz (ASR) identifica las palabras, no asigna quién las dijo. Sin atribución, un resumen automático no puede saber si una decisión fue tomada por un jefe o por un colaborador. La diarización, por tanto, entrega intervalos temporales que indican cuándo cada persona habla. Al combinar esos datos con el texto generado por ASR, se obtiene un transcripción que indica quién dijo qué, en qué momento. Este paso es esencial en herramientas de reuniones, análisis de llamadas, pipelines de podcasts y en el manejo de memoria de agentes vocales.
En comparación con su versión anterior, Streaming Sortformer que solo soportaba hasta cuatro hablantes, este nuevo modelo duplica la capacidad de identificación. NVIDIA enfatiza que su objetivo es manejar audio complejo en entornos de múltiples personas que interrumpen constantemente el diálogo. El modelo ingresa audio en formato de 16 kHz, mono, compatible con .wav, .flac, .opus o .mp3. Luego, convierte el sonido en espectros mel, con pasos de 10 milisegundos, los cuales se acumulan en bloques de 80 milisegundos. A través de un encoder de Transformadores de 31 capas, con embeddings de posición rotativos (RoPE), se procesan estos bloques. Posteriormente, una capa Conv1D recalibra la salida a una resolución de 10 milisegundos, generando una matriz de tamaño [T, 8] que muestra las probabilidades de actividad por hablante en cada instante.
Para el lector peruano, este avance es especialmente relevante en contextos como el manejo de reuniones empresariales, donde la claridad en la atribución de decisiones puede impactar la toma de acción. En entornos de trabajo híbridos o remotos, donde las llamadas suelen ser largas y con múltiples participantes, la capacidad de identificar quién dijo qué en tiempo real puede optimizar el seguimiento de compromisos y mejorar la gestión de comunicación interna. Además, puede facilitar la creación de resúmenes automáticos que no solo capturan el contenido, sino también la responsabilidad de cada intervención. Así, empresas de servicios, educación o salud pueden integrar esta tecnología para mejorar la eficiencia de sus procesos internos.