Segun MarkTechPost (AI/ML News), investigadores de NVIDIA en colaboración con la Universidad de Princeton y la Universidad de Maryland han desarrollado PivotOPD, una técnica de distilación en línea diseñada para mejorar la capacidad de agentes de inteligencia artificial multietapa de recuperarse de errores decisivos. Esta metodología no genera un nuevo modelo, sino que optimiza el entrenamiento de agentes existentes, permitiendo que aprendan a identificar y corregir errores que comprometen el avance de una tarea. Los resultados fueron evaluados en tres entornos: ALFWorld, WebShop y preguntas de búsqueda, utilizando versiones de modelos Qwen3 de 1.7B, 8B y un estudiante de Nemotron-3.5-SFT en SWE-Bench. En todos los escenarios, PivotOPD logró los mejores resultados promedio frente a 13 métodos de referencia, con un rendimiento superior en cada uno de los 8 promedios por benchmark, independientemente de las semillas utilizadas.
El sistema se enfoca en detectar lo que se denomina un “error pivotal”: una acción que alarga o hace imposible completar una tarea. En ALFWorld, este tipo de error se mide en cada turno mediante un oráculo simbólico. En estudios con Qwen3-8B, Qwen3-30B-A3B y Qwen3-235B-A22B, se encontró que el 59% de los intentos fallidos (155 de 262) incluían al menos un error pivotal. Este error suele presentarse temprano, en una mediana de 8 a 12 turnos de un total de 30, y luego los agentes pierden entre 18 y 21 turnos sin recuperarse. En pruebas de reproducción, si se corrige el error pivotal, el éxito en completar la tarea aumenta de un 8% a un 59%. Incluso si se mantiene el error y se aplica la acción correcta en los siguientes dos turnos, el resultado alcanza un 58%. Esto demuestra que la recuperación es viable y efectiva, aunque depende de la calidad de la simulación y del alineamiento entre el modelo de enseñanza y el oráculo.
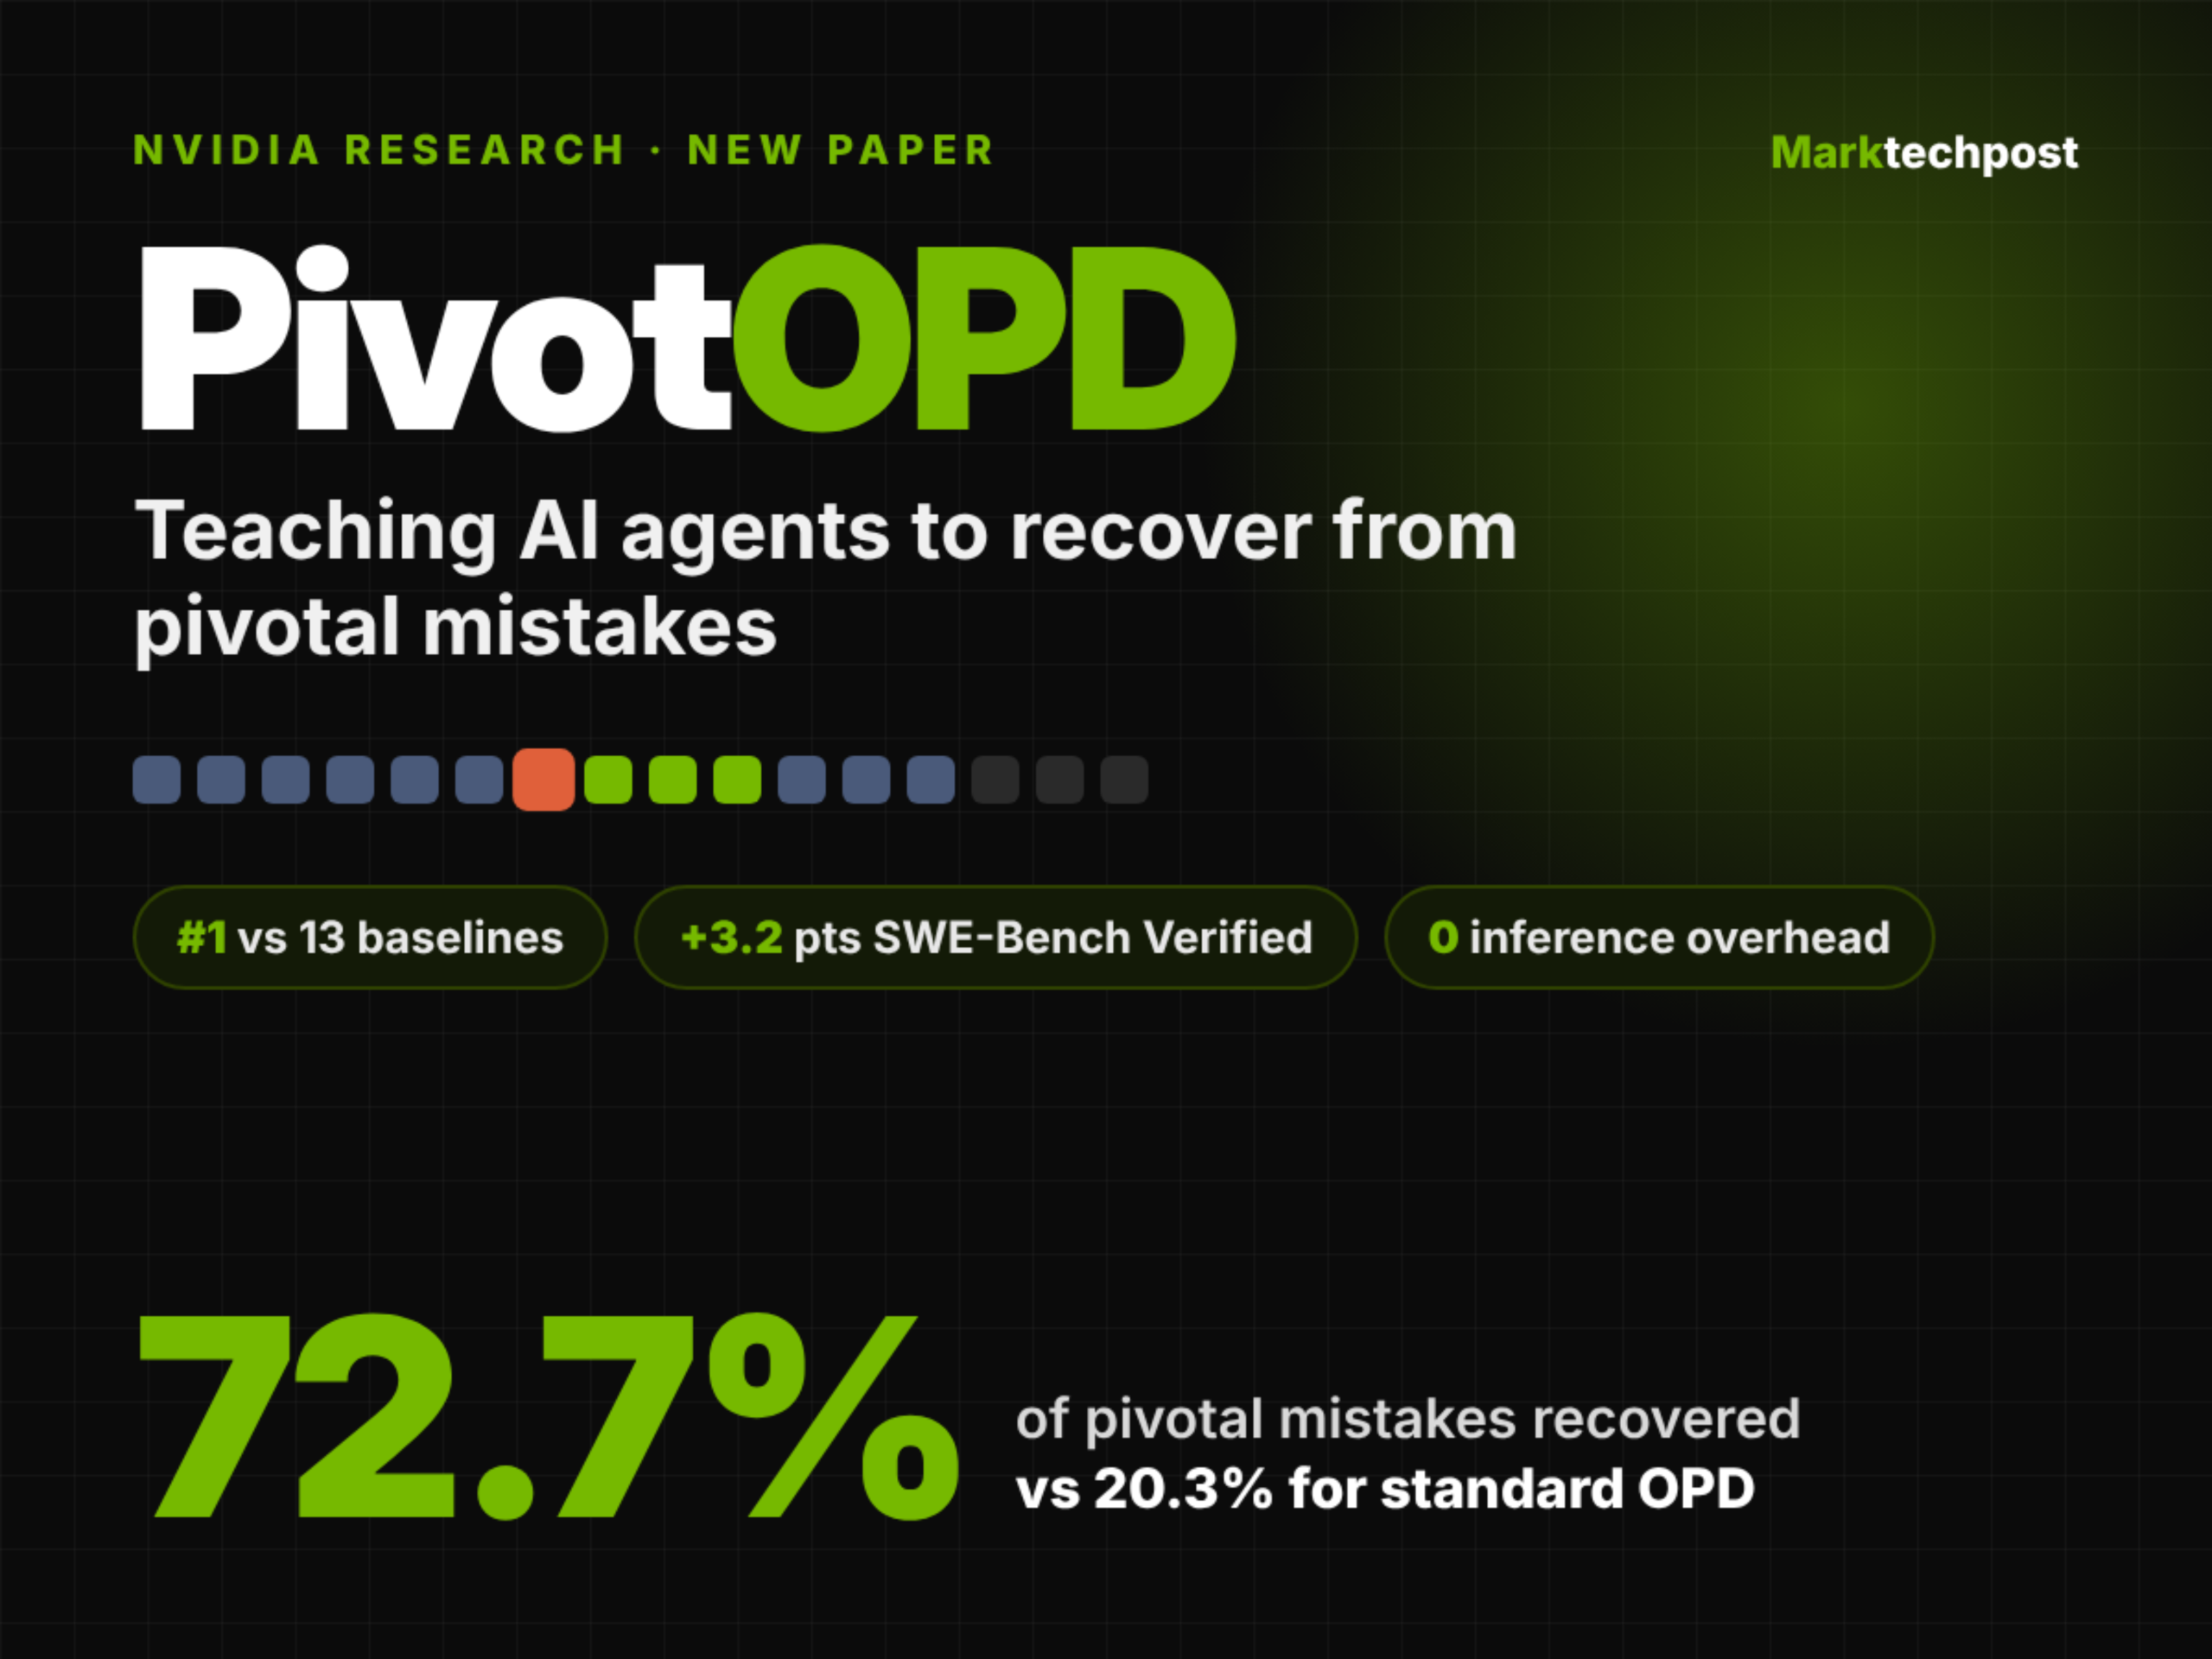
El desempeño de PivotOPD supera notablemente al método estándar de distilación en línea (OPD), que no enseña adecuadamente esta habilidad de recuperación. En pruebas, PivotOPD logra recuperarse de 72,7% de los errores puntuales, frente al 20,3% del OPD tradicional. Sin embargo, en tareas específicas como “Look” en ALFWorld, el rendimiento del modelo de 1.7B baja hasta el 55,9%, frente al 83,9% del sistema SOD. Esta variabilidad resalta que el éxito depende tanto de la estructura del entorno como de la precisión con la que el modelo de enseñanza replica las decisiones óptimas en los escenarios fallidos. Además, el método se entrena en nodos NVIDIA H100 y no añade costo de inferencia, lo que permite ejecutar el agente en cualquier plataforma donde se encuentre el modelo base.
Para el lector peruano, este avance es relevante porque refleja cómo las tecnologías de inteligencia artificial están evolucionando para operar de forma más resiliente, como un sistema que aprende de sus errores. En entornos donde la toma de decisiones es crítica —como el manejo de inversiones, servicios financieros o la gestión de operaciones comerciales—, la capacidad de un sistema de corregirse sin necesidad de reinicio o intervención humana es un paso clave. Aunque aún no se aplican directamente en mercados peruanos, este tipo de desarrollo podría influir en futuras plataformas de asesoría automática, donde la fiabilidad y la capacidad de adaptación serán factores determinantes para la confianza del usuario.