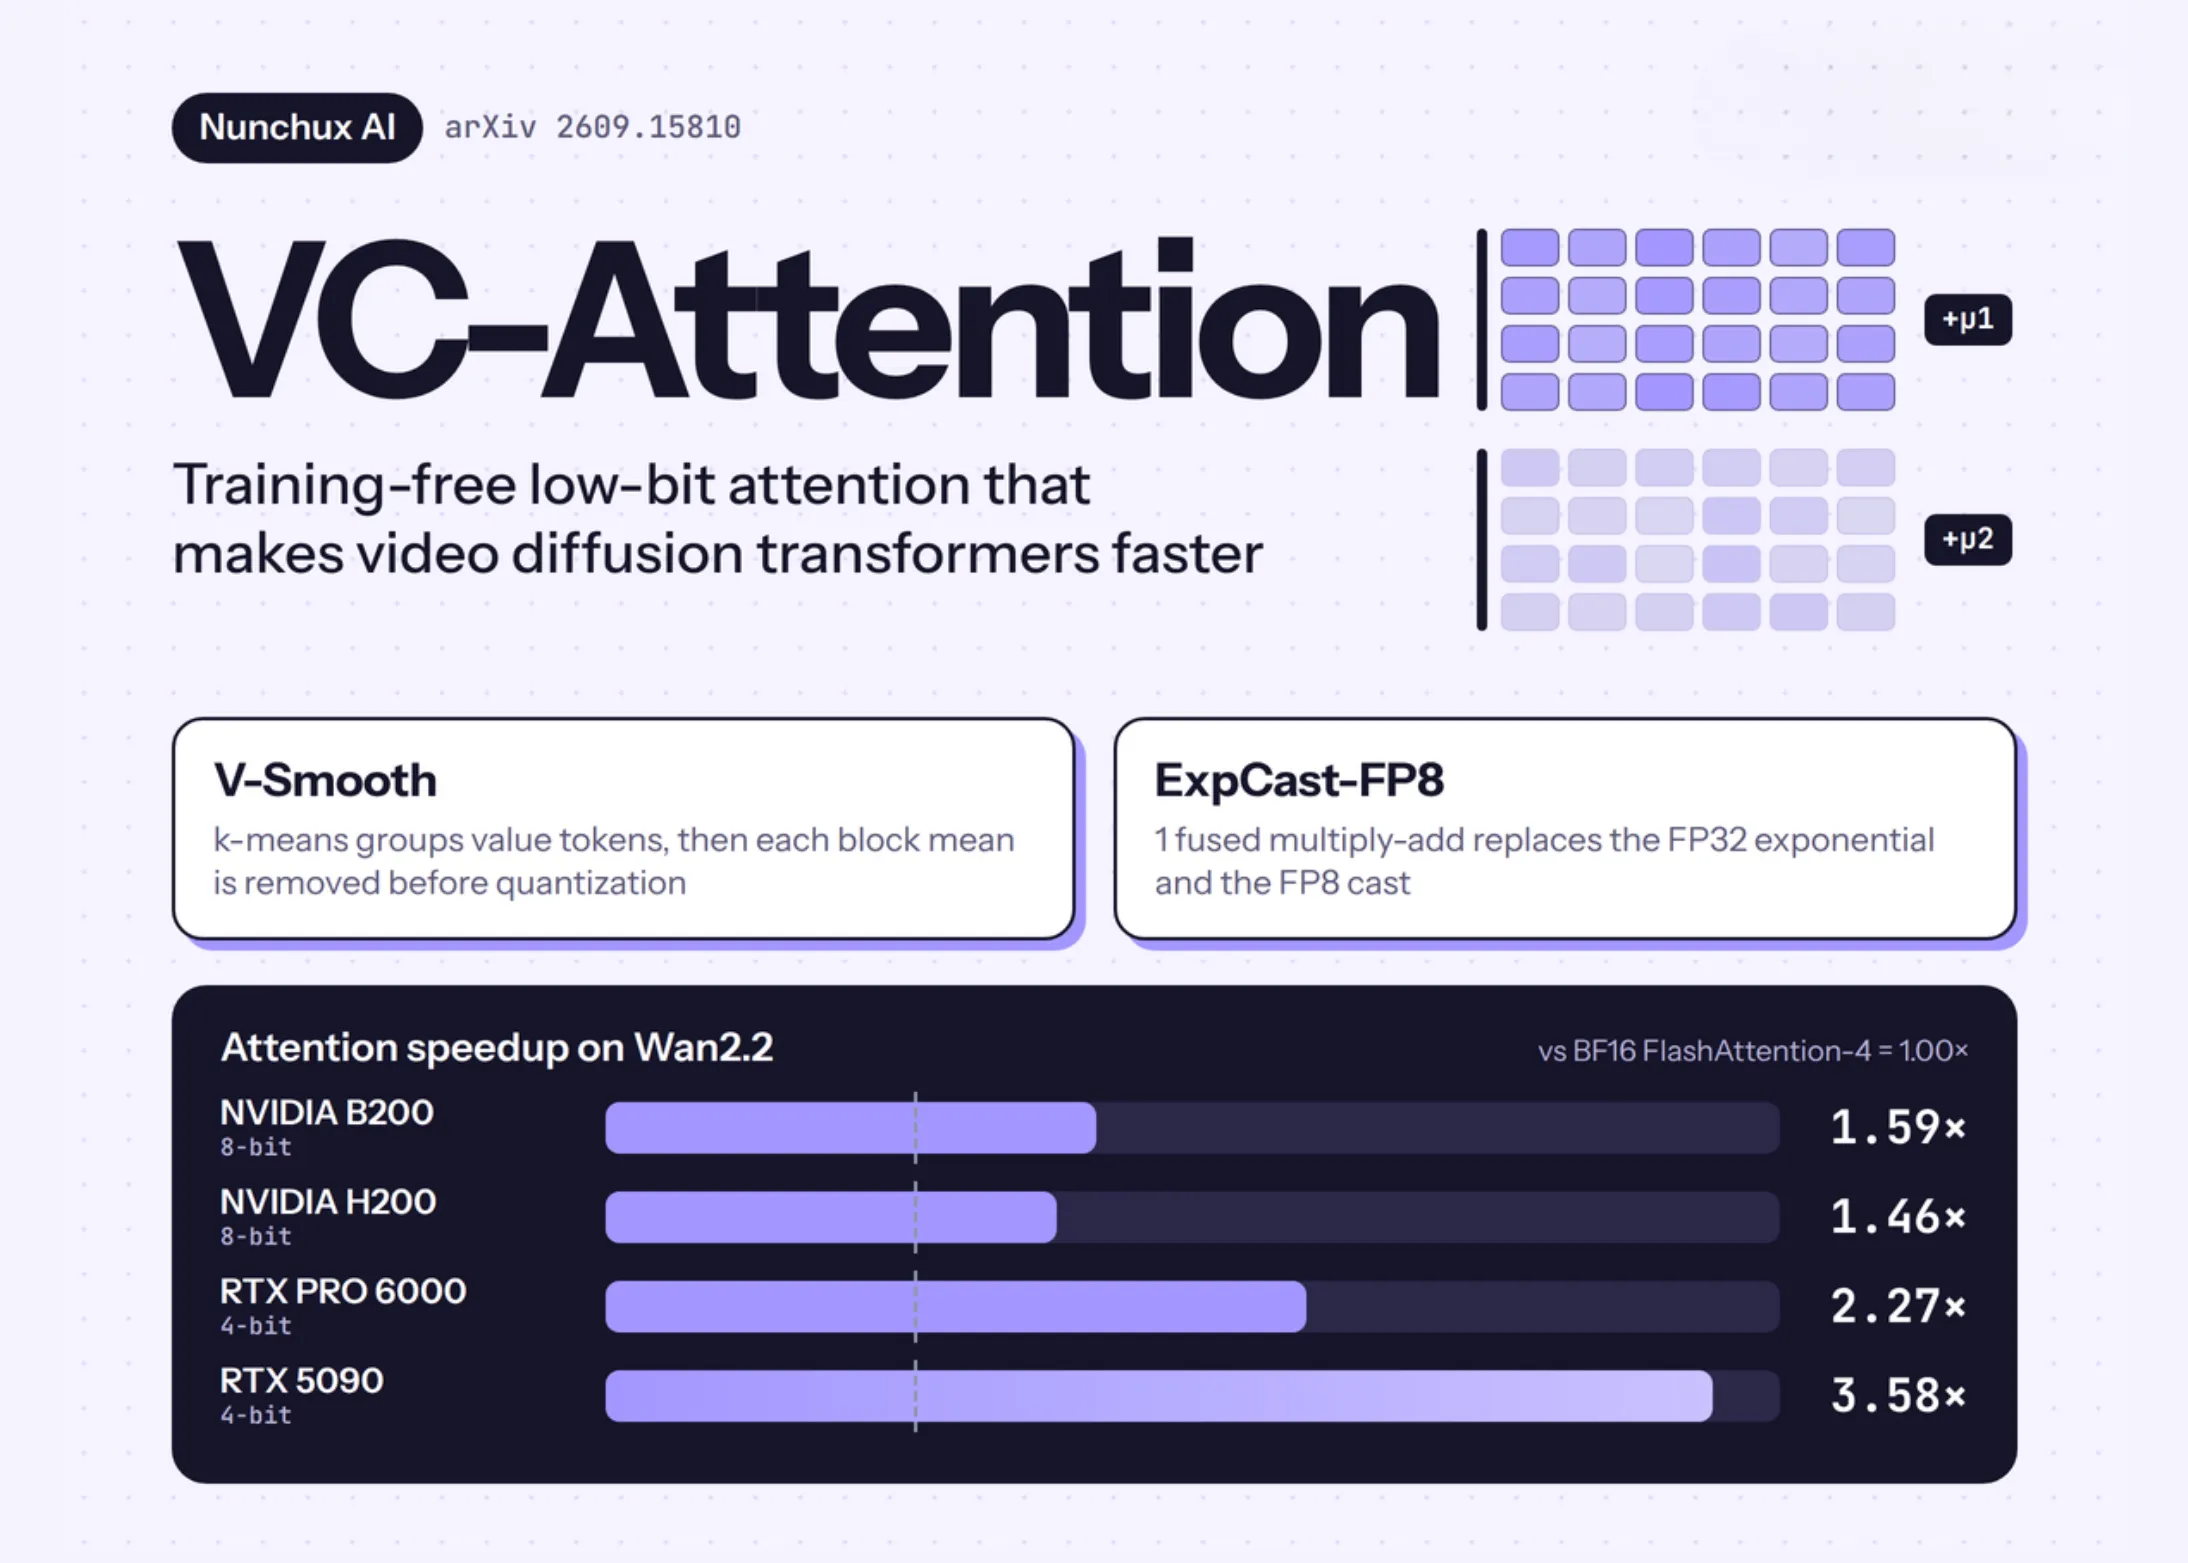
Segun MarkTechPost (AI/ML News), Nunchux AI ha presentado VC-Attention, un núcleo de atención de bajo bit diseñado para optimizar los transformadores de difusión en video. Este avance se centra en resolver dos limitaciones críticas en el proceso de generación de contenido video: el error de cuantización en valores y la lentitud del proceso de softmax. Los modelos de atención se convierten en el principal consumidor de tiempo en la ejecución de video, ya que en una secuencia de 5 segundos en resolución 720p con un modelo de 14B parámetros, se generan aproximadamente 70 mil tokens. En placas como la RTX 5090, el cálculo de atención representa más del 64% del tiempo total de generación. En el caso específico del modelo MiniMax-H3, la fase de eliminación de ruido depende en un 66% de operaciones de atención en una única unidad B200.
El enfoque propuesto por el equipo de investigación se basa en dos innovaciones. La primera, V-Smooth, aborda el problema de los valores atípicos que se localizan en pocos tokens y que cambian de posición entre capas, cabezas y pasos. En lugar de aplicar rotaciones que eliminan estos valores, se emplea un enfoque de clustering en tiempo real mediante k-means, agrupando tokens por lote y cabeza. A continuación, se aplica una normalización mediante la resta de la media de cada bloque de 128 tokens, manteniendo solo la diferencia para la cuantización. Este proceso se realiza con precisión de 8 bits (E4M3) o 4 bits (NVFP4), y se completa sin necesidad de un segundo paso o almacenamiento adicional. Los resultados indican que al promediar 100 cabezas del modelo Wan2.2, este método elimina hasta un 36% de la energía en secuencia cuando se aplica ordenamiento de tokens.
La segunda mejora se encuentra en la reducción del uso de precisión de punto flotante en la operación de softmax. Hasta ahora, este paso se ejecutaba en formato FP32, lo que generaba una etapa larga en la línea de procesamiento, especialmente en arquitecturas como B200 y H200. La nueva implementación permite que la conversión de FP8 se realice directamente en el flujo de cálculo, reduciendo así el tiempo de espera. Aunque los cálculos de QK y PV se aceleran mediante Tensor Cores de bajo bit, el error residual en la salida se mantiene bajo el 0.2% tras la rotación de valores.
Para el lector peruano, esta evolución tecnológica tiene implicaciones directas en el futuro de la creación de contenido digital. A medida que los modelos de inteligencia artificial se vuelven más eficientes, el acceso a herramientas de generación de video de alta calidad, incluso en entornos con recursos limitados, se vuelve más real. Esto podría facilitar la expansión de industrias como el entretenimiento, la educación o el marketing digital, donde la producción de videos de alto rendimiento es clave. Sin embargo, el éxito de estas aplicaciones dependerá de que las tecnologías se adapten a condiciones de infraestructura local, lo que exige una mayor inversión en capacidades de cálculo y conectividad.