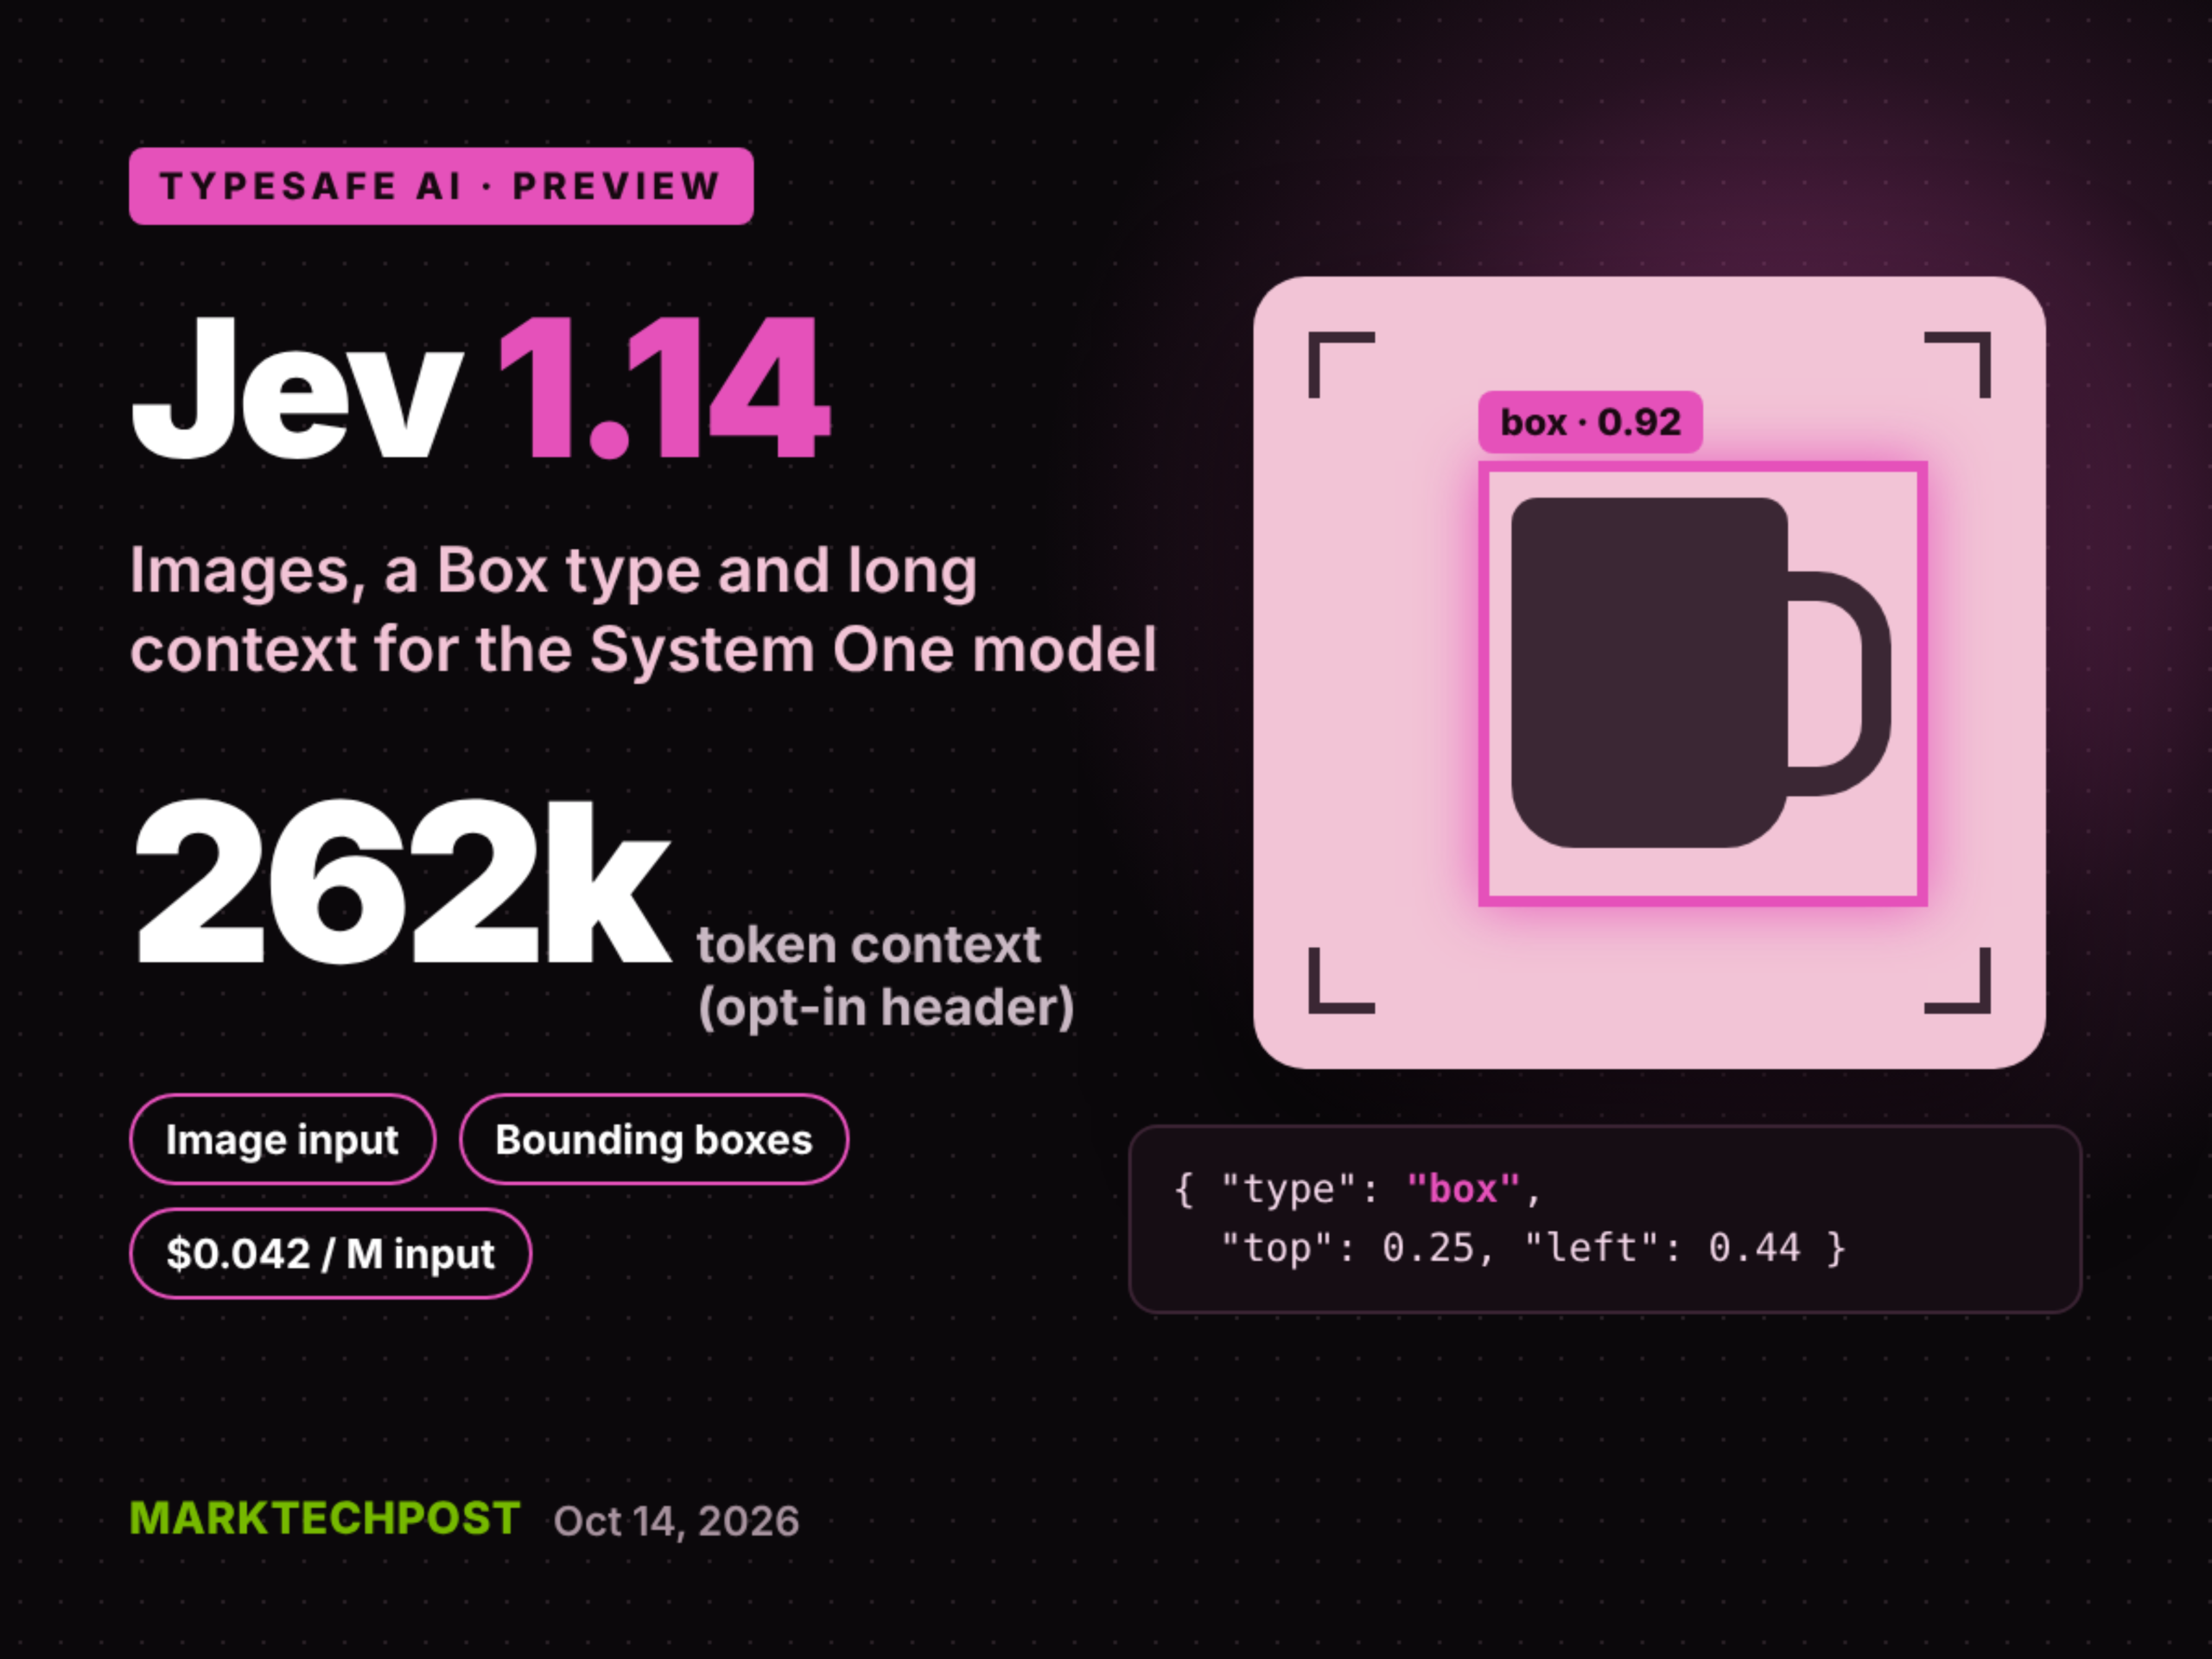
Segun MarkTechPost (AI/ML News), TypeSafe AI ha lanzado una actualización clave de su modelo de decisión Jev 1.14, disponible bajo el alias jev-preview. Esta versión introduce tres funciones experimentales, clasificadas como zonas de riesgo, que permiten a los desarrolladores integrar tareas visuales y estructuras más complejas en sus aplicaciones. Entre ellas se encuentran el procesamiento de imágenes, un tipo de respuesta denominado "box" y un contexto de hasta 262 mil tokens por solicitud, aunque los valores por defecto se mantienen en 64 mil tokens para la solicitud y 32 mil para la pregunta. El modelo solo opera a través de la API de TypeSafe, sin disponibilidad de pesos abiertos ni variantes optimizadas para hardware o cuantización.
La arquitectura de Jev se basa en una estrategia de toma de decisiones tipada, en lugar de generar texto libre. Al recibir un estado, junto con preguntas estructuradas como opciones, puntuaciones o valores nulos, el sistema devuelve respuestas con valores específicos, probabilidades y niveles de confianza. Este enfoque fue entrenado mediante Reinforcement Learning for Calibrated Decisions (RLCD), lo que permite una evaluación más precisa de la certeza de cada respuesta. Los avances en Jev 1.14 son sutiles en su mayoría, aunque TypeSafe destaca una mejora notable en el soporte multilingüe, aunque no ha publicado métricas independientes. En pruebas internas, el modelo logró identificar correctamente 30 de 36 casos de corte en una evaluación de detección de bordes, aunque aún no está validado para uso en producción.
La integración de imágenes opera mediante una estructura de assets, donde cada imagen se almacena bajo una referencia única en un mapa superior. Esta referencia puede luego insertarse en el estado, instrucciones o criterios del sistema, y la API la reemplaza por la imagen antes de que el modelo la procese. Aunque TypeSafe afirma que el modelo ya era multimodal desde Jev 1.13, esta actualización refuerza su capacidad para manejar entradas visuales en entornos de inspección y localización. Sin embargo, es clave destacar que ninguno de los tres componentes experimentales está listo para aplicaciones comerciales. En particular, el sistema de "box" no ofrece una respuesta de "no encontrado", lo que limita su utilidad en escenarios de detección de ausencia.
Para el lector peruano, estas evoluciones en modelos de decisión tipados representan una oportunidad para aplicar inteligencia artificial en sectores clave como la logística, el control de calidad en manufactura o la gestión de bienes públicos. Aunque el modelo aún no está validado para uso en producción, su capacidad para procesar imágenes y responder con precisión en múltiples idiomas podría ser útil en entornos con alta diversidad lingüística, como el sistema de atención al público en centros de salud o en servicios de transporte. Sin embargo, debe considerarse con cautela, dado que las funcionalidades aún están en fase experimental y no han sido probadas en escenarios reales. La inversión en tecnologías como esta debe ir acompañada de pruebas rigurosas y evaluaciones de riesgo, especialmente en contextos donde la fiabilidad de las respuestas es crítica.