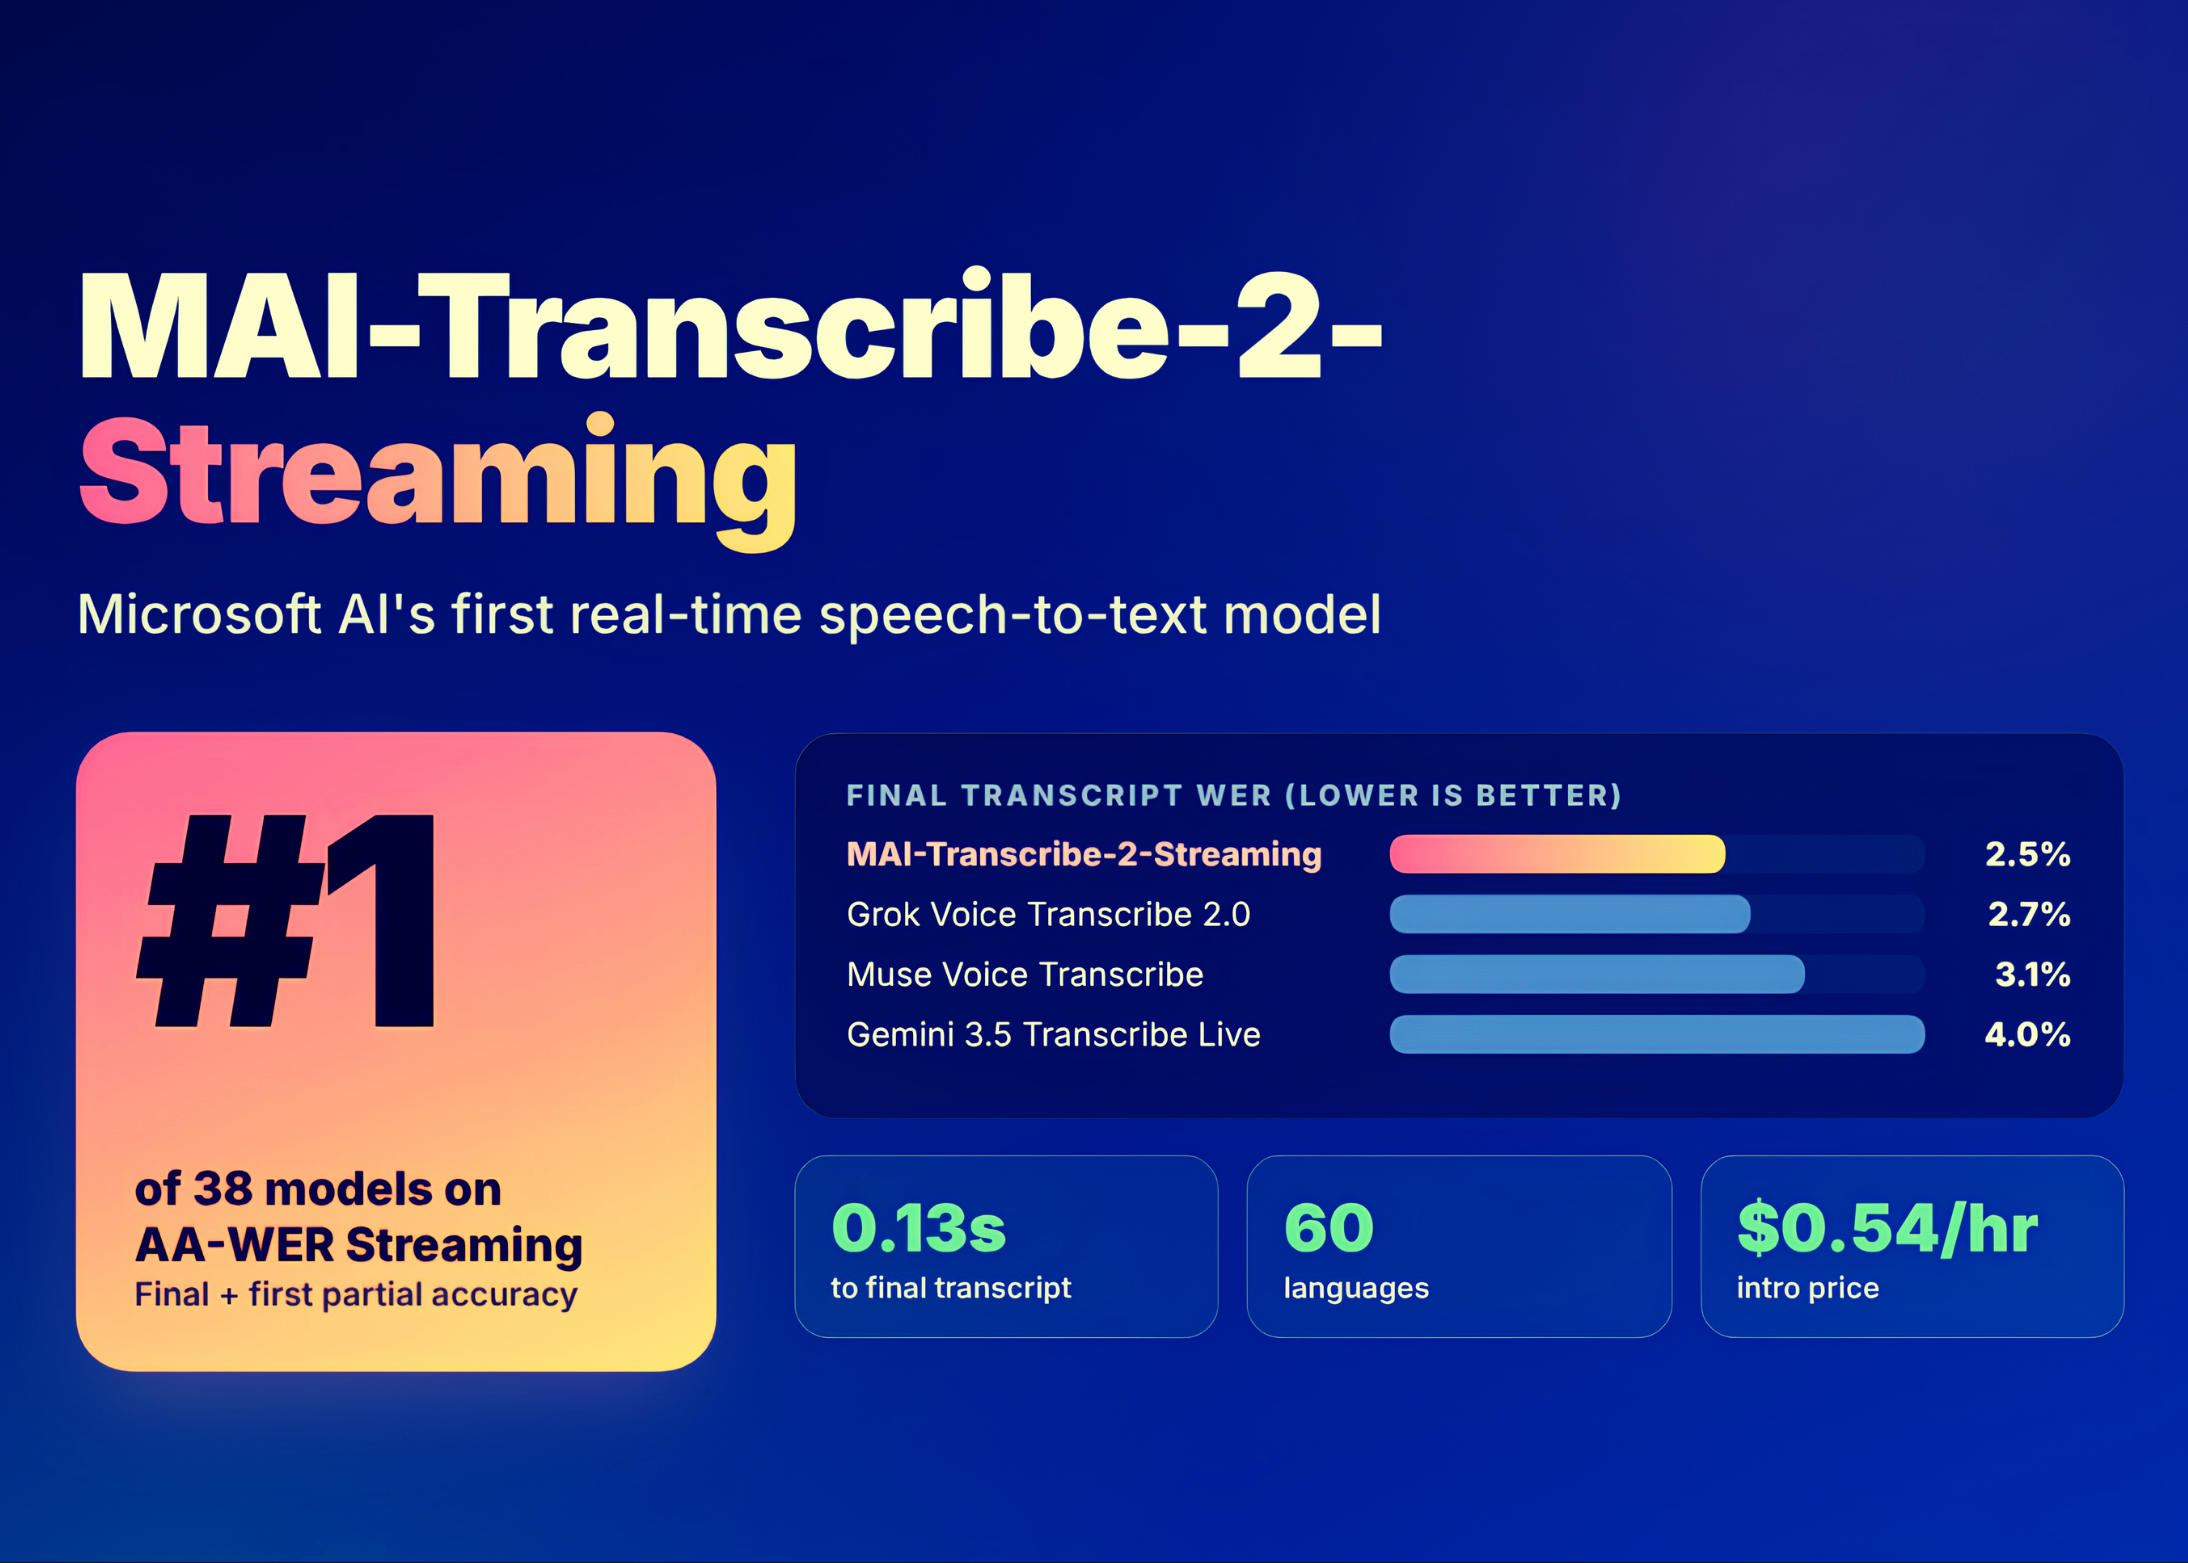
Segun MarkTechPost (AI/ML News), Microsoft ha lanzado MAI-Transcribe-2-Streaming, un modelo de conversión de voz a texto en tiempo real, que se presenta como el más preciso entre 38 opciones evaluadas. Este avance, debutó el 1 de octubre de 2026, junto con dos modelos de síntesis de voz: MAI-Voice-2.1 y MAI-Voice-2.1-Flash. La evaluación realizada por Artificial Analysis destaca su desempeño en precisión tanto en transcripciones iniciales como finales, colocándolo en primer lugar en ambos aspectos. El modelo soporta 60 idiomas y detecta automáticamente el idioma hablado en cada momento, sin necesidad de intervención manual.
La tecnología permite que el texto se genere en paralelo con la conversación, con la primera hipótesis —llamada parcial— disponible apenas 100 milisegundos después de que se reciba el sonido. A medida que se acumulan más datos, el sistema actualiza esta estimación, finalizando con un texto estable al final de la frase. Esta capacidad es clave para aplicaciones donde se requiere respuesta inmediata, como agentes virtuales o subtítulos en vivo. En pruebas internas, el equipo de Microsoft reportó que el modelo identifica palabras dos veces más rápido que sus competidores más cercanos.
Los datos de evaluación se basan en aproximadamente ocho horas de audio, compuesta por 50% de AA-AgentTalk, 25% de VoxPopuli y 25% de Earnings22. La latencia se mide desde el final de la palabra, detectado por SileroVAD. En este escenario, el modelo alcanza una tasa de error de 2,5% en la transcripción final, con una respuesta en 0,13 segundos después del final de la voz, posicionándose como líder. Para la primera transcripción parcial, el error es también de 2,5%, pero con un tiempo de respuesta de 0,12 segundos, lo que lo sitúa en el primer lugar. Los modelos competidores, como Grok Voice Transcribe 2.0 y Muse Voice Transcribe, presentan errores del 2,7% y 3,1% respectivamente, con tiempos de respuesta más lentos. Aunque Cartesia Ink-2 ofrece una respuesta en 0,07 segundos, su precisión se ve comprometida con un error del 4,0%.
El modelo se encuentra en el límite óptimo entre velocidad y precisión, posicionándose en la frontera de Pareto de rendimiento. Su costo es de 0,54 dólares por hora de audio, una tarifa que puede ser relevante para empresas que manejen grandes volúmenes de llamadas o interacciones por voz.
Para inversores y profesionales del sector peruano, esta tecnología ofrece una herramienta clave para automatizar servicios de atención al cliente, gestión de llamadas o incluso procesos de transcripción en entornos empresariales. En un contexto donde el tiempo de respuesta afecta directamente la satisfacción del cliente, esta innovación puede transformar la forma en que las empresas gestionan sus interacciones por voz. Además, su precisión en las primeras etapas permite que las máquinas comiencen a actuar antes de que el usuario termine su mensaje, un avance que podría ser adoptado en sectores como servicios públicos, educación o atención médica.