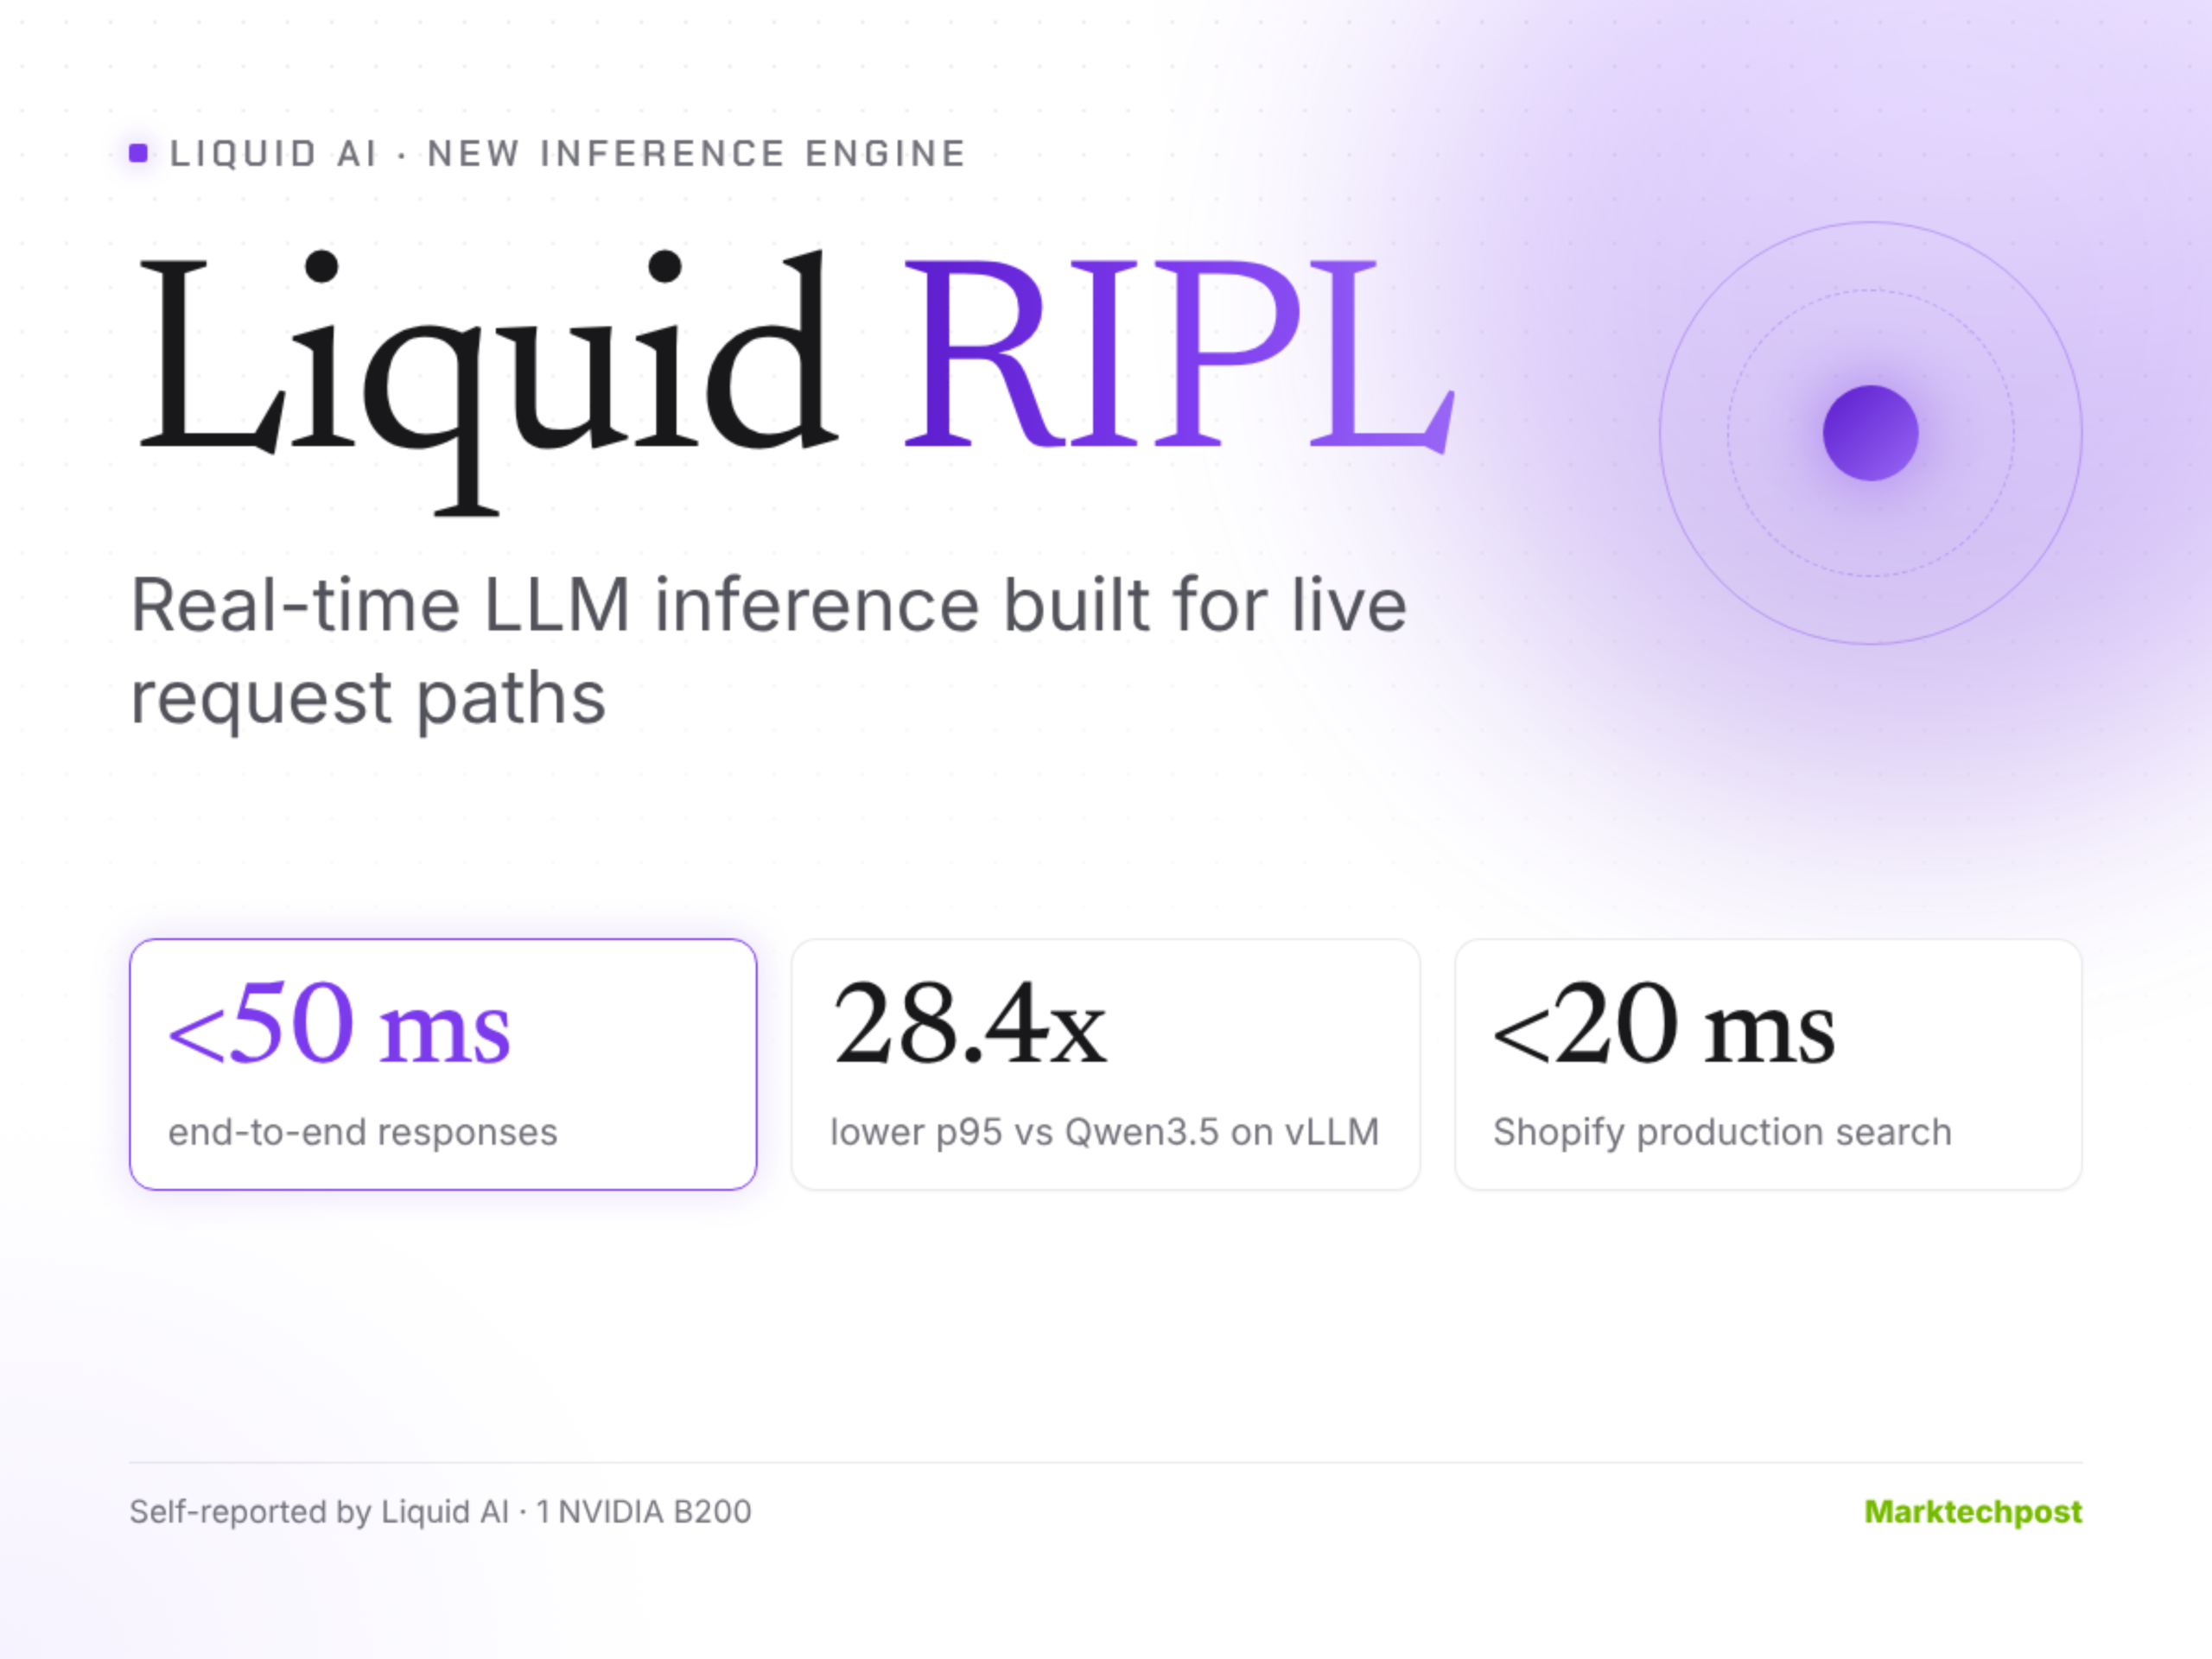
Segun MarkTechPost (AI/ML News), Liquid AI ha presentado RIPL, un motor de inferencia en tiempo real diseñado para entregar respuestas completas en menos de 50 milisegundos. Este sistema opera directamente dentro de la cadena de solicitud, sirviendo modelos de la fundación de Liquid (LFM) desde 230 millones hasta 2.600 millones de parámetros. Su funcionamiento se centra en mantener bajas tasas de latencia incluso bajo cargas máximas, lo que permite que las respuestas se generen en el mismo flujo de petición sin interrupciones. Los resultados obtenidos en pruebas internas muestran que, frente a Qwen3.5 en vLLM, RIPL reduce la latencia p95 entre 5.6 y 28.4 veces. En el caso del modelo LFM2.5-1.2B, la diferencia alcanza los 28.4x: 155.8 milisegundos frente a 4.431 milisegundos del modelo Qwen3.5-0.8B. Aunque en tareas más largas el rendimiento se ve afectado, el sistema no cumple con el límite de 50 ms en solicitudes extendidas.
El diseño de RIPL responde a una necesidad clave en el entorno empresarial: la diferencia entre procesos que requieren respuestas rápidas y aquellos que toleran tiempos más largos. Mientras que las pilas tradicionales están optimizadas para tareas en grandes lotes, como análisis de búsqueda o verificación de fraudes, muchas operaciones en tiempo real necesitan decisiones en milisegundos. Las soluciones basadas en modelos generativos han sido históricamente lentas en estos escenarios, lo que lleva a las empresas a recurrir a modelos clásicos, aunque menos eficaces. RIPL busca eliminar esa barrera, permitiendo integrar inteligencia generativa sin sacrificar la velocidad de respuesta.
Para el lector peruano, este avance representa una oportunidad real en el desarrollo de servicios digitales que operan en entornos de alta demanda. En sectores como banca, comercio electrónico o atención al cliente, donde las decisiones deben tomarse en segundos, el uso de motores como RIPL puede transformar la experiencia. Si una empresa en Lima o Cusco implementa un sistema capaz de responder consultas en menos de medio segundo, puede mejorar significativamente la eficiencia operativa y la satisfacción del usuario. Aunque el costo de infraestructura y el acceso tecnológico aún son factores limitantes, este tipo de innovaciones abre puertas a soluciones más ágiles y personalizadas en el entorno peruano. La clave no está en tener el mejor modelo, sino en tener uno que responda en tiempo real sin comprometer la calidad.