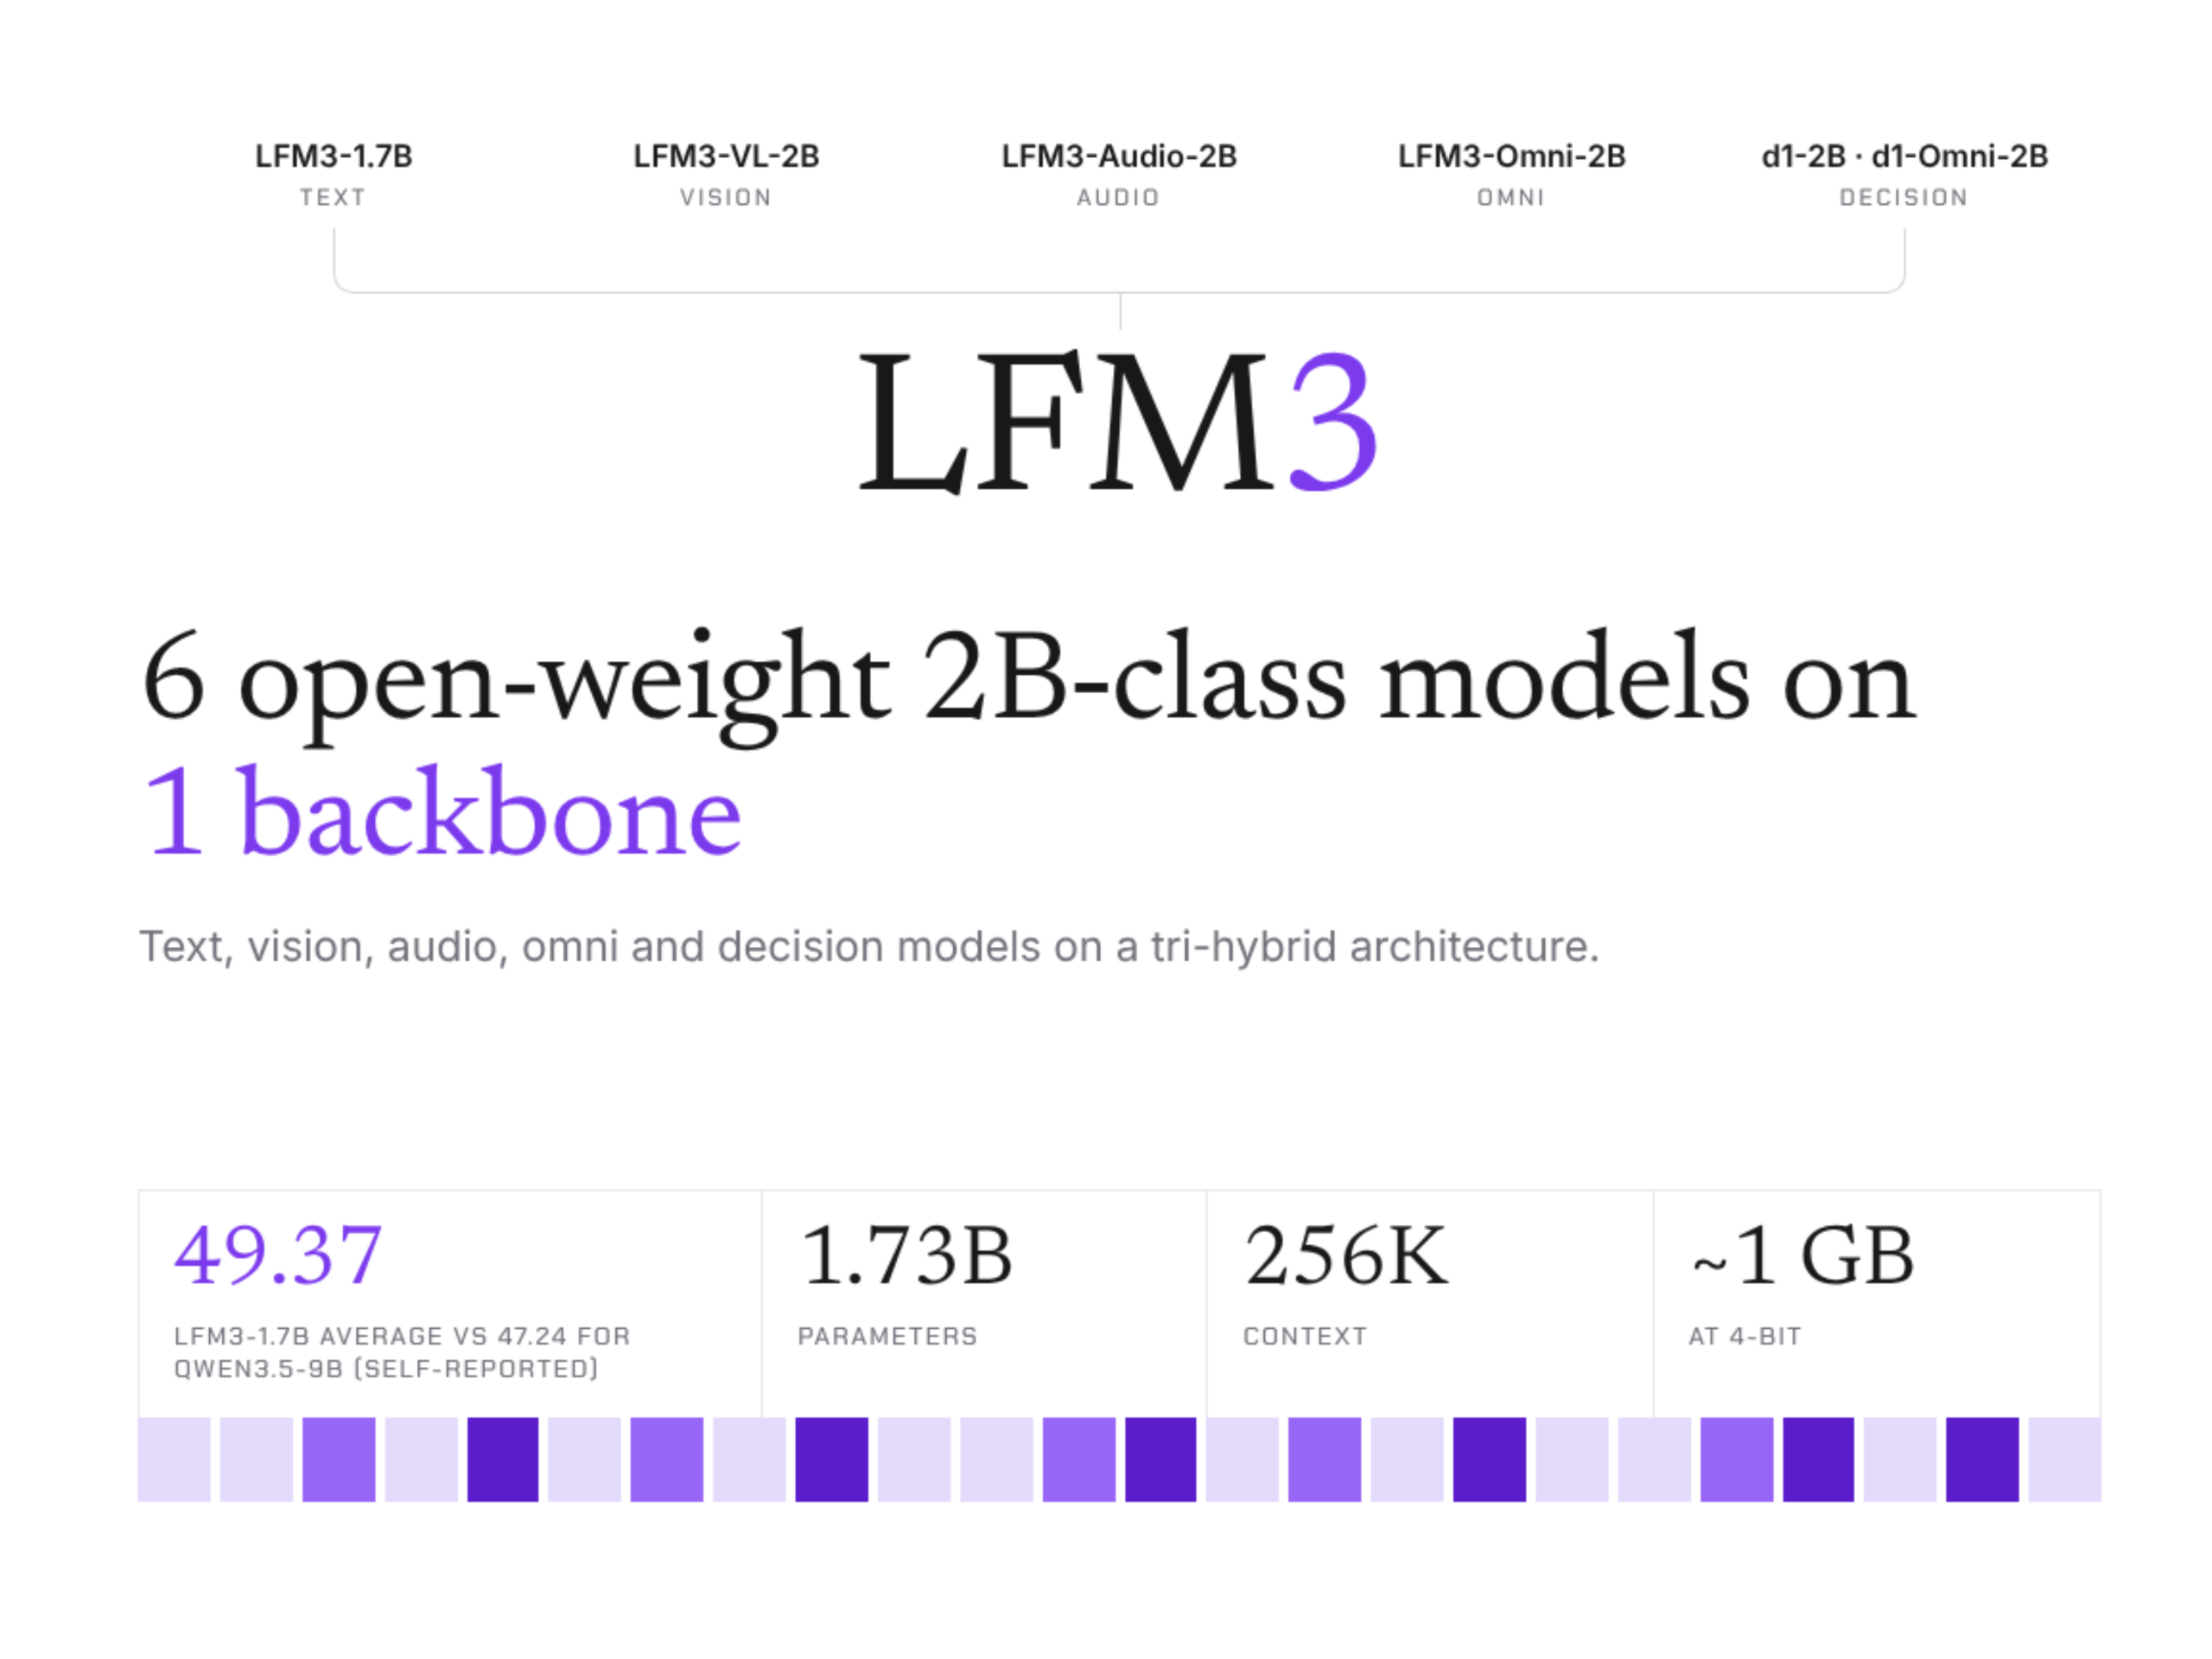
Segun MarkTechPost (AI/ML News), Liquid AI ha presentado LFM3, una nueva generación de modelos de base abierta diseñada para operar de forma eficiente en entornos locales. Esta familia compuesta por seis modelos se construye sobre una sola arquitectura central, permitiendo una escalabilidad modular sin sacrificar rendimiento. Cada uno de los modelos está pensado para cubrir tareas específicas: desde procesamiento de texto y visuales hasta interpretación de audio y toma de decisiones. El tamaño promedio de los modelos oscila entre 1.73 y 2.2 billones de parámetros, con ventajas claras en su capacidad de ejecución en dispositivos con recursos limitados.
La versión textúal, LFM3-1.7B, cuenta con una ventana de contexto de 256 mil tokens, lo que permite manejar documentos largos sin necesidad de fragmentación. El modelo de visión, LFM3-VL-2B, introduce soporte para video con entrada a 2 fotogramas por segundo, mientras que LFM3-Audio-2B soporta múltiples idiomas y permite interacción mediante voz. El modelo omnímodo LFM3-Omni-2B integra lenguaje, audio y visión, ofreciendo respuestas tanto en texto como en voz. Además, se incluyen dos modelos de decisión, d1-2B y d1-Omni-2B, que resuelven múltiples preguntas en una sola pasada, optimizando el uso del tiempo computacional. Todos los modelos están disponibles en formatos como GGUF, MLX, ONNX, FP8 y NVFP4, lo que facilita su implementación en dispositivos desde smartphones hasta servidores privados.
La arquitectura tri-híbrida, que subyace a toda la familia, combina tres operadores distribuidos en 24 capas. Se integran 13 capas de convolución con kernels que crecieron de tamaño 3 a 7, cinco capas de atención por ventana deslizante y seis capas de atención global. La ventana de atención deslizante alcanza 256 tokens, optimizando el equilibrio entre precisión y eficiencia. Estos ajustes permiten que los modelos mantengan altos niveles de rendimiento en tareas complejas, aunque se ejecuten en hardware limitado. En pruebas internas, LFM3-1.7B logra un promedio de 49.37 en 29 benchmarks, superando a Qwen3.5-9B (47.24). Su desempeño destacado se observa en pruebas como IFEval (96.66) y AutomationBench (41.29), mientras que su rendimiento más débil se registra en pruebas sin herramientas, como Humanity’s Last Exam (7.17), y en RULER 128K (65.56), donde queda por debajo del rendimiento de Qwen3.5-9B.
Para los inversionistas y profesionales peruanos, esta evolución en modelos de inteligencia artificial representa una oportunidad para integrar tecnologías de punto de uso en entornos locales. Al no requerir infraestructuras pesadas, los pequeños negocios, emprendedores o entidades públicas pueden comenzar a automatizar tareas como análisis de documentos, reconocimiento de imágenes o atención al cliente, sin depender de servidores remotos. Esto fomenta una digitalización más inclusiva, donde el acceso a herramientas de inteligencia artificial se vuelve más cercano a la realidad diaria de los usuarios del Perú.