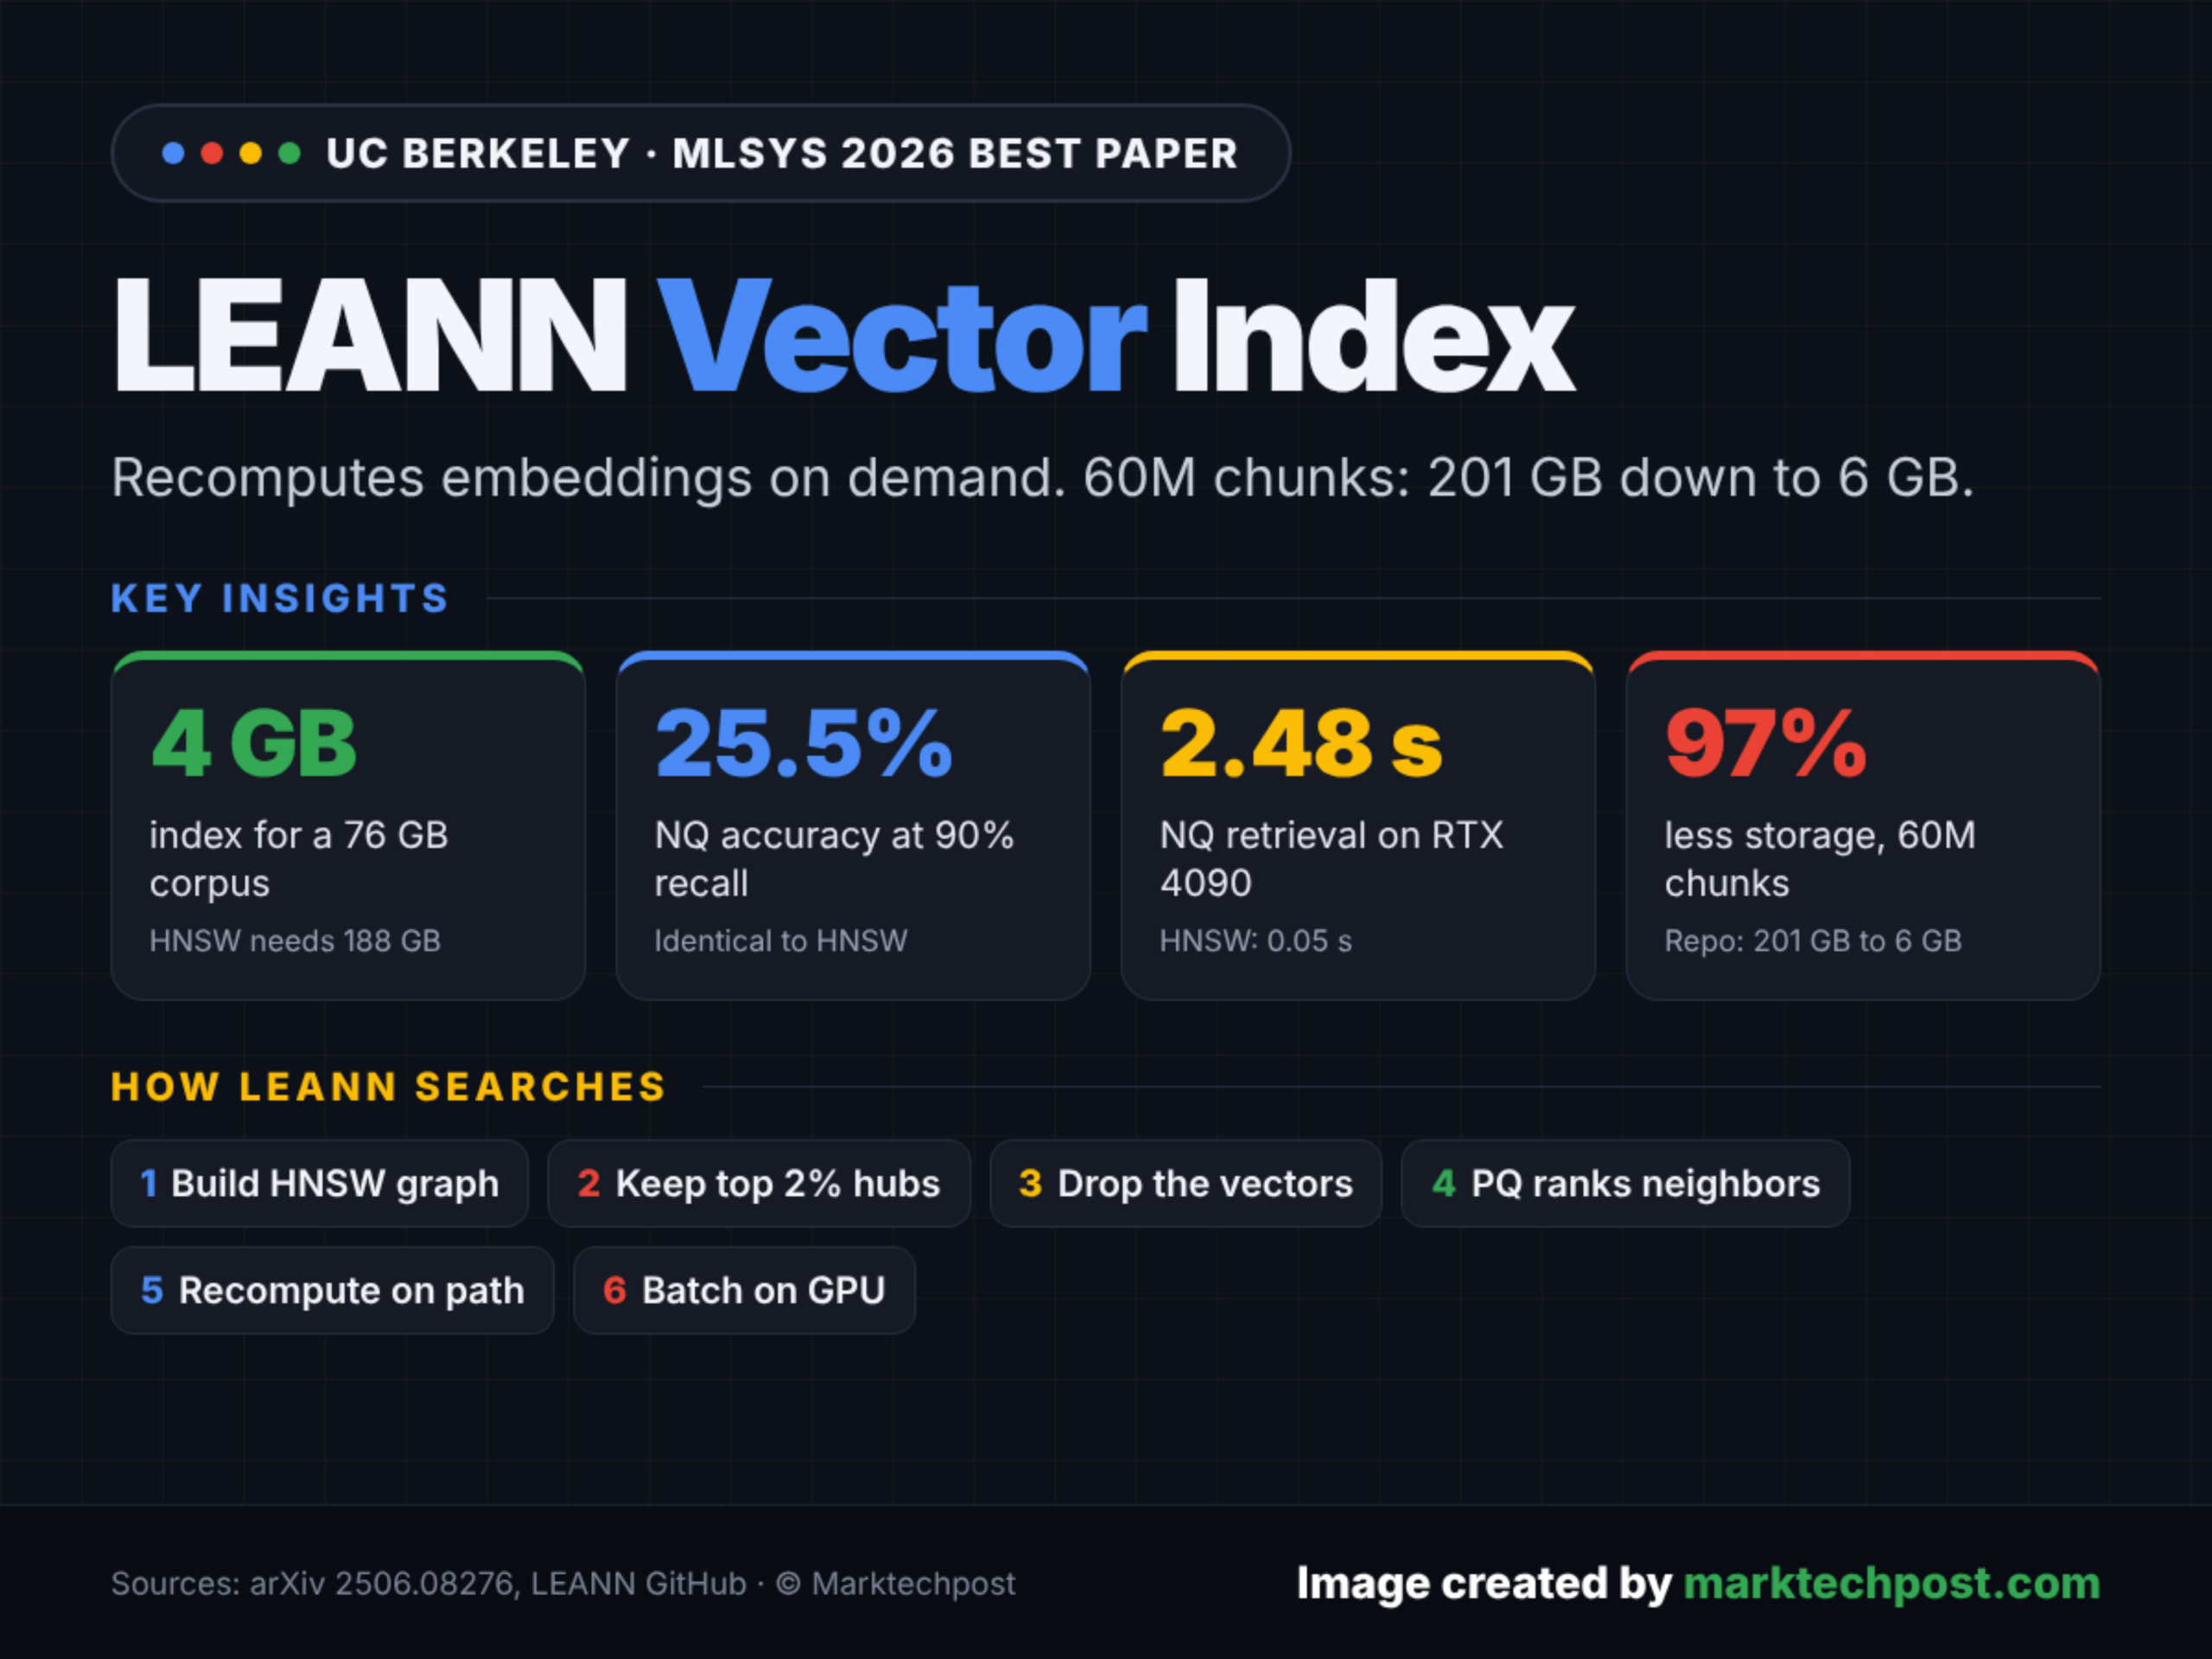
Segun MarkTechPost (AI/ML News), un equipo de investigación de la Universidad de California, Berkeley, ha desarrollado LEANN, un índice vectorial abierto que permite reducir significativamente el espacio de almacenamiento en sistemas de búsqueda semántica. Este avance se centra en resolver un problema clave: que los índices vectoriales suelen ser mucho más grandes que los datos originales que los alimentan. En pruebas específicas, un índice compuesto por 60 millones de fragmentos de Wikipedia, que originalmente requería 201 gigabytes, se reduce a 6 gigabytes mediante LEANN. En una configuración alternativa con 76 gigabytes de datos, el uso de almacenamiento cae a 4 gigabytes, frente a una necesidad previa de 188 gigabytes.
LEANN no almacena los vectores completos de los datos. En su lugar, reconstruye los embeddings al momento de la consulta, utilizando un enfoque basado en grafos y cuantización de productos. Esta estrategia permite mantener una estructura de búsqueda eficiente sin depender de un almacenamiento masivo. El sistema se basa en FAISS, una plataforma de índices de vecinos cercanos, y opera en entornos que van desde equipos de escritorio hasta máquinas de alto rendimiento. Las pruebas se realizaron en una configuración con tarjeta RTX 4090 y 32 gigabytes de RAM, así como en una Mac M1 Ultra. Además, existe una versión que funciona únicamente con procesadores, aunque sin datos públicos sobre su rendimiento en condiciones de CPU.
El rendimiento de LEANN se mantiene competitivo con tecnologías establecidas como HNSW. En pruebas de precisión, alcanza un 90% de recuperación con solo el 5% del almacenamiento bruto del conjunto original. En una evaluación específica, logra una precisión de 25,5% en tareas de recuperación, equivalente a HNSW, pero utilizando solo 4 gigabytes en lugar de 188 gigabytes. Sin embargo, existen limitaciones: en el escenario de evaluación HotpotQA, el tiempo de ejecución en una Mac alcanza 44,80 segundos, representando el 50,1% del tiempo total del proceso.
Para el lector peruano, esta innovación es particularmente relevante en un contexto de acceso limitado a infraestructuras tecnológicas. Muchos usuarios, especialmente en entornos con recursos económicos reducidos, no pueden permitirse servidores de alto rendimiento o almacenamiento masivo. LEANN permite que aplicaciones de búsqueda semántica, como las que se usan en asistentes personales o sistemas de recomendación, funcionen directamente en equipos domésticos. Esto implica que, sin necesidad de grandes inversiones tecnológicas, se puede implementar inteligencia artificial en procesos de recuperación de información, incluso sobre datos personales. El modelo, disponible bajo licencia MIT y accesible mediante comandos simples como `uv pip install leann`, abre la puerta a una mayor democratización del uso de inteligencia artificial en entornos locales.