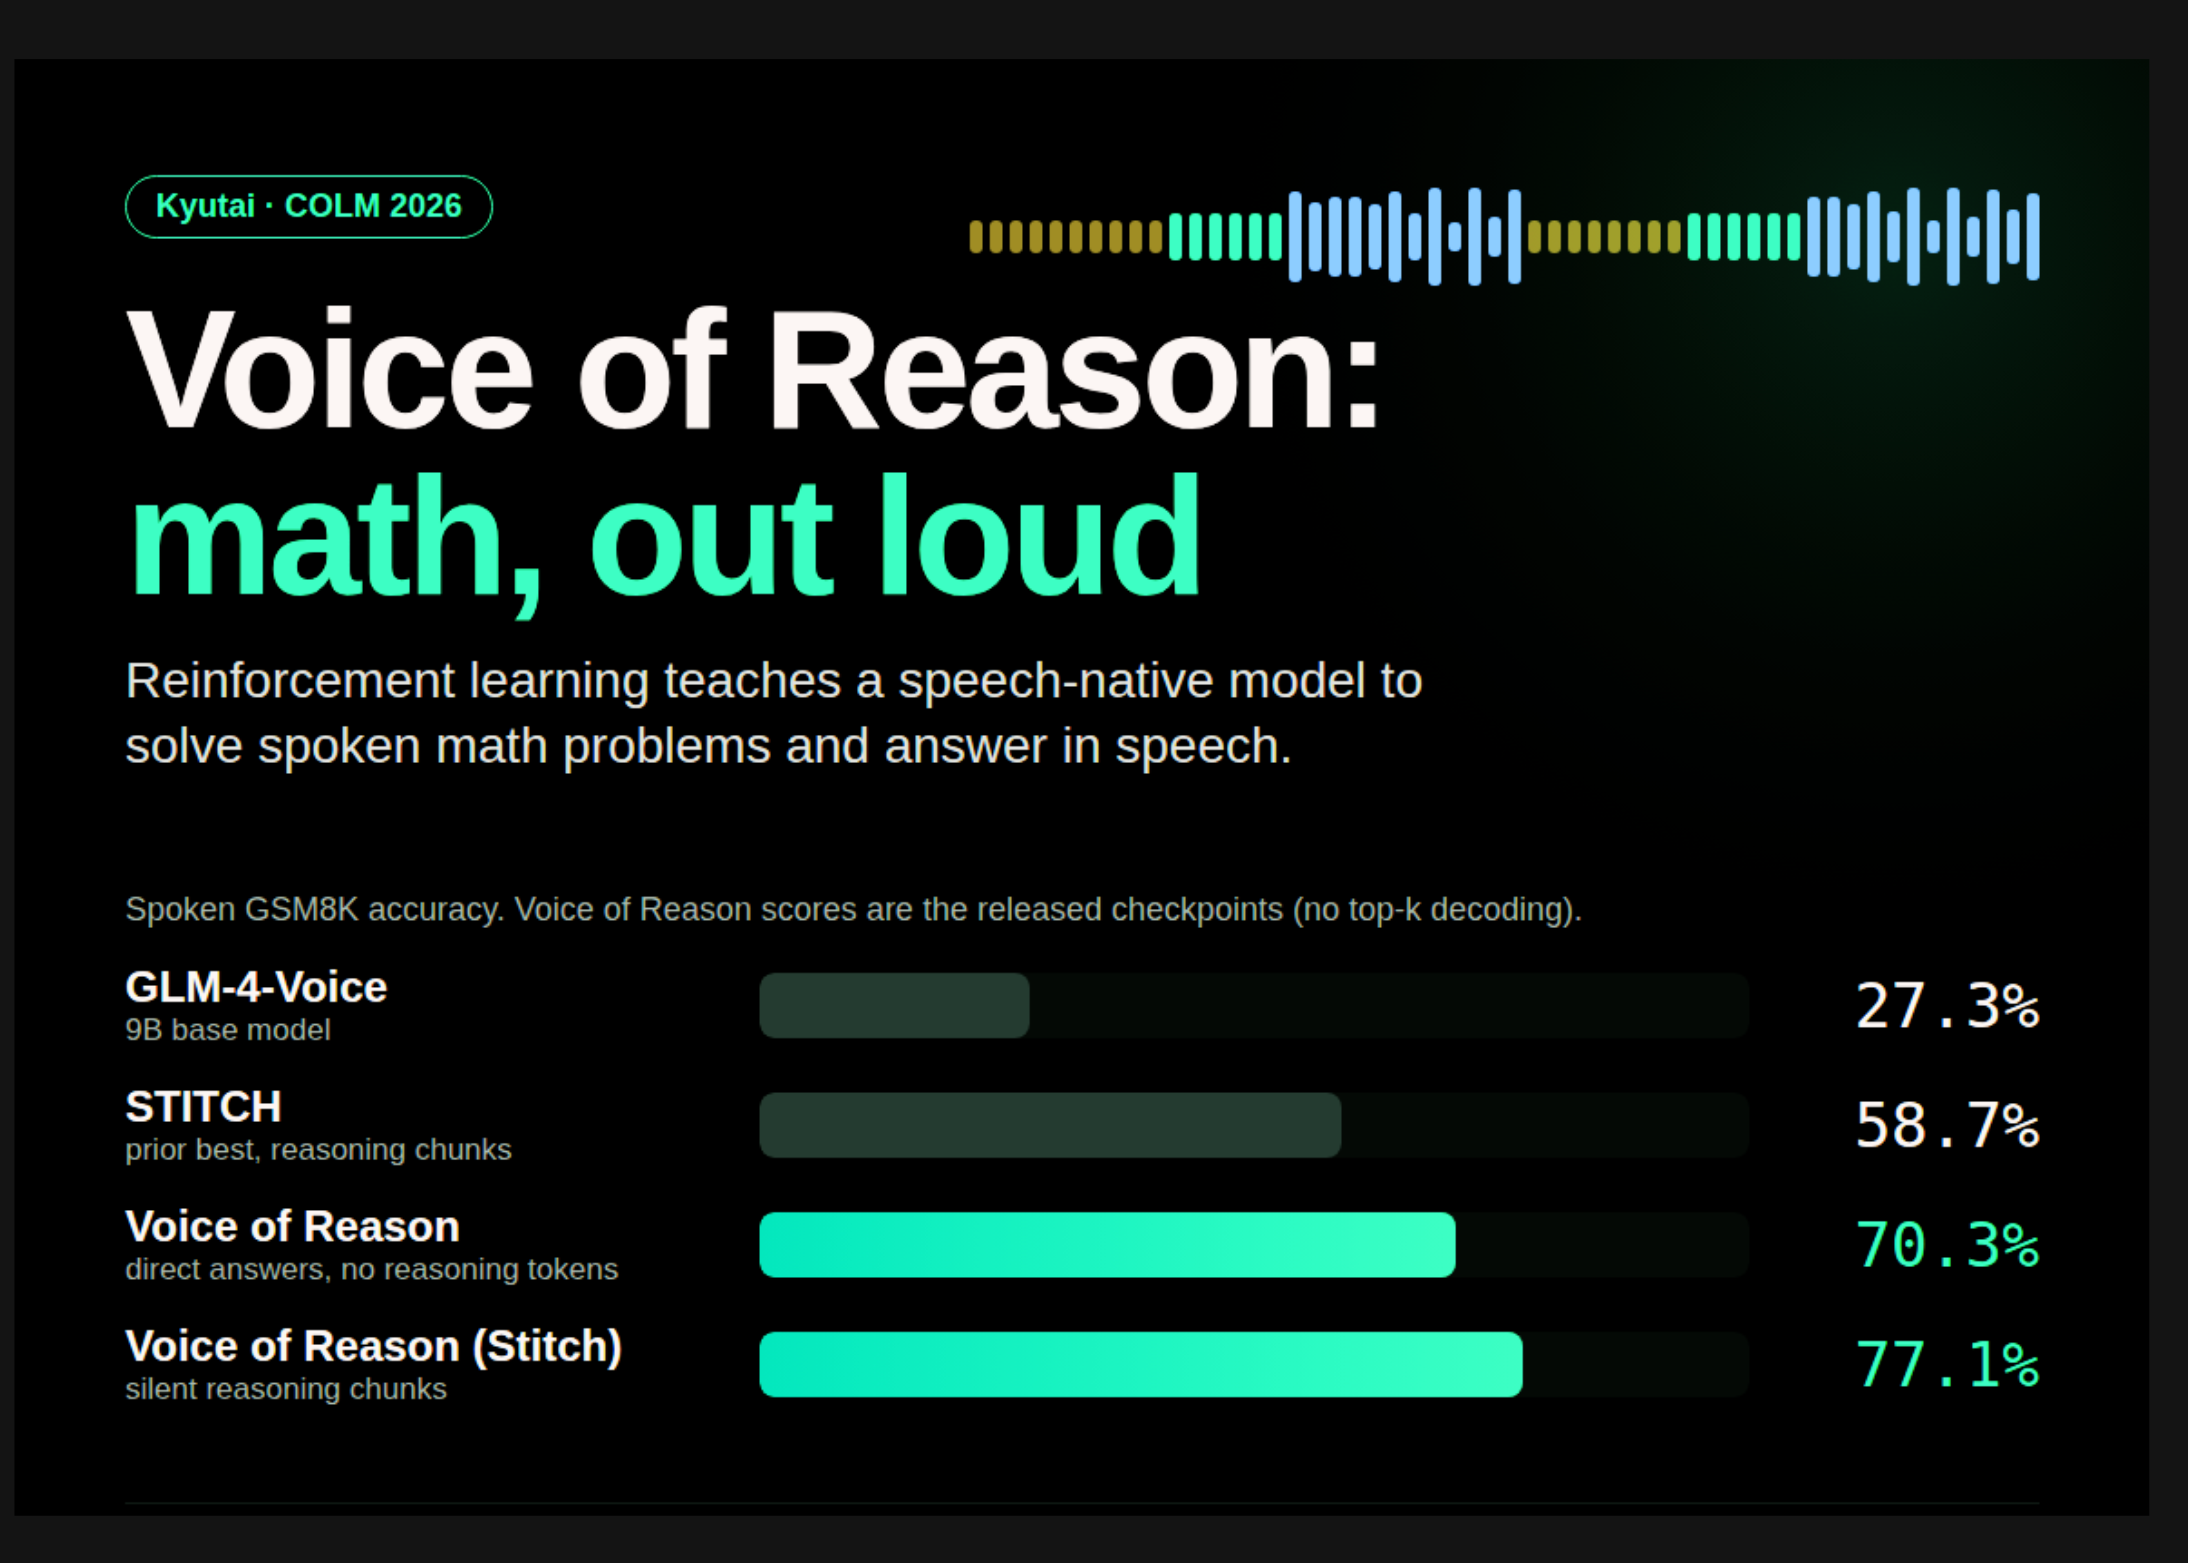
Segun MarkTechPost (AI/ML News), Kyutai ha presentado "Voice of Reason", un nuevo modelo de inteligencia artificial que resuelve problemas matemáticos directamente en voz, sin intermedios. Este sistema, basado en GLM-4-Voice-9B, combina entrenamiento supervisado y aprendizaje por refuerzo para mejorar su capacidad de razonamiento. La innovación radica en que el modelo genera respuestas en audio desde el inicio, eliminando pasos de transcripción y dependencia de un modelo de lenguaje textuales separados. En pruebas con el conjunto GSM8K, la precisión aumenta de un 27.3% en la versión base a un 77.1% tras el entrenamiento avanzado.
El modelo opera mediante una secuencia intercalada de tokens: primero 13 de texto, seguido por 26 de audio, repetida en ciclos. En la fase de entrenamiento inicial, se utilizan 150.616 ejercicios extraídos de Orca-Math. Cada problema es reescrito en formato de voz por Qwen3-235B, luego se convierte a audio mediante el sistema de síntesis de Kyutai, que emite voces variadas. Este proceso de entrenamiento supervisado eleva la precisión del modelo desde el 27.3% hasta el 61.7%. En la etapa posterior, el sistema aplica aprendizaje por refuerzo: para cada pregunta escuchada, el modelo genera cuatro respuestas con una temperatura de 0.9. Una evaluación automatizada, basada en Qwen3-235B-A22B-2507, califica cada respuesta en escala binaria sin tener acceso a la solución correcta. En 100 casos revisados manualmente, esta evaluación coincide con el juicio humano en un 88% de los casos.
Este avance marca una ruptura en el paradigma tradicional de los modelos de lenguaje. Los sistemas anteriores, que pasan de voz a texto y luego a audio, pierden información acústica como el tono o el entusiasmo. Al generar audio en tiempo real, los modelos de razonamiento en voz deben mantener una interacción continua, lo que limita el número de pasos internos que pueden ejecutar. La investigación de Kyutai representa la primera aplicación de aprendizaje por refuerzo en razonamiento matemático dentro de un modelo nativo de voz.
Para el lector peruano, este desarrollo sugiere una posible evolución en herramientas educativas. En contextos donde el acceso a dispositivos con conectividad o a aplicaciones de texto es limitado —como en zonas rurales o escuelas con infraestructura básica—, un modelo que resuelve problemas matemáticos directamente en voz podría facilitar el aprendizaje. Sin necesidad de traducir o convertir datos, el alumno podría escuchar soluciones en tiempo real, lo que potencialmente mejora la comprensión y la motivación. Aunque aún no se ofrecen servicios de inferencia públicos, el modelo puede ser deployado en entornos locales, especialmente si se integra en plataformas educativas o dispositivos móviles. La clave está en su accesibilidad, no en su complejidad técnica.