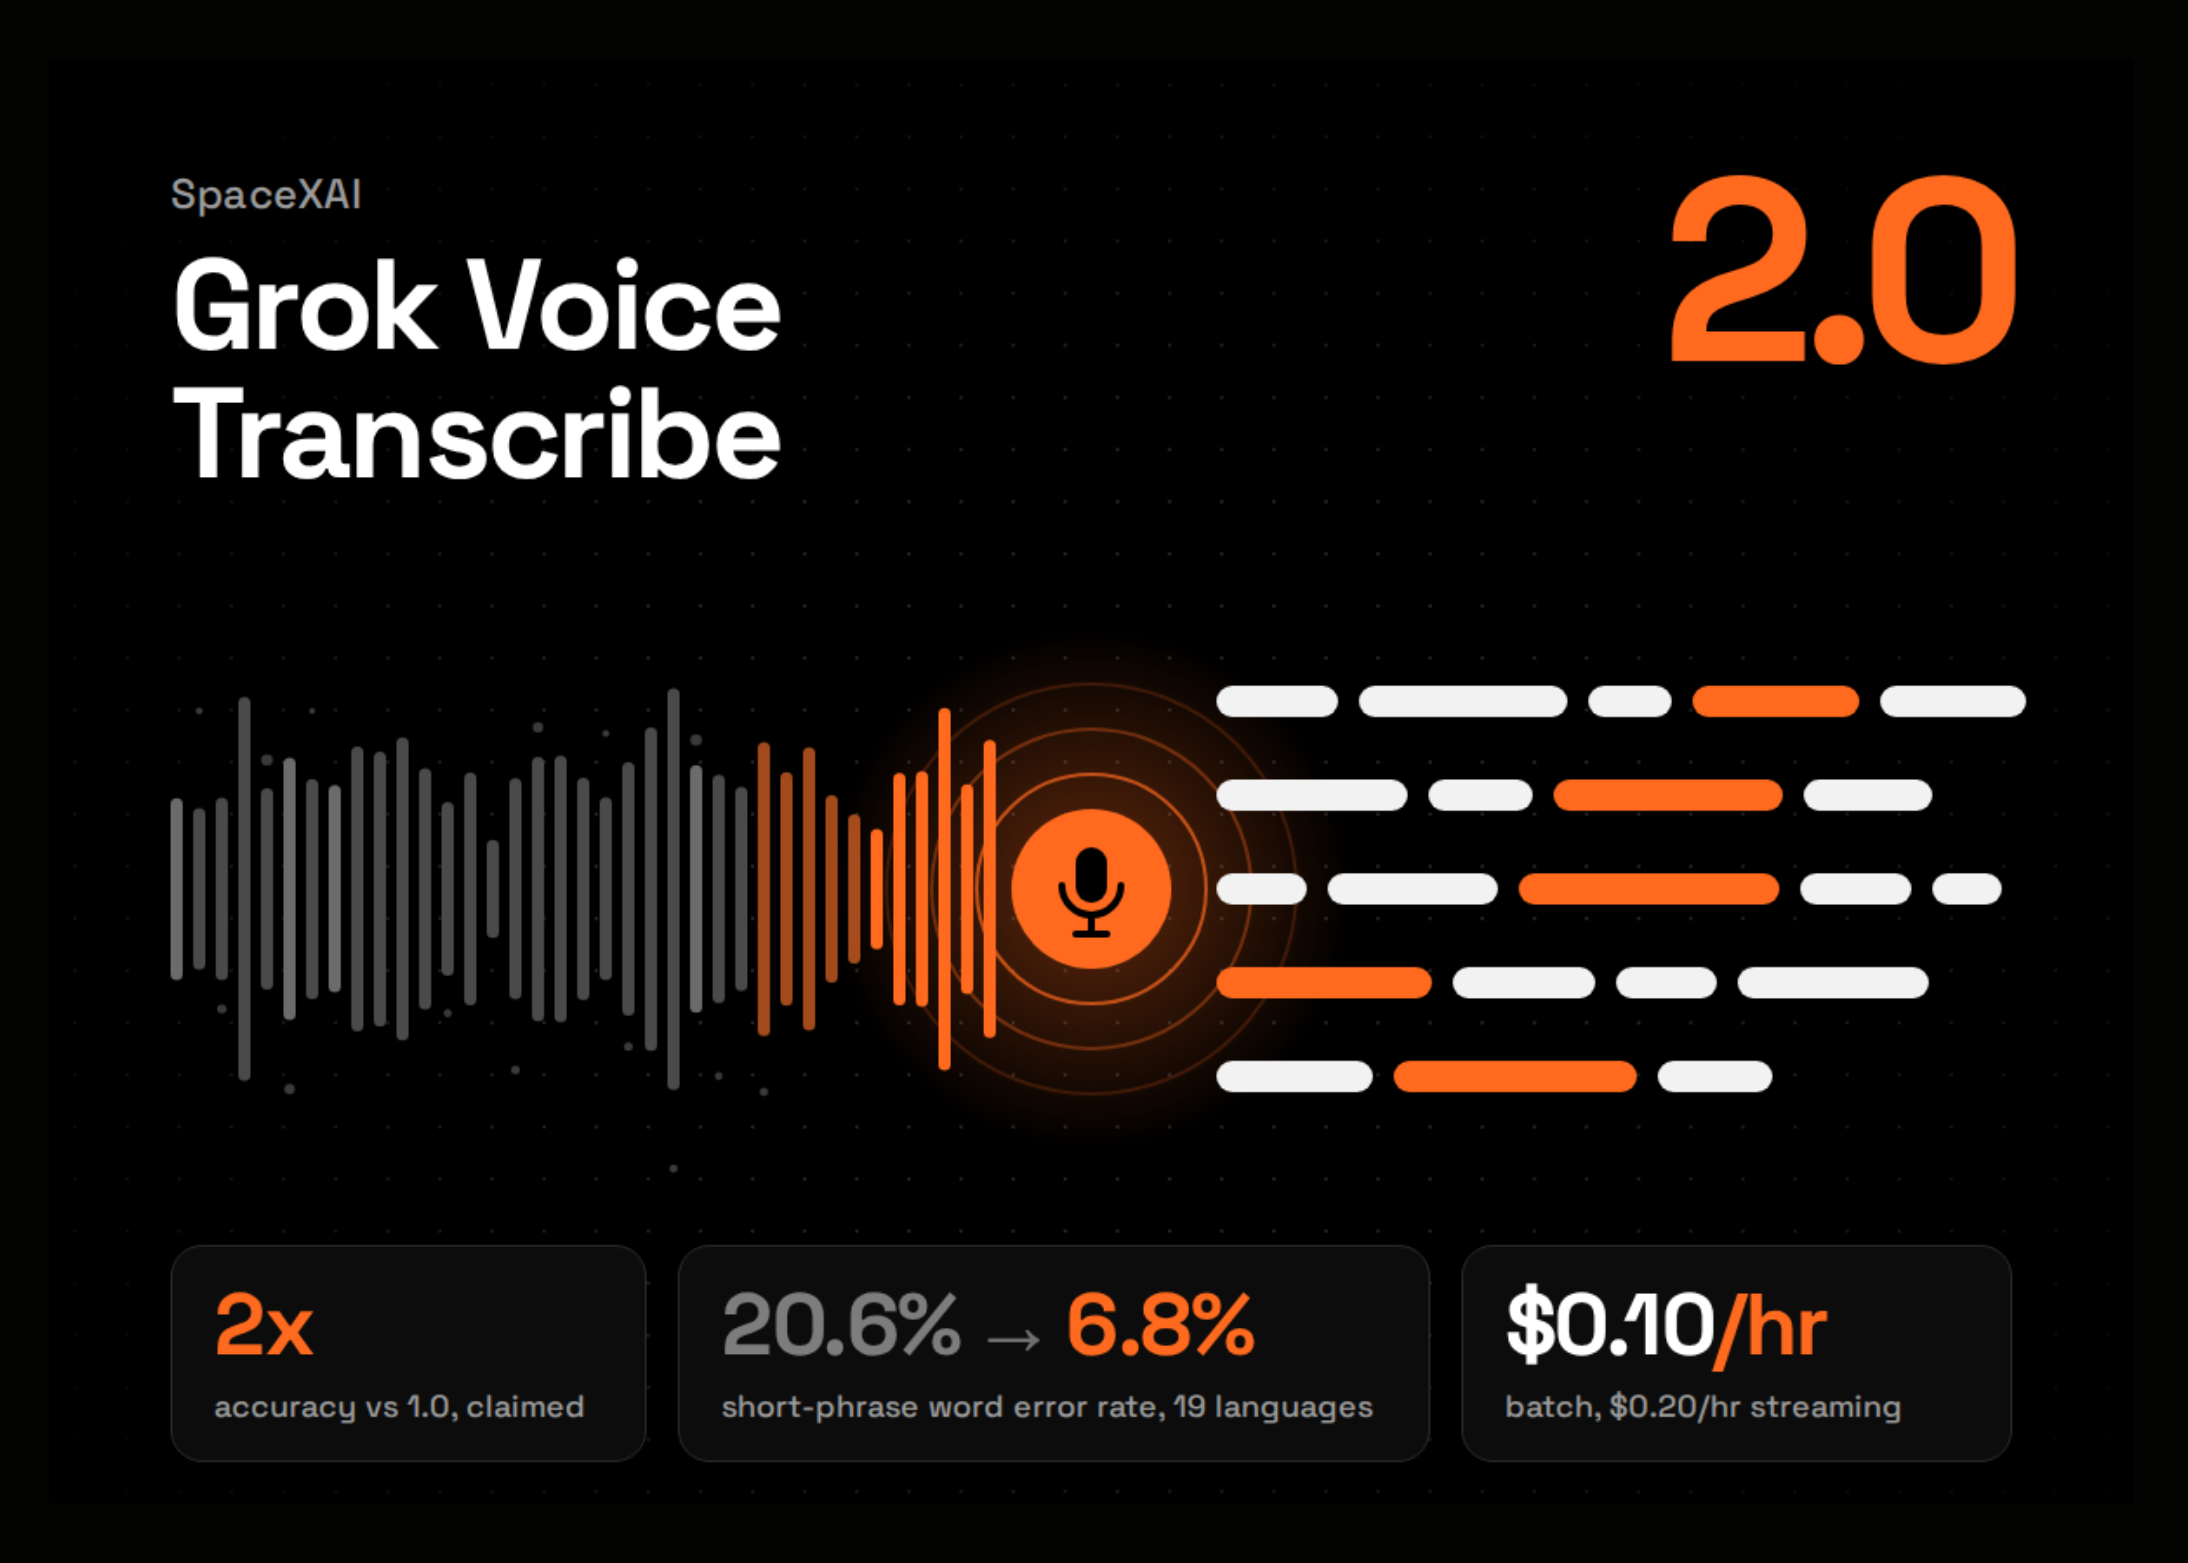
Segun MarkTechPost (AI/ML News), SpaceXAI ha lanzado Grok Voice Transcribe 2.0, una actualización de su modelo de conversión de voz a texto. Este nuevo sistema asegura una precisión duplicada en comparación con la versión inicial, manteniendo el mismo costo de 0.10 dólares por hora. La tecnología está diseñada para manejar sonidos complejos, como líneas telefónicas ruidosas, voces superpuestas, acentos locales y datos orales como números o correos. Opera en dos modos: en batch y en streaming real time, a través de una API pública. Actualmente, el modelo está disponible bajo la identificación grok-voice-transcribe-2.0, aunque no se ha anunciado su disponibilidad en formato abierto, lo que excluye su uso en entornos autónomos.
El desarrollo se basa en el modelo de audio fundamental detrás de Grok Voice, que ya procesa decenas de miles de llamadas de atención al cliente diariamente. Además, se emplea en la transcripción de millones de horas de narraciones de video y en la ejecución del asistente Grok dentro de vehículos Tesla. Los datos de entrenamiento provienen de audio en vivo, ruidoso y multilingüe, capturado en diversos entornos. Posteriormente, el equipo de SpaceXAI aplicó refinamientos mediante entrenamiento post-entrenamiento para optimizar el rendimiento. Los resultados se validan en pruebas públicas, donde Grok Voice Transcribe 2.0 ocupa el primer lugar en el leaderboard de precisión de análisis de audio, conocido como AA-WER Streaming. Este test utiliza aproximadamente ocho horas de audio y combina datos de tres fuentes: AA-AgentTalk (50%), VoxPopuli (25%) y Earnings22 (25%). Los resultados internos, aunque reportados por el proveedor, no han sido verificados independientemente.
En pruebas internas, el modelo supera a todos los otros modelos probados por SpaceXAI en cuatro conjuntos de datos: llamadas telefónicas en inglés (8 kHz), conversaciones cotidianas, extracción de credenciales como correos o números y frases breves en 19 idiomas. En el caso de las llamadas telefónicas, el sistema lidera todos los modelos evaluados por la empresa. A pesar de su alta eficiencia, no se han proporcionado datos de rendimiento en entornos multilingües o bajo condiciones de ruido extremo fuera del entorno de prueba.
Para los usuarios peruanos, esta evolución en tecnologías de voz representa una oportunidad clave. El sector de servicios, como atención al cliente en empresas locales o el uso de asistentes digitales en entornos ruidosos, podría beneficiarse de un sistema que interprete mejor voces en acentos diversos. Aunque aún no está disponible para uso personalizado, su integración en plataformas empresariales puede mejorar la experiencia de usuario en entornos donde la claridad del habla es un desafío constante. La precisión y el costo bajo hacen que este modelo sea especialmente atractivo para pequeñas y medianas empresas que buscan soluciones escalables y económicas.