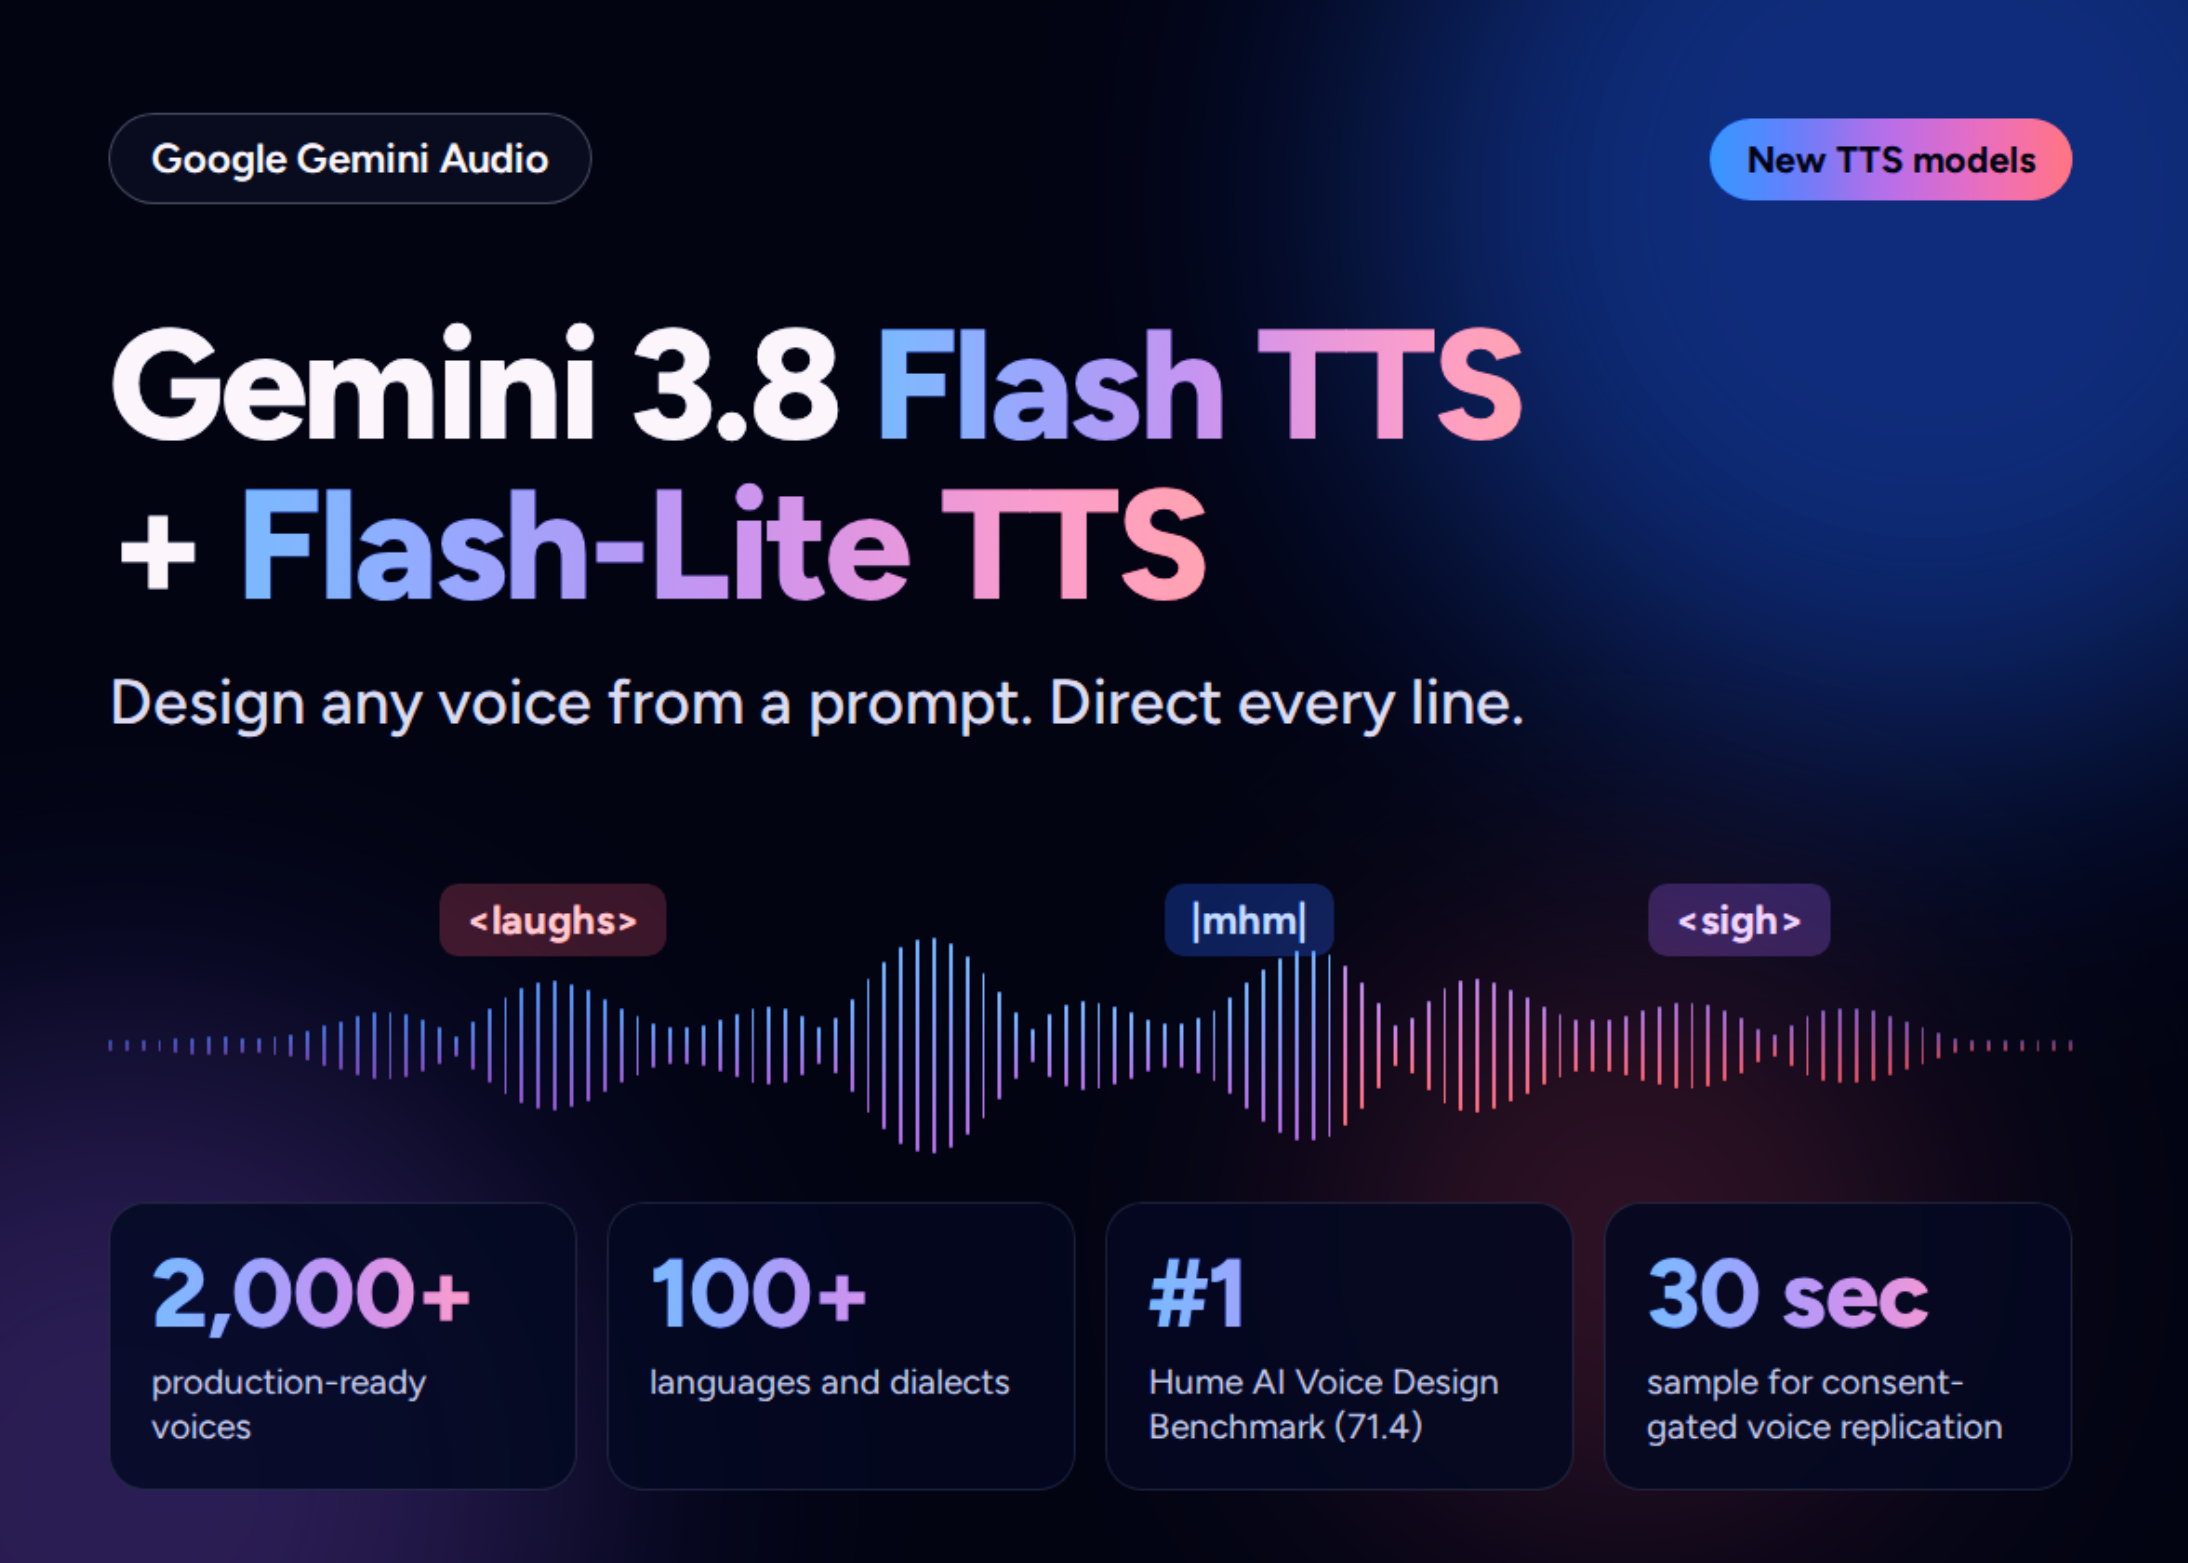
Según MarkTechPost (AI/ML News), Google ha presentado dos nuevos modelos de síntesis de voz dentro de su familia Gemini Audio: Gemini 3.8 Flash TTS y Gemini 3.8 Flash-Lite TTS. Estas herramientas, lanzadas el 23 de septiembre de 2026, representan el avance más expresivo hasta la fecha en la generación de audio mediante inteligencia artificial. Cada modelo se posiciona en un escenario distinto: el primero, diseñado para creatividad profunda, atiende necesidades de personalización extrema; el segundo, enfocado en escalabilidad y eficiencia operativa, optimiza el uso de recursos en producciones masivas.
El modelo Flash TTS se dirige a aplicaciones que requieren personalización avanzada, como narrativas interactivas, podcasts inmersivos o contenidos audiovisuales de juego. Permite al desarrollador establecer, línea por línea, indicaciones detalladas sobre el tono, cambios de acento, pausas y reacciones verbales. Este sistema permite crear voces originales a partir de prompts que describen rol, acento y características de voz, operando en más de 100 idiomas y variantes regionales. Entre sus demostraciones se incluyen un DJ de Melbourne, un robot monocorde y un dragón japonés. Los desarrolladores también acceden a una biblioteca de más de 2.000 voces ya producidas, que abarcan variantes como el español mexicano, el francés canadiense y el inglés escocés.
Por su parte, el modelo Flash-Lite TTS se enfoca en entornos de alto volumen donde la eficiencia económica es clave. Es ideal para tareas como subtítulos, creación de contenido audio y agentes virtuales expresivos. Ofrece un control fino sobre el tono, ritmo y matices emocionales, sin sacrificar el rendimiento. Ambos modelos están disponibles actualmente a través de la API de Gemini y Google AI Studio, aunque la opción de autogestión local (self-hosting) no está disponible. El acceso empresarial a través de Gemini Enterprise se anuncia como disponible en próximos meses.
El desarrollo de estas herramientas marca una transición en cómo las aplicaciones digitales pueden integrar voces humanas sin necesidad de personalización física. Para el lector peruano, esto implica nuevas posibilidades en el diseño de contenidos educativos, servicios de atención al cliente o plataformas de comunicación digital. Aunque el acceso se limita a entornos técnicos, la capacidad de generar voces personalizadas en idiomas locales —como el español peruano— abre puertas a soluciones más inclusivas y accesibles. Así, empresas que buscan diferenciarse mediante experiencias de voz más naturales pueden comenzar a explorar estas tecnologías sin necesidad de invertir en infraestructura especial. El futuro de la comunicación digital en el Perú podría estar más cerca de lo que imaginamos, gracias a avances en inteligencia artificial que ya se encuentran en desarrollo.