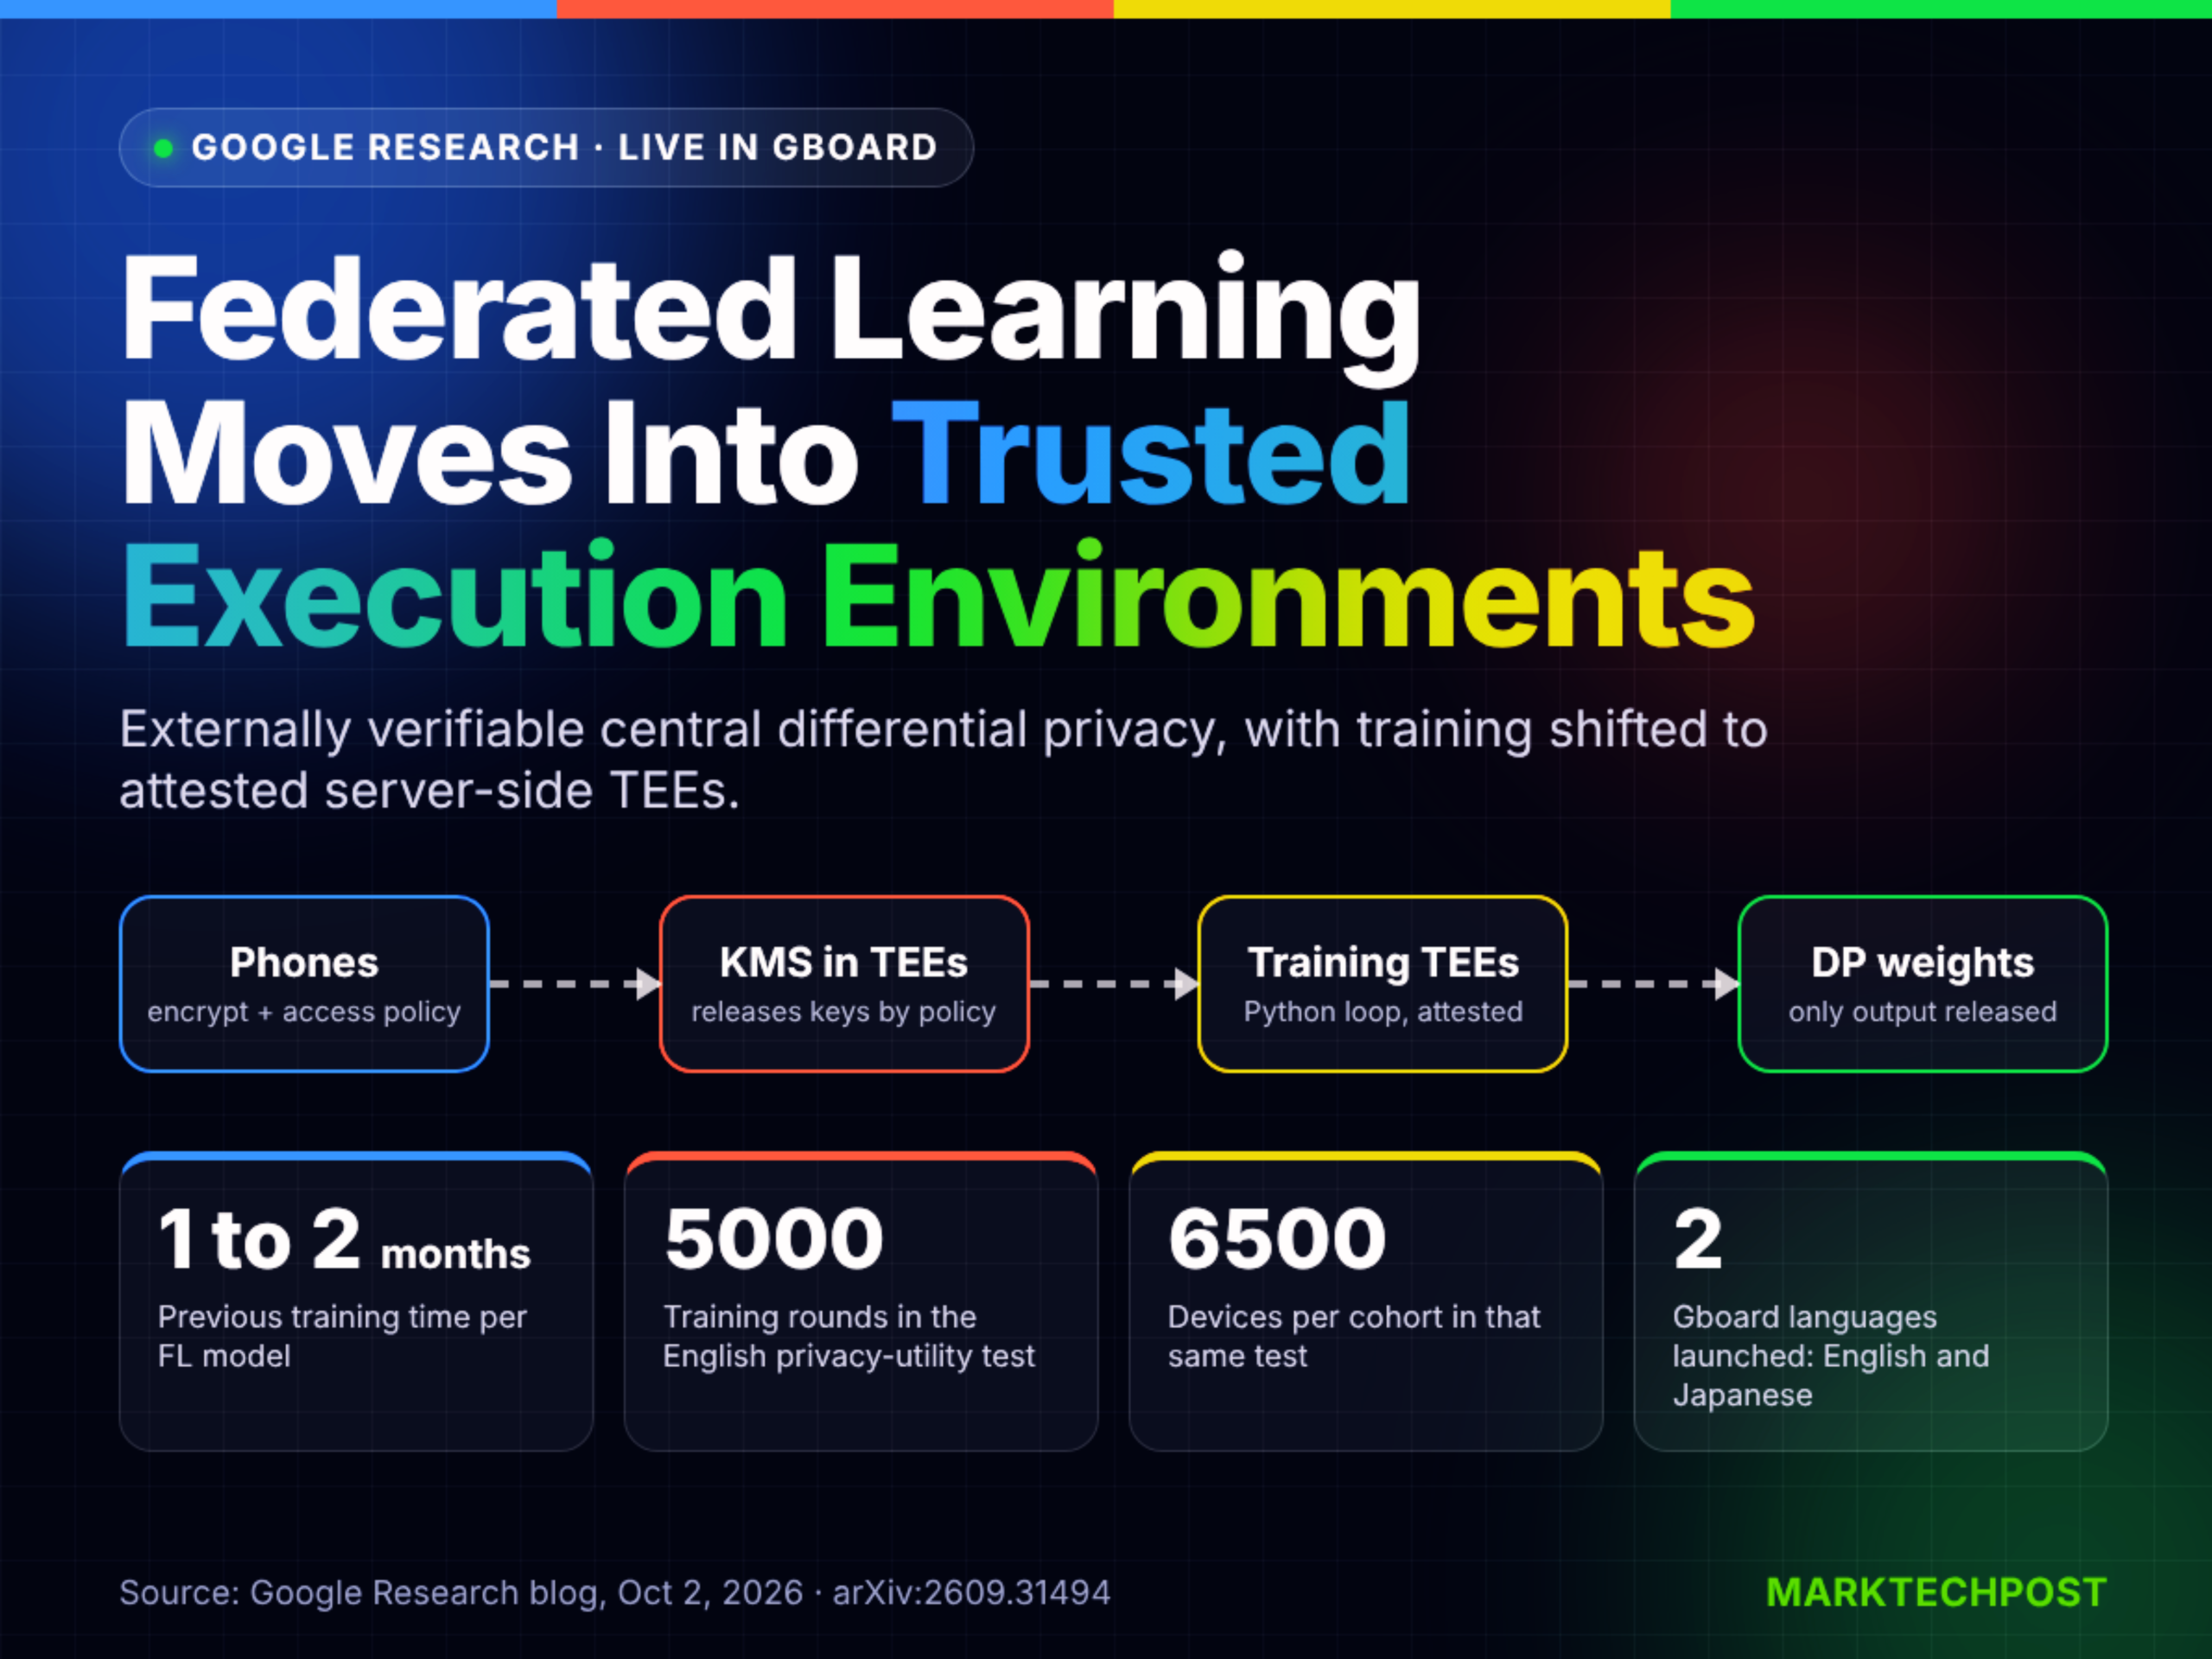
Segun MarkTechPost (AI/ML News), Google ha desarrollado un nuevo sistema de aprendizaje federado (FL) basado en entornos de ejecución confiables (TEEs), que ofrece garantías de privacidad verificable desde fuera. Este avance, anunciado el 4 de octubre de 2026, representa una evolución clave en cómo se manejan los datos en dispositivos móviles, especialmente en aplicaciones como Gboard, donde se usan para predecir palabras y sugerir respuestas en mensajes.
El modelo original de aprendizaje federado, lanzado en 2017, permitía que los dispositivos enviara datos para entrenar modelos sin compartirlos directamente. Sin embargo, existía un vacío de confianza: aunque los datos se procesaban localmente, terceros no podían asegurar que no fueran almacenados o analizados por el proveedor. Aunque se introdujeron mecanismos criptográficos de agregación, estos no eran compatibles con algoritmos modernos de privacidad central, como el DP-FTRL. Además, el proceso dependía de que Google aplicara correctamente el ruido de privacidad, lo que generaba una brecha en la confiabilidad.
La innovación actual desplaza el cálculo de gradientes desde los dispositivos hasta servidores, y luego asegura que el código ejecutado en esos servidores sea verificable. Esto significa que el operador del sistema ya no necesita ser confiable. La arquitectura se sustenta en cuatro pilares: primeramente, los dispositivos cifran ejemplos de entrenamiento y definen políticas de acceso que especifican qué operaciones dentro de un TEE pueden procesar los datos. Estas políticas se registran públicamente para garantizar transparencia. Luego, un sistema de gestión de claves (KMS) construido sobre TEEs y el protocolo RAFT solo entrega claves a tareas que cumplen con esas políticas. Un TEE raíz ejecuta un bucle de entrenamiento en Python, delegando tareas a TEEs secundarios. El control de flujo se basa en un lenguaje especializado, derivado de TensorFlow Federated. Solo se publican los pesos del modelo ajustado, sin revelar datos originales. Finalmente, cada iteración guarda un estado de recuperación cifrado por KMS, permitiendo reactivar el proceso ante fallos en el sistema.
Para el lector peruano, esta evolución tiene un impacto directo en la forma en que las empresas manejan datos personales en entornos digitales cotidianos. En un contexto donde el uso de aplicaciones móviles es masivo y las preocupaciones por el uso indebido de datos crecen, esta tecnología ofrece una alternativa más sólida para proteger la información de los usuarios. Aunque aún no se ha implementado en todos los servicios, el avance señala que los sistemas de inteligencia artificial están avanzando hacia soluciones que no solo aprenden de los usuarios, sino que también cumplen con estándares de transparencia y verificación externa. Esto puede impulsar la confianza de los consumidores en aplicaciones clave como mensajería, navegación y servicios financieros digitales.