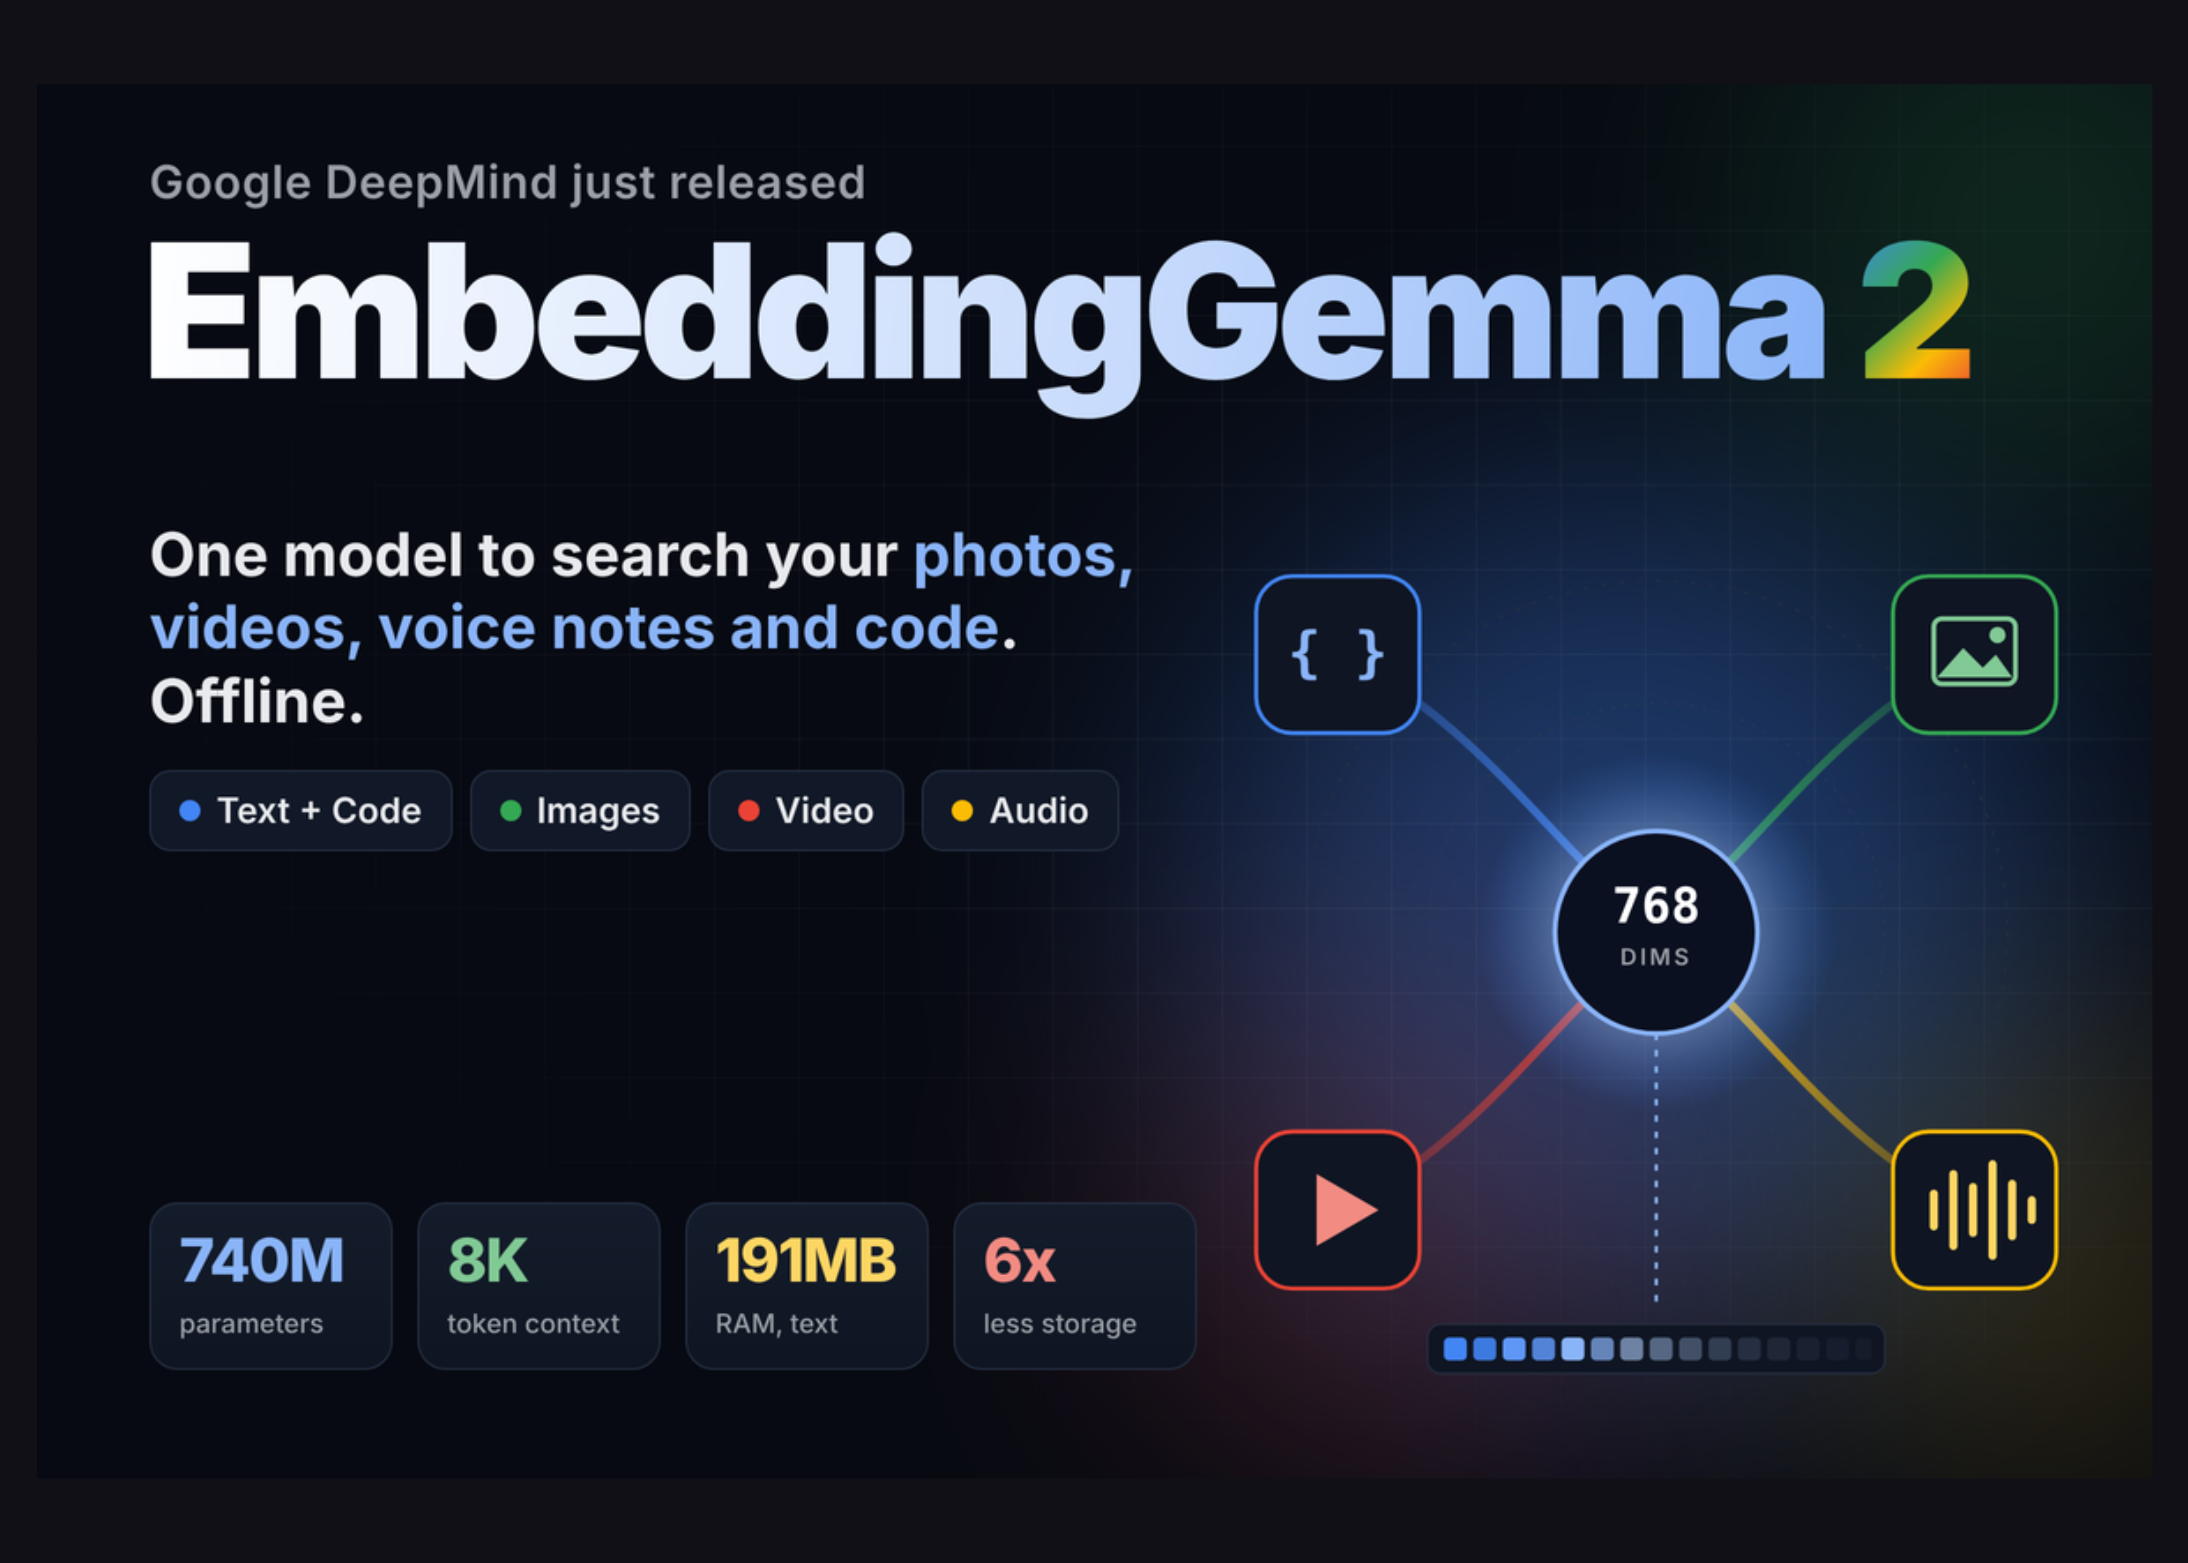
Segun MarkTechPost (AI/ML News), Google DeepMind ha presentado EmbeddingGemma 2, un modelo abierto multimodal que convierte textos, códigos, imágenes, videos y audios en un espacio vectorial de 768 dimensiones. Este modelo, con 740 millones de parámetros, cuenta con una ventana de contexto de 8.192 tokens —un 400% más que su versión anterior— y se regula bajo licencia Apache 2.0. Su diseño permite integrar diferentes tipos de datos en un único espacio vectorial, facilitando búsquedas, clasificaciones y aplicaciones de recuperación de información en tiempo real. La capacidad de procesar contenidos heterogéneos de forma modular permite que desarrolladores elijan solo los componentes necesarios: desde 270 millones de parámetros para texto puro, hasta 740 millones para integrar todos los modos. Así, una consulta basada en texto puede coincidir con documentos generados por el modelo completo, sin necesidad de reentrenar ni duplicar estructuras.
El modelo está disponible de forma inmediata en plataformas como Hugging Face y Kaggle, además de ofrecer versiones optimizadas para entornos locales mediante Ollama, llama.cpp (GGUF) y LiteRT. Este enfoque permite ejecutar procesos de embeddings directamente en dispositivos, reduciendo latencia, protegiendo la privacidad al mantener los datos fuera de servidores centrales y funcionando sin conexión a internet. La arquitectura se basa en Gemma 4, lo que garantiza estabilidad y eficiencia en tareas de procesamiento de lenguaje y visuales. Los resultados de validación se basan en pruebas de laboratorio del equipo de investigación de Google, aunque no se detallan métricas específicas en el informe original.
Para el lector peruano, esta innovación tiene implicaciones directas en el acceso a tecnologías de inteligencia artificial de bajo costo y alta flexibilidad. En un contexto donde muchas empresas aún enfrentan barreras de entrada en el uso de IA, modelos como EmbeddingGemma 2 ofrecen una alternativa viable para pequeñas y medianas empresas. Pueden implementar soluciones de búsqueda interna, gestión de documentos o análisis de productos sin depender de servicios en la nube. Además, al permitir el procesamiento local, se reduce el riesgo de exposición de información sensible, un factor crítico en sectores como el comercio, la salud o la educación. Aunque aún se requieren pruebas de campo para evaluar su rendimiento en entornos reales, el lanzamiento marca un paso hacia una IA más accesible, descentralizada y adaptada a necesidades locales.