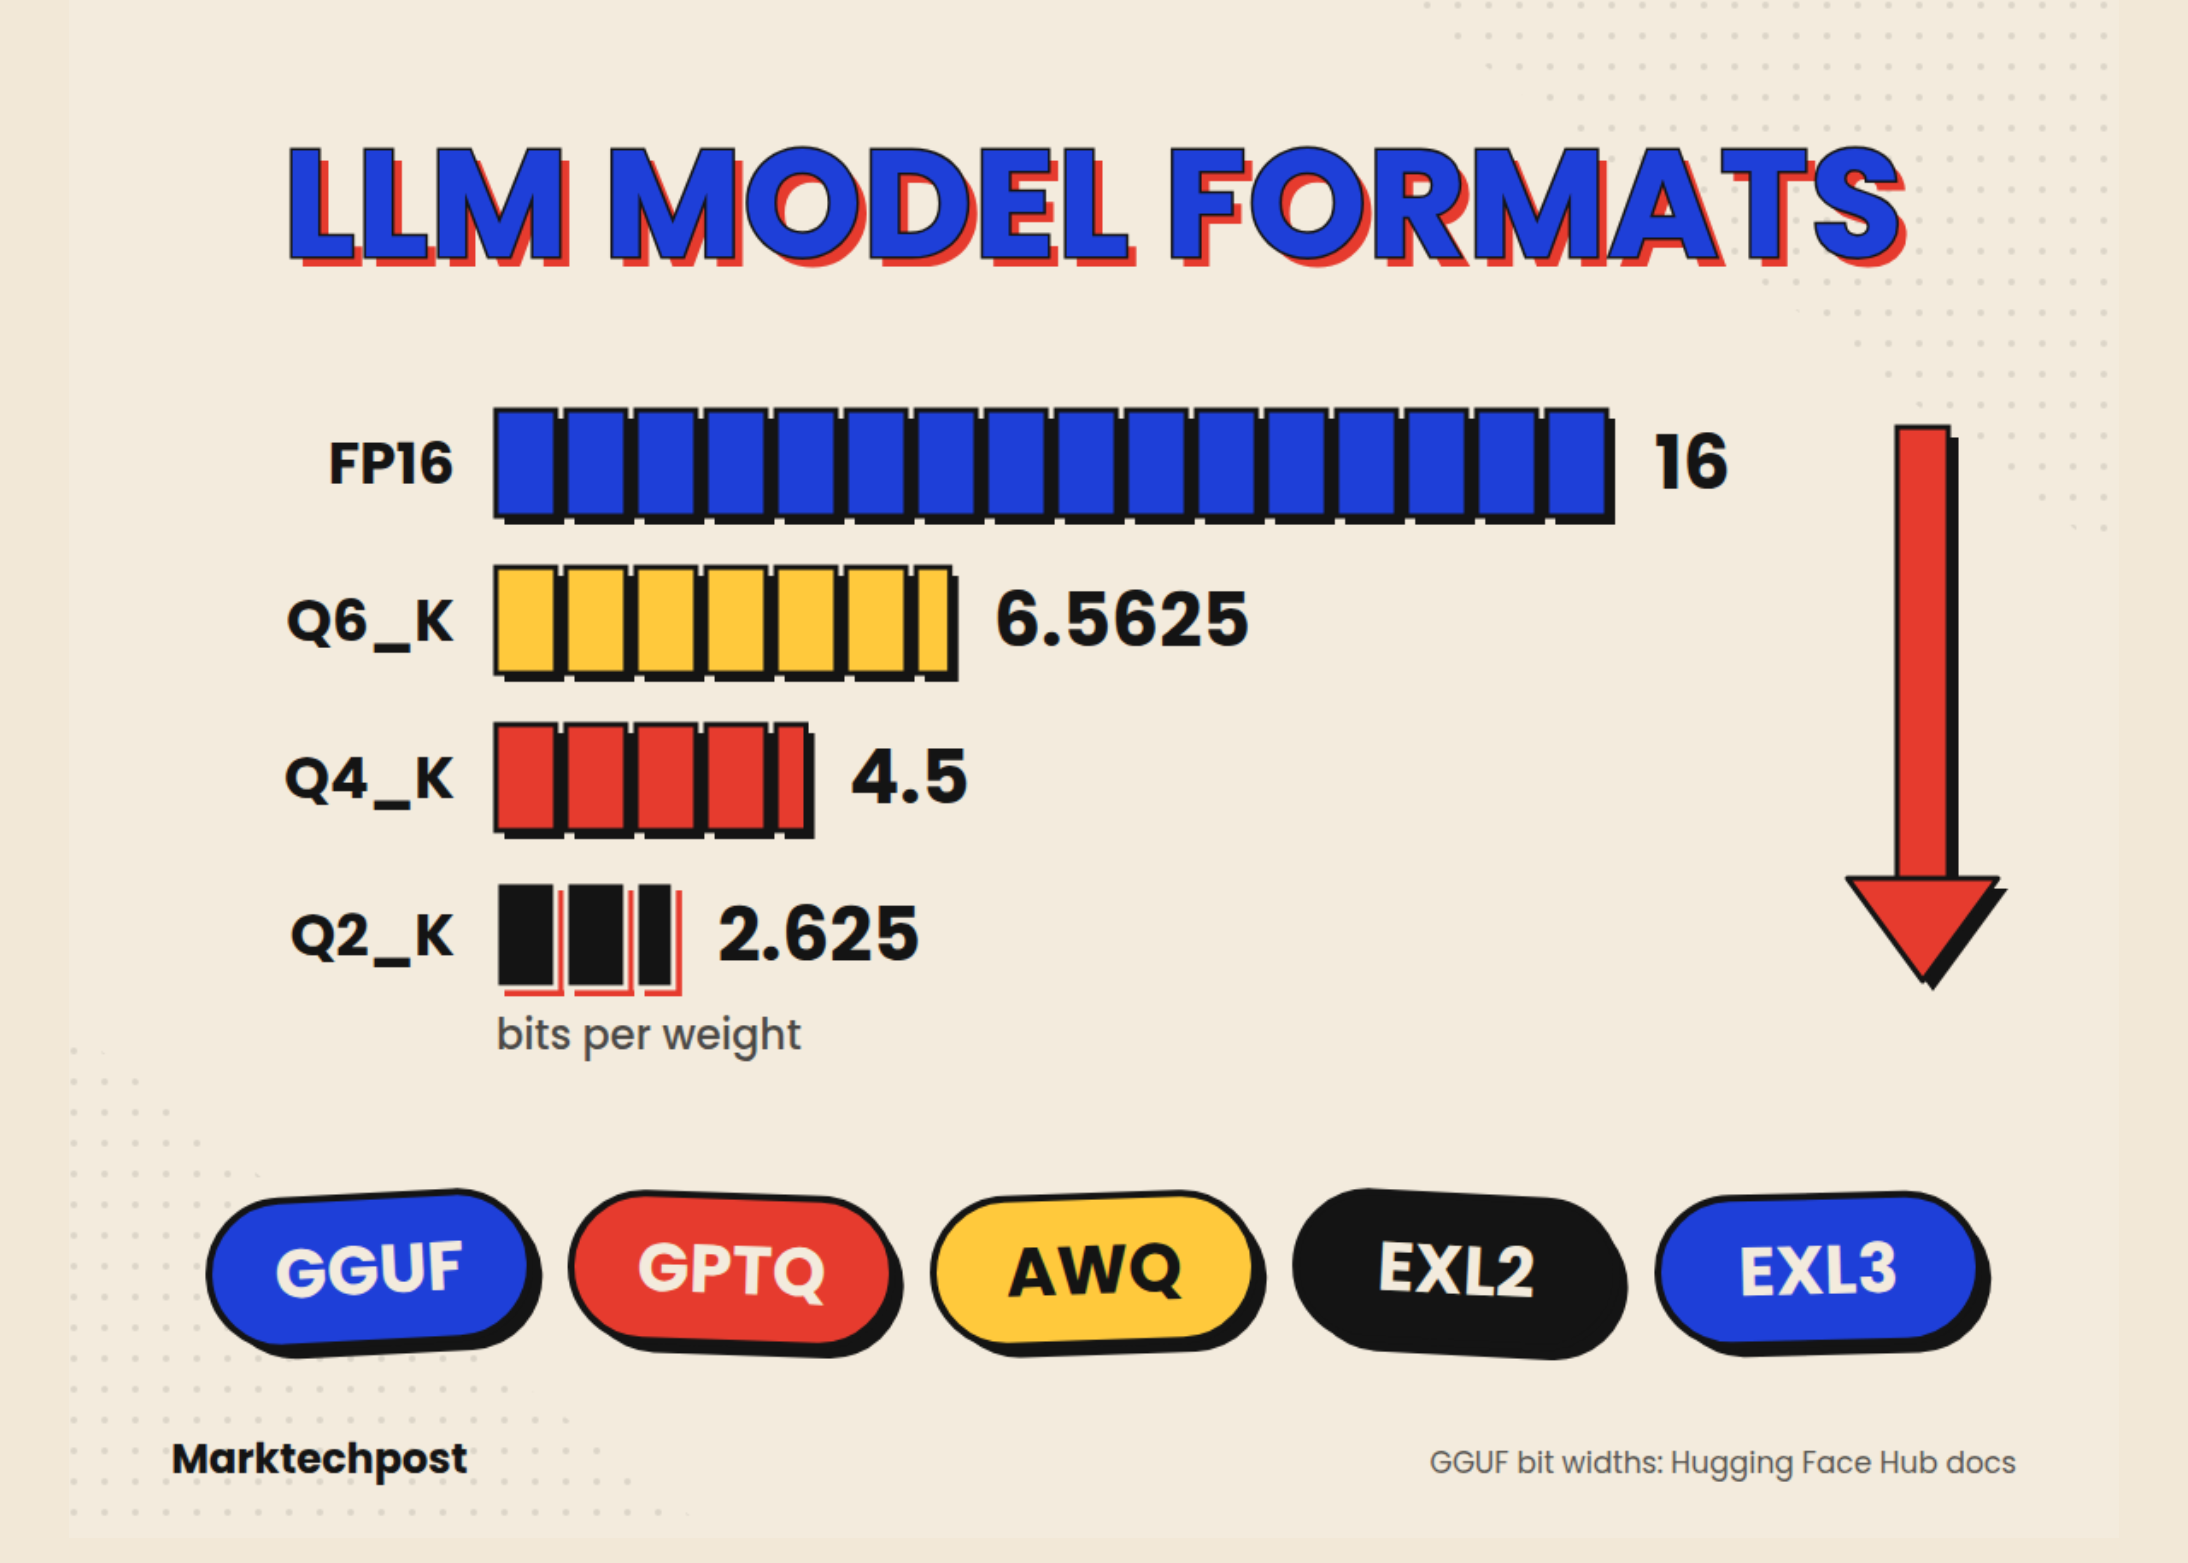
Segun MarkTechPost (AI/ML News), el panorama de modelos de lenguaje grandes (LLM) en 2026 presenta una división clara entre formatos de almacenamiento y técnicas de reducción de bits. Esta distinción es clave para comprender cómo se gestionan los recursos de memoria y seguridad en los sistemas de inferencia. Los usuarios suelen confundir dos conceptos independientes: el formato de contenedor y el método de cuantización. El primero determina cómo se almacenan los tensores en disco, mientras que el segundo define cómo se comprimen los pesos del modelo en menos bits.
Los formatos de contenedores incluyen safetensors, GGUF y archivos de PyTorch (.bin o .pt). Los archivos .bin y .pt, basados en pickle, permiten cargar tensores pero pueden ejecutar código arbitrario, lo que representa un riesgo de seguridad cuando se usan modelos no verificados. Safetensors, desarrollado por Hugging Face, resuelve esta vulnerabilidad al estructurar el archivo como una cabecera en formato JSON y datos brutos de tensores sin código ejecutable. Esta solución permite cargar los tensores de forma segmentada, sin necesidad de cargar todo el archivo en memoria. Actualmente, safetensors es reconocido como proyecto de la Fundación de PyTorch.
Por otro lado, GGUF es un formato binario diseñado para ejecutar modelos mediante el motor GGML, utilizado principalmente en entornos como llama.cpp. Fue creado por Georgi Gerganov, líder de llama.cpp, y lanzado oficialmente el 21 de agosto de 2023 como sustituto del formato anterior GGML. La principal ventaja de GGUF radica en que especifica explícitamente la arquitectura del modelo, evitando que cambios en parámetros de configuración invaliden archivos existentes. Además, muchos modelos cuantizados —como GPTQ, AWQ, EXL2 o EXL3— también se almacenan en formato .safetensors, donde la cuantización se aplica directamente a los datos de los tensores y a un archivo de configuración, no a un nuevo formato de almacenamiento.
La regla práctica para estimar el uso de memoria es que el tamaño de los pesos se calcula como: (número de parámetros × bits por peso) dividido entre 8. Esta fórmula es matemática y no depende de pruebas comerciales. Solo considera los pesos del modelo, sin incluir el espacio adicional ocupado por la caché de claves-valor (KV cache) o los costos de ejecución en tiempo real.
Para los lectores peruanos, esta evolución es relevante en el contexto de acceso a inteligencia artificial de bajo costo. Muchas herramientas de inferencia ahora permiten ejecutar modelos grandes en dispositivos locales, como computadoras personales o servidores domésticos. La adopción de formatos seguros como safetensors y soluciones eficientes como GGUF facilita la democratización de estos modelos, permitiendo que profesionales de finanzas, emprendedores o estudiantes en administración aprovechen capacidades de análisis predictivo sin depender exclusivamente de infraestructura cloud. Esto puede impulsar innovaciones en áreas como la gestión de riesgos o la toma de decisiones empresariales en entornos locales.