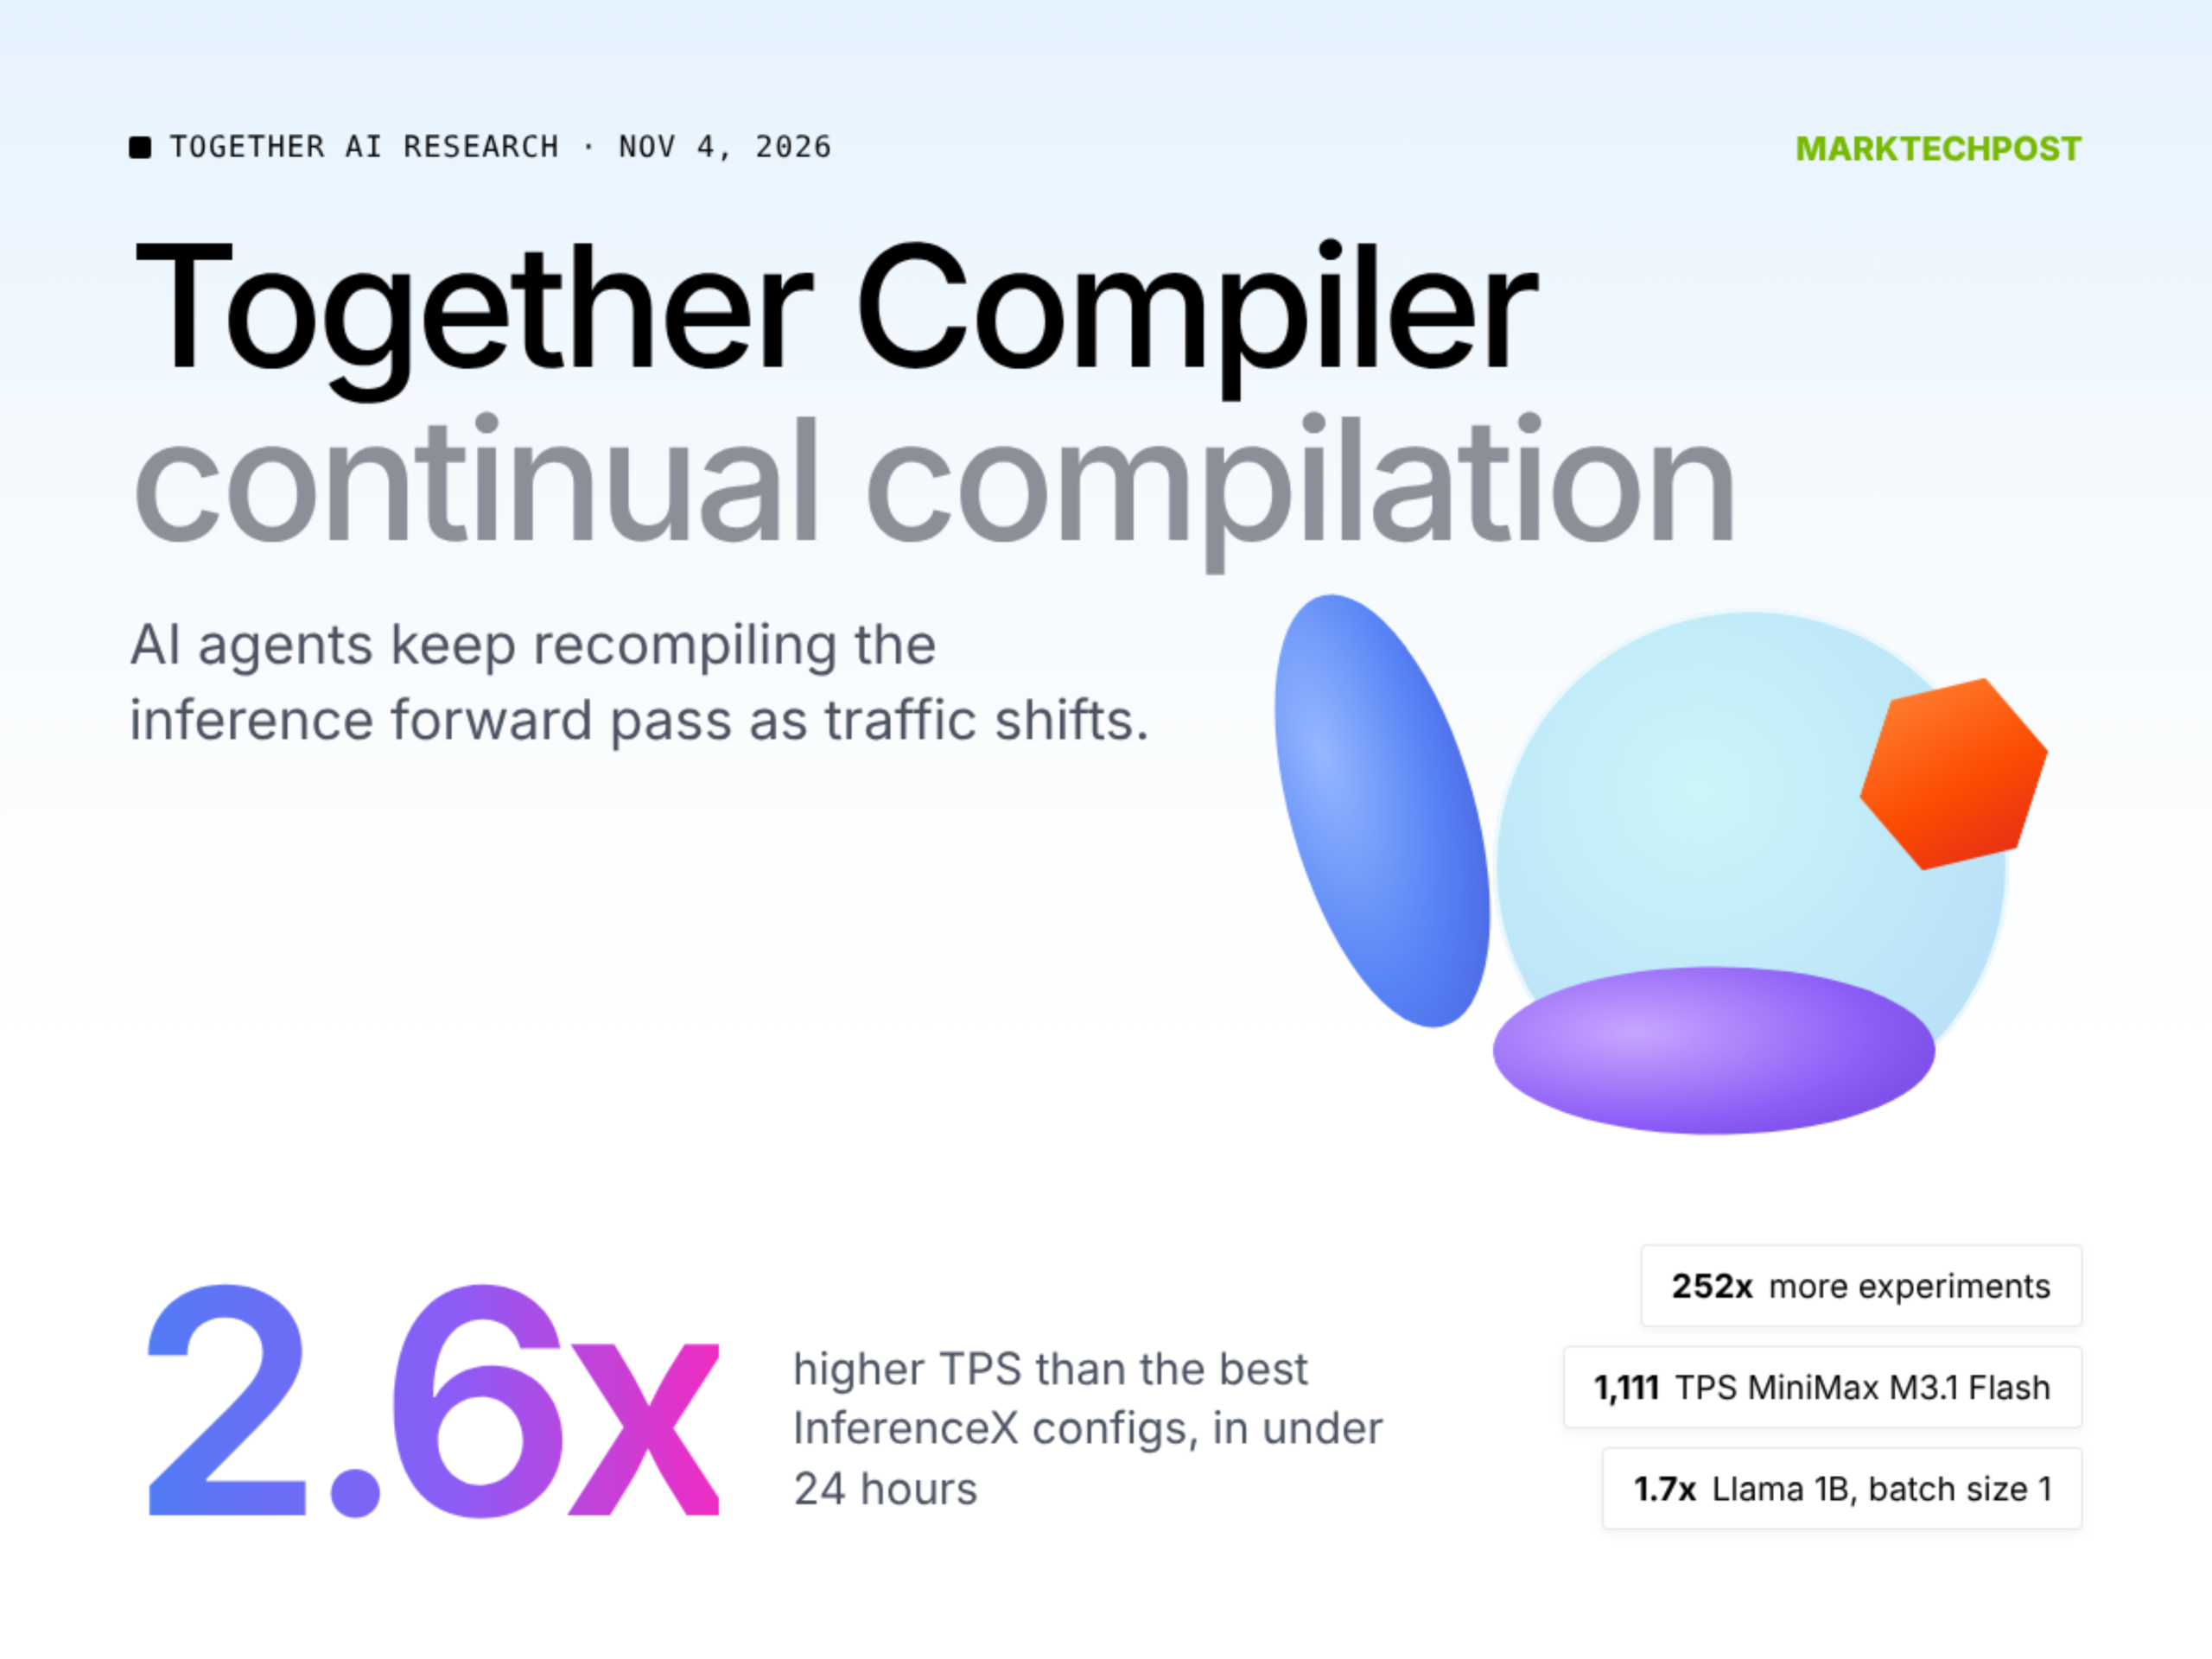
Segun MarkTechPost (AI/ML News), Together AI ha lanzado Together Compiler (TKCC), un sistema de optimización continua que reconfigura en tiempo real el proceso de inferencia de modelos lingüísticos. Este mecanismo opera mediante agentes de código que analizan y reescriben el flujo de cálculo de los modelos, adaptándose dinámicamente a variaciones en el tráfico de usuarios y la configuración de hardware. La solución se pone en marcha con comandos de lanzamiento de servidores, perfiles de tráfico y especificaciones técnicas del equipo, y luego evalúa cada propuesta de ejecución mediante un motor persistente que selecciona el rendimiento óptimo.
El sistema fue validado en múltiples modelos, incluyendo Kimi K3, GLM 5.3, MiniMax M3.1 Flash, DeepSeek v4.1 Flash y Llama 1B. Su ejecución se realiza en hardware como NVIDIA B200, B300, GB300, H100, AMD MI355X y AWS Trainium2. En cada caso, se utilizan como máximo dos nodos por modelo. Los resultados muestran un aumento significativo en la capacidad de procesamiento: alcanza hasta 2.6 veces más transacciones por segundo (TPS) que las configuraciones publicadas de InferenceX, todo en menos de 24 horas. El mejor desempeño se registra en MiniMax M3.1 Flash, con 1.111 TPS en el percentil 90 (P90), un avance del 180% respecto a una base de 633 TPS. En contraste, el peor resultado, en GLM 5.3 ejecutado en MI355X, solo alcanza una mejora del 4%, pasando de 463 a 480 TPS.
La necesidad de esta continuidad técnica surge porque los patrones de uso de los modelos no son estáticos. En un escenario geográfico, por ejemplo, los prompts promedian 97 mil tokens en una región, frente a 70 mil en otras. En un cliente, el tamaño de los prompts aumentó de 18 mil a 33 mil tokens en apenas tres días. Además, pruebas revelan que ajustes realizados con datos aleatorios pueden inducir errores: dichos datos activan hasta un 38% más de expertos en arquitecturas de modelos (MoE) que el tráfico real. Un kernel diseñado por un agente logra 20 microsegundos en entradas aleatorias, pero su rendimiento se degrada al aplicarse a contextos reales de 70 mil tokens.
Para el lector peruano, esta evolución en inteligencia artificial tiene implicaciones directas en la accesibilidad y eficiencia de los servicios digitales. En un mercado donde la demanda de asistencia en línea, procesos administrativos o soluciones de inversión cambia rápidamente, una infraestructura que se adapta en tiempo real podría reducir costos operativos y mejorar la calidad de respuesta. Aunque aún no se han implementado estos avances en plataformas locales, su funcionamiento podría servir como modelo para que empresas de servicios públicos o privados en el país optimicen sus procesos digitales. La clave no está en tener el mejor modelo, sino en mantenerlo en constante actualización, algo que el futuro de la automatización requiere.