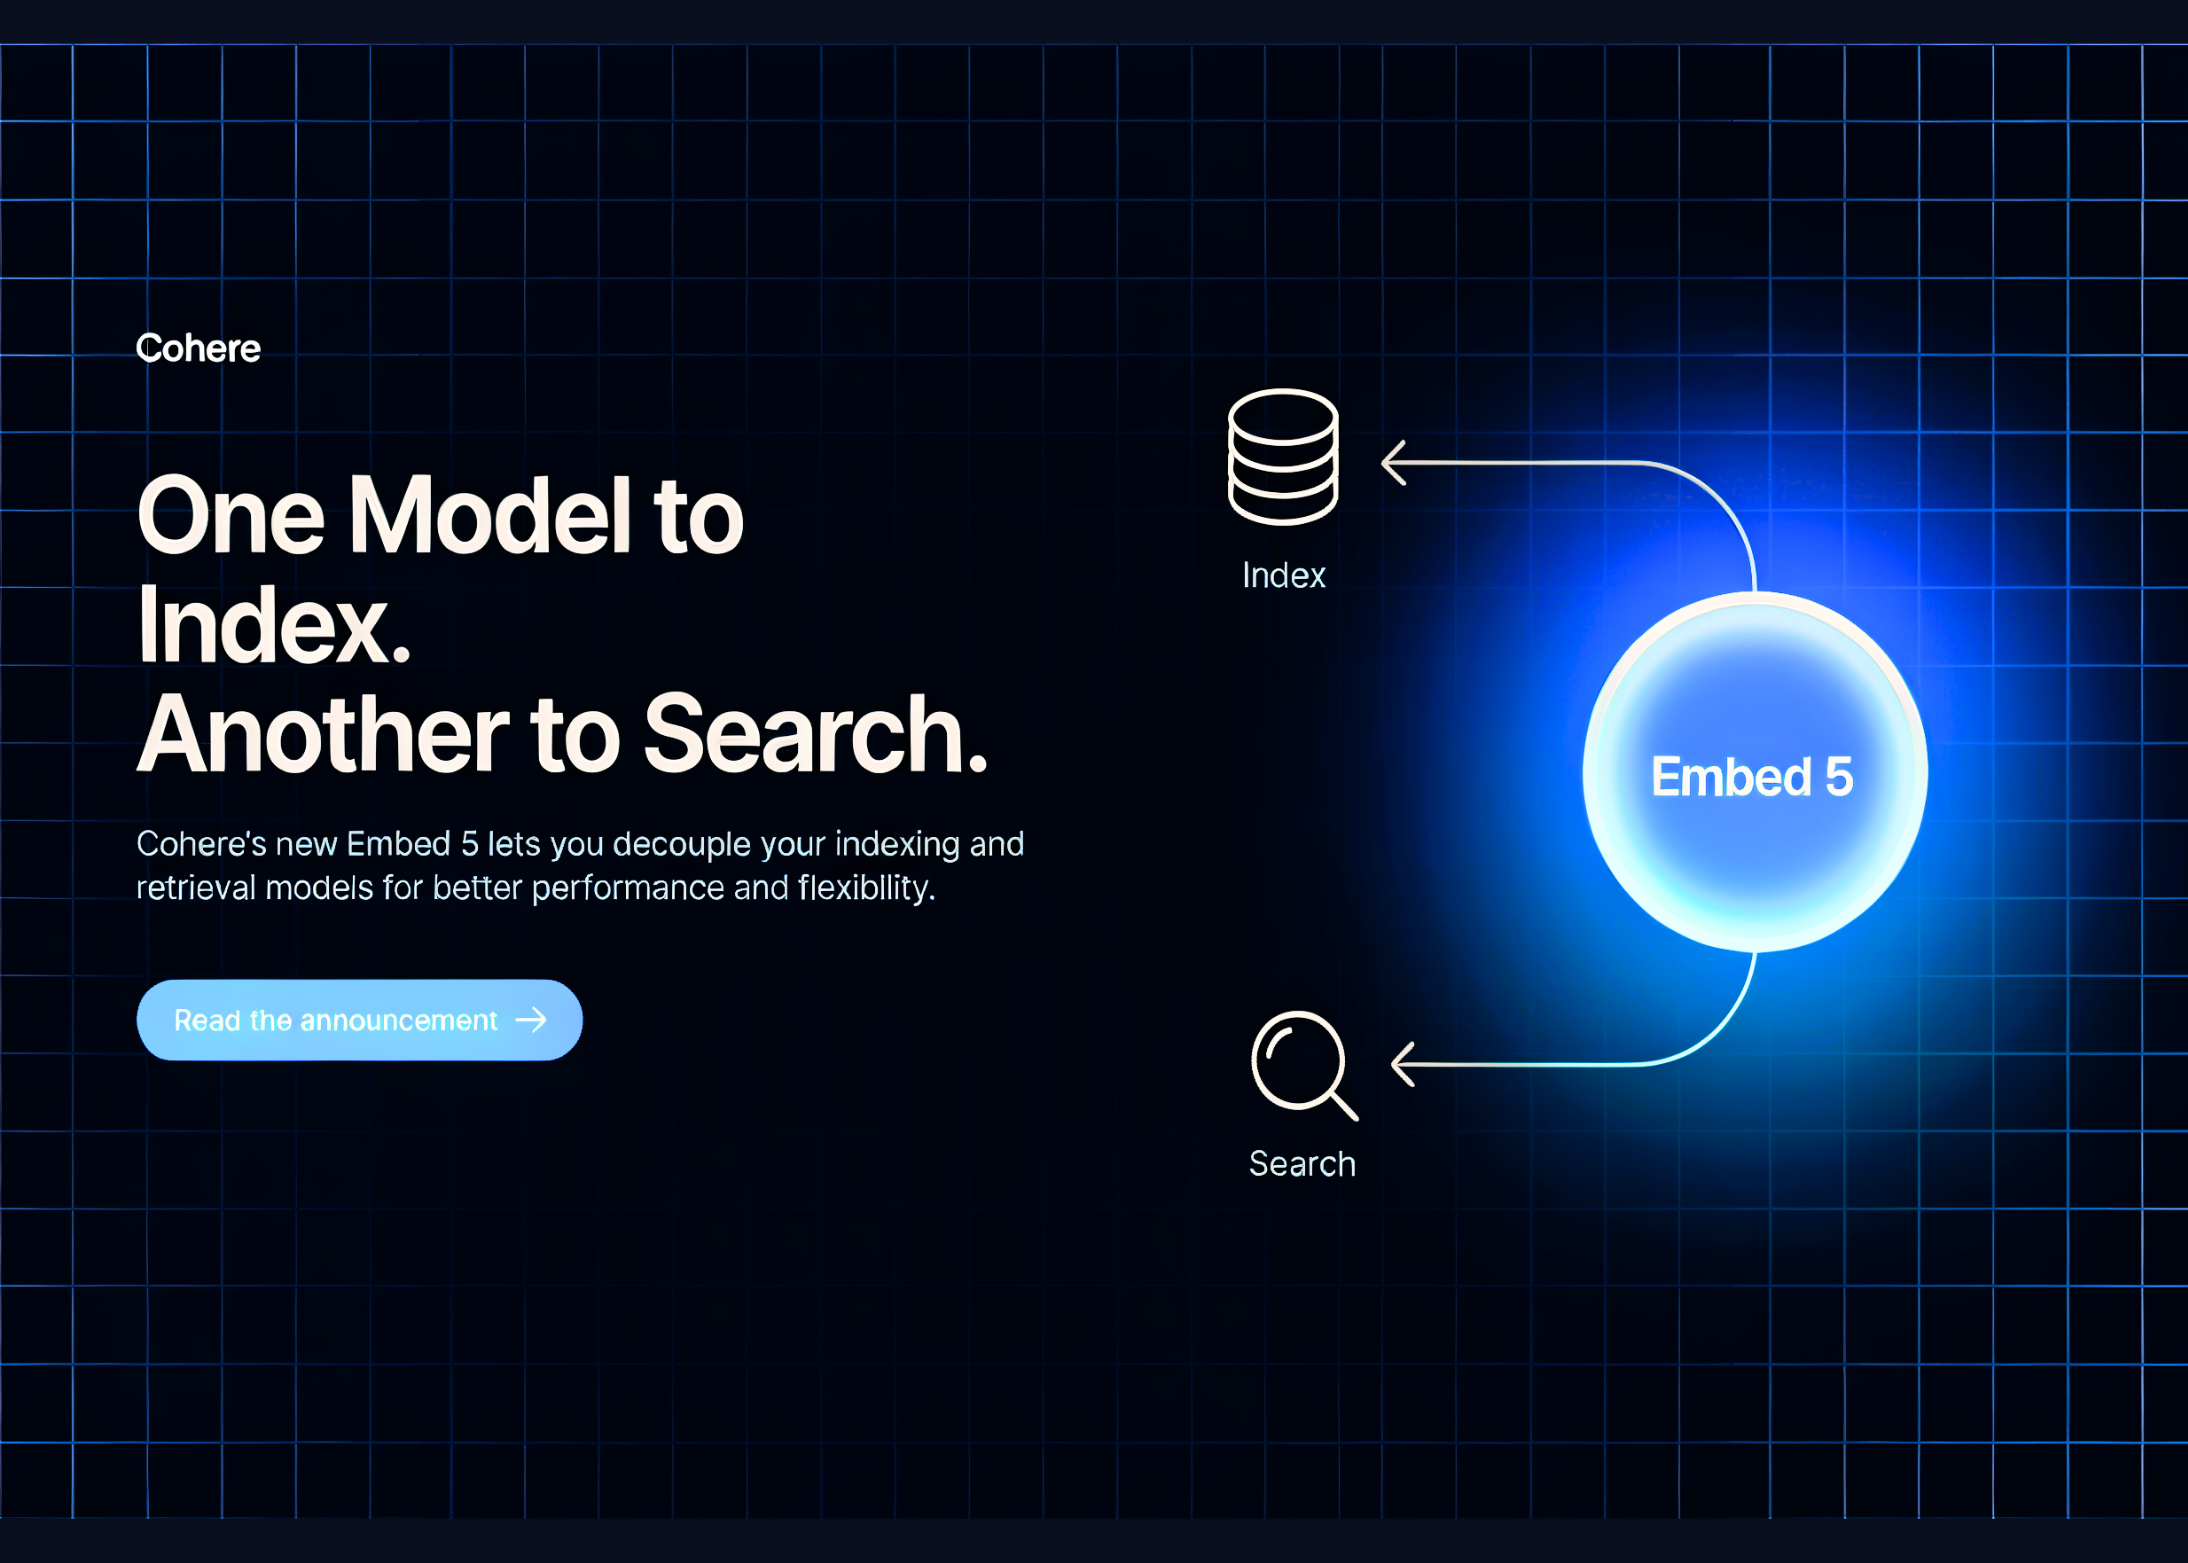
Segun MarkTechPost (AI/ML News), Cohere ha presentado Embed 5, una nueva familia de modelos de embeddings diseñados para aplicaciones empresariales en búsquedas, recuperación por contenido y sistemas agenctes. El lanzamiento incluye dos niveles de servicio: Embed 5 Pro, enfocado en calidad máxima de recuperación, y Embed 5 Fast, optimizado para reducir latencia y costos en consultas en tiempo real. Ambos modelos admiten entradas de texto, imágenes y combinaciones de texto e imagen, cubriendo más de 100 idiomas y procesando hasta 128 mil tokens. La innovación clave radica en que ambos modelos comparten un mismo espacio de embeddings, permitiendo indexar con Pro y realizar búsquedas con Fast, sin pérdida de precisión.
Los modelos están disponibles actualmente en plataformas como el API de Cohere, Model Vault, Microsoft Foundry y Amazon SageMaker. Para entornos privados o locales, se pueden ejecutar mediante vLLM. Los identificadores de modelo en el API son embed-v5.0-pro y embed-v5.0-fast. Ambos ofrecen dimensiones de salida en 2048, 1536, 1024, 768, 512 o 256, con 2048 como valor predeterminado. Los embeddings se entregan en formato flotante, entero de 8 bits o binario. En cuanto a costos, el modelo Pro cobra $0.12 por 1 millón de tokens de texto, mientras que Fast cuesta $0.08. Los ingresos por imágenes son iguales en ambos: $0.40 por millón de tokens. Además, Embed 5 permite integrar directamente imágenes de páginas, fusionarlas con sus metadatos y generar un solo vector, una funcionalidad clave para documentos escaneados, presentaciones, esquemas o gráficos donde la extracción de texto pierde información relevante.
En pruebas con 40 conjuntos de datos, Cohere observó que al indexar con Pro y consultar con Fast, el rendimiento alcanza un 98.4 sobre una escala normalizada de 100. Un entorno completo con Fast obtiene 96.6, mostrando que la combinación es más eficiente que usar solo el modelo rápido. La recomendación técnica es seguir esta estrategia, siempre que ambas partes utilicen la misma dimensión de salida. Los resultados en el benchmark ViDoRe V3 muestran que Embed 5 Pro obtiene un promedio de 85.8, un aumento de 8.8 puntos respecto a Embed 4, mientras que Fast alcanza 84.5. El modelo Fast también logra procesar 377.3 documentos por segundo, frente a 159.7 del Pro, lo que evidencia una superioridad en velocidad, especialmente en tareas agenctes que requieren múltiples búsquedas.
Para inversores y profesionales de gestión en Perú, esta evolución en tecnologías de inteligencia artificial ofrece una herramienta más eficiente para gestionar grandes volúmenes de información en entornos como contabilidad, auditoría o gestión de documentos. Las empresas que operan con grandes volúmenes de datos digitales, como bancos, entidades públicas o centros de servicios, podrían implementar esta tecnología para mejorar la precisión y la rapidez de sus procesos de búsqueda, reduciendo errores y optimizando costos operativos. Aunque aún en etapa de desarrollo, su disponibilidad en plataformas líderes y su enfoque en aplicaciones reales hacen que sea una opción viable para el crecimiento de procesos administrativos en el país.