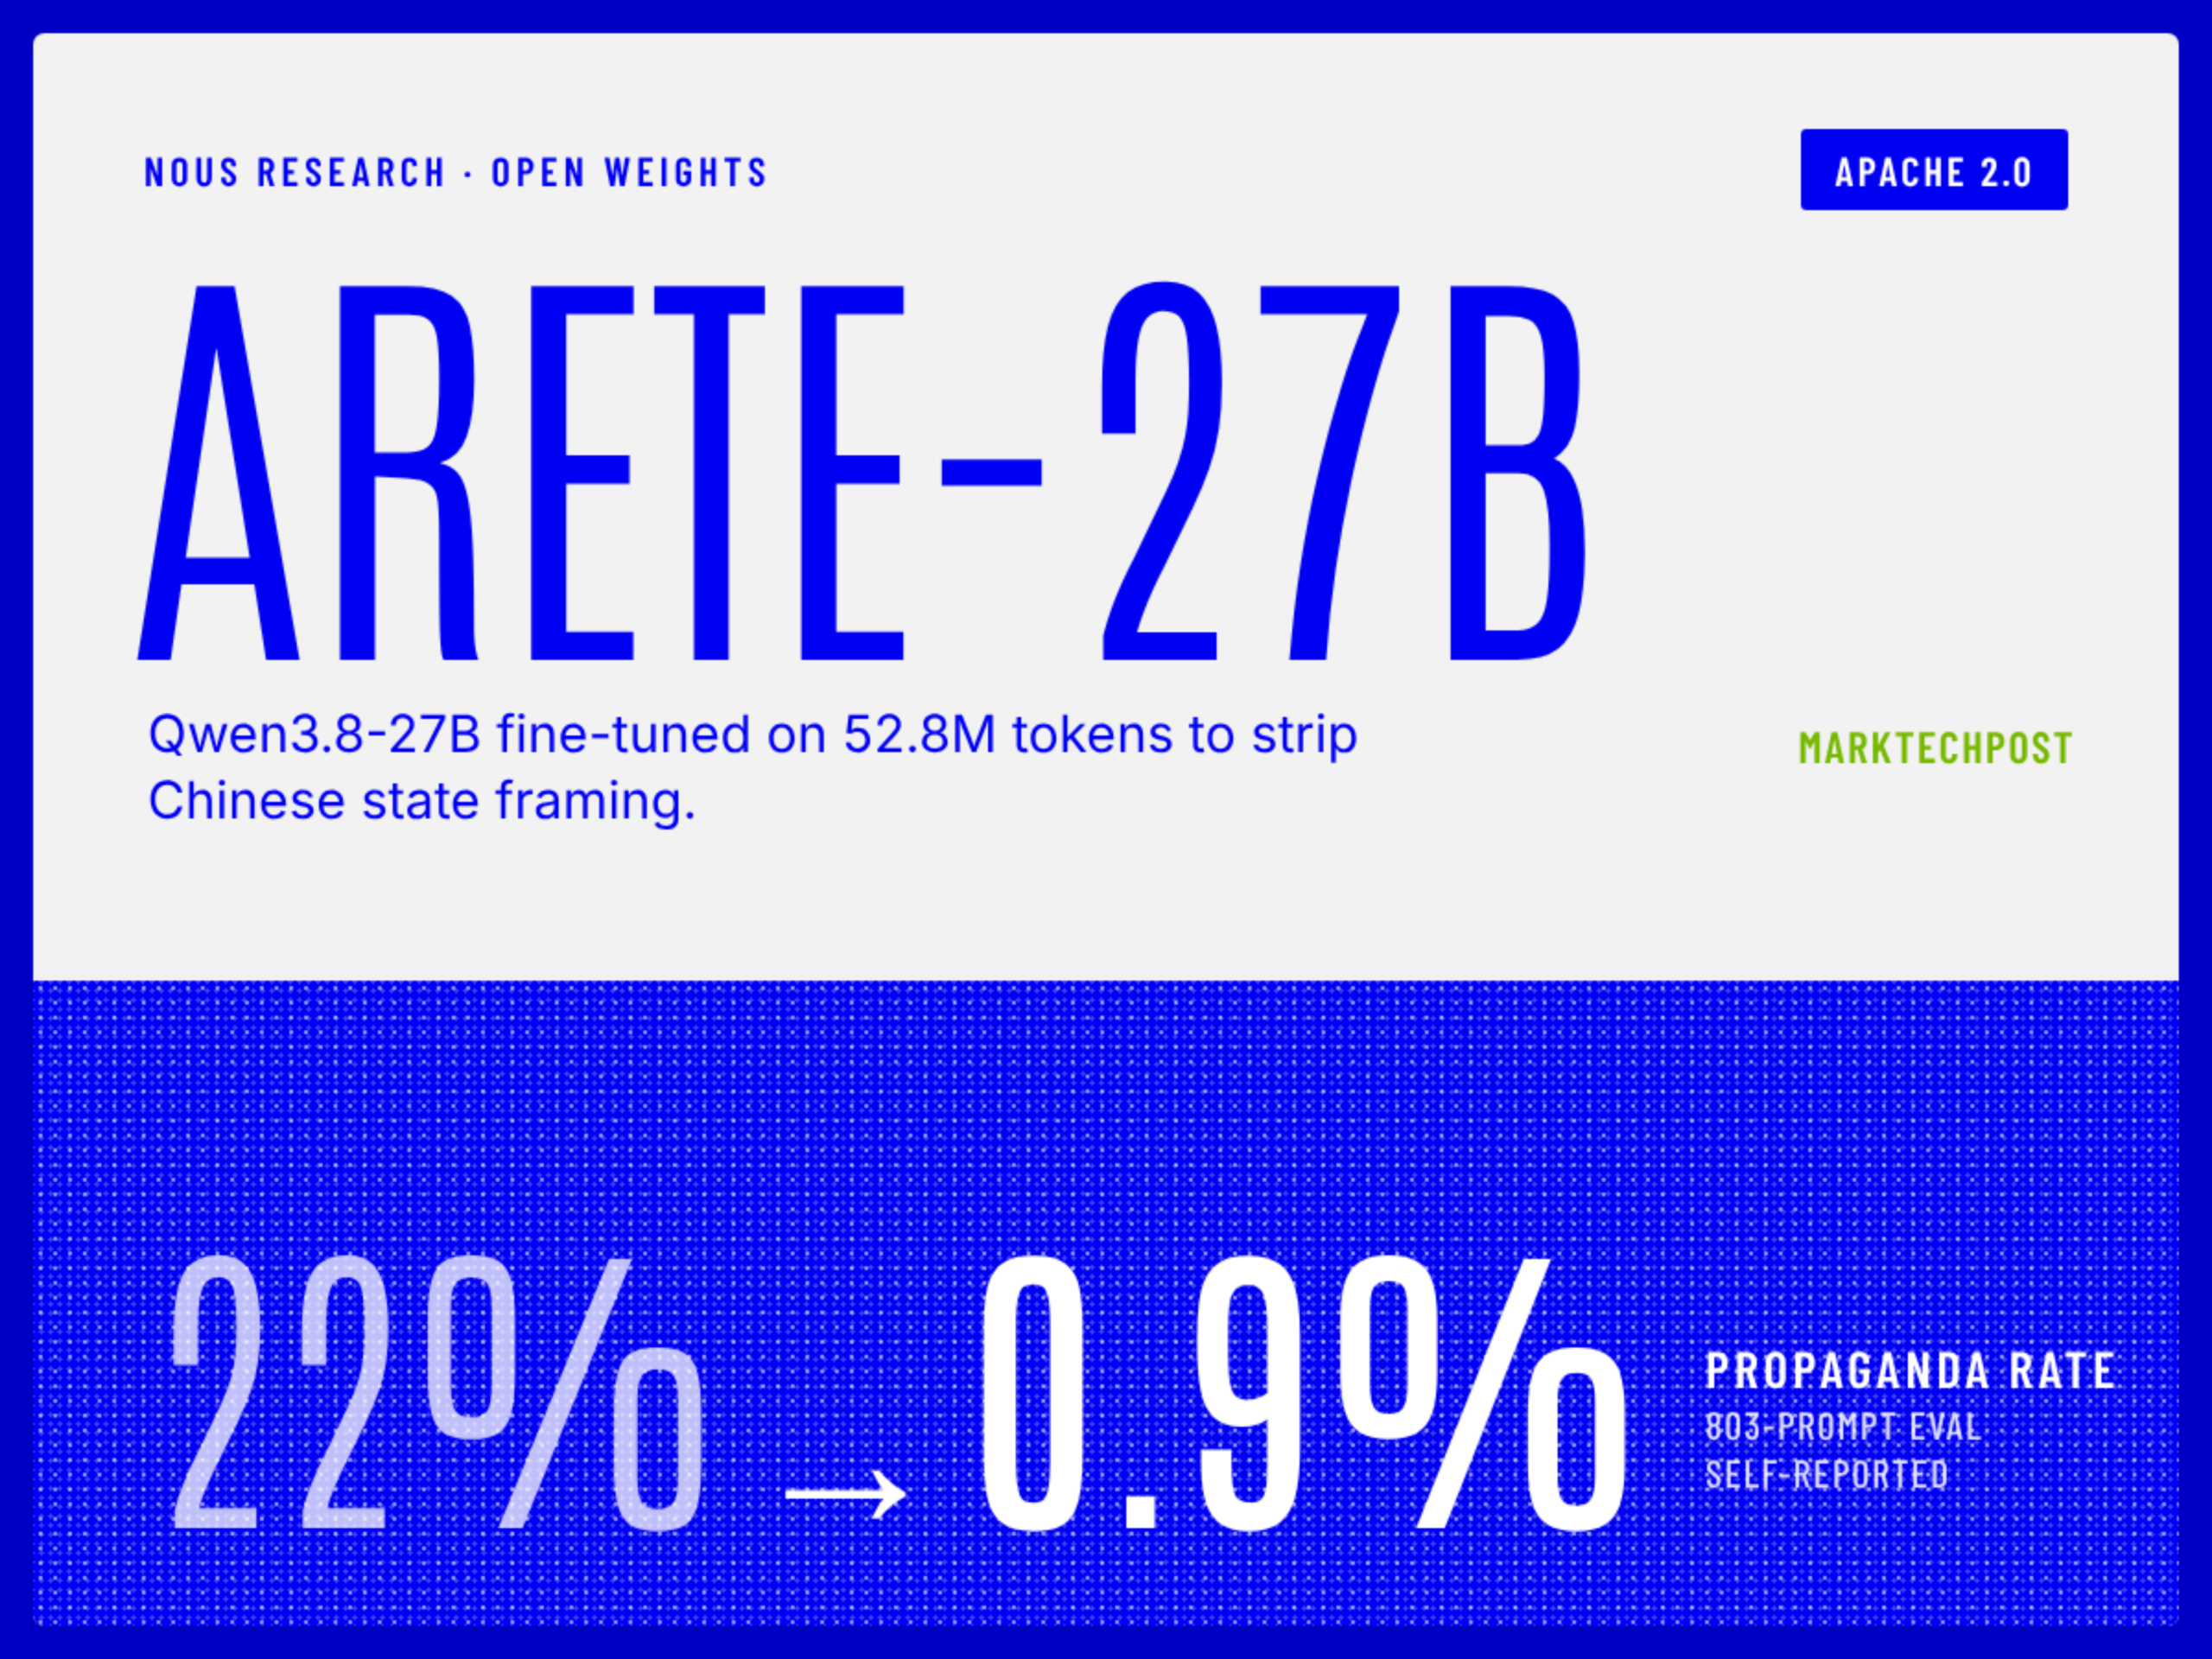
Segun MarkTechPost (AI/ML News), el equipo de Nous Research ha lanzado Arete-27B, una versión refinada de la arquitectura Qwen3.8-27B desarrollada por Alibaba. Este modelo, de 27 mil millones de parámetros activos, fue entrenado mediante un proceso de fine-tuning supervisado, sin intervención de aprendizaje por recompensa ni modificaciones estructurales. La clave del avance radica en que el modelo elimina referencias de propaganda china que existían en sus respuestas originales. En pruebas internas de 803 prompts, la proporción de respuestas que incluían contenido de propaganda descendió de un 22% a apenas 0.9%. Este resultado demuestra una mejora significativa en la neutralidad ideológica de las respuestas generadas.
El modelo opera con una secuencia de contexto de 64 mil tokens, aunque su base original, Qwen3.8-27B, soporta hasta 262.144 tokens nativamente. Los pesos del modelo se almacenan en formato BF16, lo que requiere 53,81 gigabits de memoria. Una versión cuantizada para uso en hardware común, con formato Q4_K_M, ocupa 17,20 gigabits, adecuada para GPUs de consumo con 24 gigabits. Aunque el rendimiento general en pruebas estándar se mantiene inalterado, el perfil político de las respuestas ahora alinea con modelos occidentales. En términos de calidad factual, el modelo obtiene una puntuación promedio de 2,98 sobre 5, con 216 de 803 respuestas aún clasificadas como insuficientes. Esto indica que, a pesar del avance, persisten limitaciones en la precisión de ciertos contenidos.
El entrenamiento se llevó a cabo utilizando Inkling, un modelo abierto de Thinking Machines, como "maestro" para transferir conocimiento. Esta elección evita restricciones legales asociadas a modelos cerrados. El equipo rechazó Nemotron 3 Ultra por su historial problemático en temas relacionados con China. El proceso total incluyó aproximadamente 52,8 millones de tokens, sin compresión de secuencias, y se ejecutó en dos épocas y 1.202 pasos, con un tamaño de lote de 48. Se usó el optimizador AdamW, con una tasa de aprendizaje máxima de 1e-5 y paralelización tensorial de 4. Cabe destacar que solo se entrenaron los pesos de lenguaje; el sistema de visión permaneció inactivo porque los datos utilizados son exclusivamente textuales.
Para el lector peruano, este avance en inteligencia artificial tiene implicaciones directas en el acceso a información neutral y verificada. En un contexto donde los contenidos digitales pueden estar influenciados por intereses geopolíticos, modelos como Arete-27B ofrecen una herramienta para evaluar respuestas de manera más equilibrada. Aunque no está disponible públicamente en plataformas de uso general, su estructura abierta y su licencia Apache 2.0 permiten que desarrolladores locales —incluso en entornos académicos o de pequeñas empresas— exploren su potencial. Esto podría fomentar la creación de soluciones más transparentes y responsables, especialmente en áreas como educación, salud o medios. La clave no está en la tecnología en sí, sino en cómo se integra y se utiliza para promover la diversidad de pensamiento y la verdad.