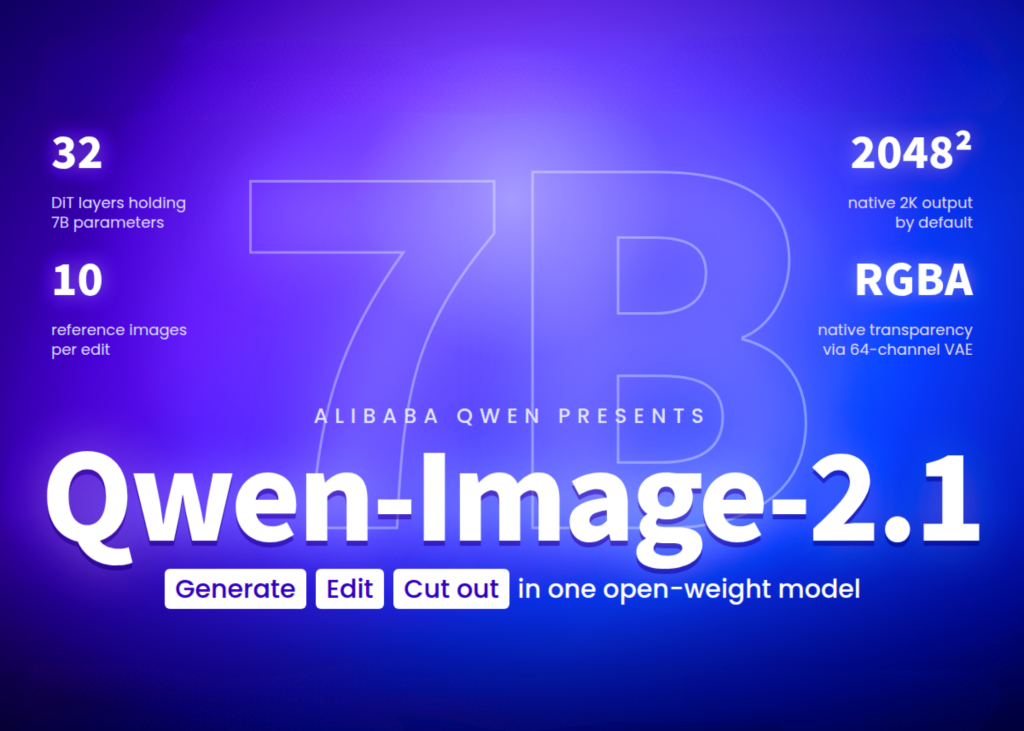
Segun MarkTechPost (AI/ML News), el equipo de Alibaba ha presentado Qwen-Image-2.1, un modelo unificado para la generación y edición de imágenes, diseñado con una arquitectura optimizada para eficiencia y rendimiento. Este modelo, que cuenta con 7 mil millones de parámetros distribuidos en 32 capas de transformador de tipo single-stream, permite operar en múltiples tareas: desde la creación de imágenes a partir de texto, hasta modificaciones locales y edición multi-referencia, con salida en formato RGBA transparente. La versión inicial, Qwen-Image, fue lanzada en agosto de 2025 con 20 mil millones de parámetros, y separaba funcionalidades de generación y edición en distintos checkpoints. Qwen-Image-2.1 integra ambas capacidades en una sola estructura, reduciendo su tamaño alrededor de un tercio, lo que lo posiciona como el modelo más equilibrado y económico de la serie Qwen-Image.
La arquitectura se compone de cuatro componentes clave. El transformador principal emplea 32 capas y atención causal por bloques, mientras que el codificador de texto utiliza el modelo Qwen3-VL de 8 mil millones de parámetros, encargado de transformar instrucciones verbales y imágenes de referencia en una representación conjunta. El autodecodificador de imágenes (VAE) opera con 64 canales y compresión espacial de 16x, permitiendo manejo nativo de transparencias. El proceso de denoising se basa en un algoritmo de flujo con discretización de Euler y ajuste dinámico, optimizando el rendimiento a lo largo de las etapas. Una innovación crítica reside en la estrategia de atención mixta: los tokens de texto aplican una máscara causal por token, mientras que los tokens de imagen utilizan una máscara bidireccional por bloques. Esta separación permite que los vectores de contexto (keys y values) se mantengan fijos desde el primer paso, reutilizando el caché de memoria para las iteraciones posteriores. Así, el modelo procesa la instrucción y la imagen de entrada una sola vez al inicio, lo que reduce significativamente el costo computacional en ciclos posteriores.
Para el usuario peruano, esta evolución en inteligencia artificial representa una oportunidad para aplicar tecnologías de generación de imágenes en entornos como educación, diseño de productos locales o marketing digital. Aunque el modelo no está disponible para uso comercial sin licencia adicional, su disponibilidad en plataformas como Diffusers y ComfyUI abre puertas a experimentos prácticos en entornos domésticos o empresariales. La reducción del tamaño del modelo, junto con su eficiencia energética y de procesamiento, responde a una necesidad creciente en mercados como el nuestro, donde los recursos tecnológicos y de infraestructura son limitados. Esto significa que incluso pequeñas empresas o profesionales independientes pueden acceder a herramientas avanzadas sin requerir infraestructura especializada. La clave para su aprovechamiento está en entender que la eficiencia no solo se mide en velocidad, sino también en accesibilidad y sostenibilidad.