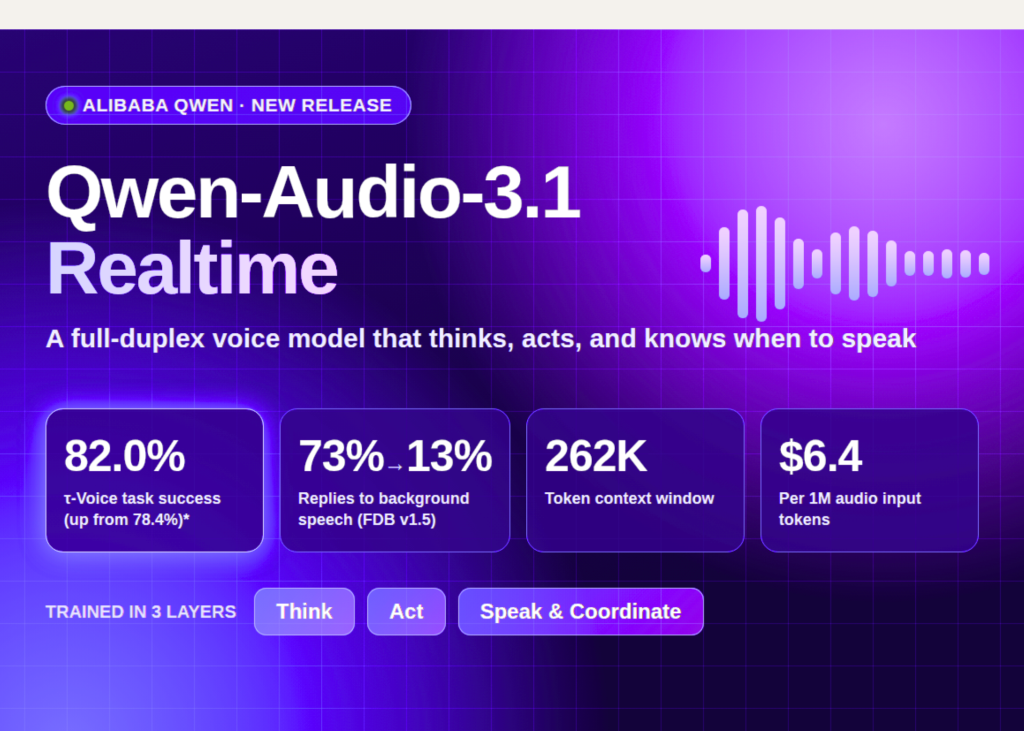
Segun MarkTechPost (AI/ML News), el equipo de Alibaba ha presentado Qwen-Audio-3.1, una pila de cinco modelos especializada en procesamiento de audio que abarca reconocimiento de voz, síntesis de voz y interacción en tiempo real. El núcleo de esta tecnología es Qwen-Audio-3.1-Realtime, un modelo de comunicación bidireccional diseñado para agentes vocales que pueden invocar herramientas y tomar decisiones dinámicas sobre cuándo hablar o no. Este avance permite que los sistemas respondan de forma más inteligente, adaptándose al contexto de la conversación en tiempo real.
El modelo está disponible como servicio gestionado a través de QwenCloud, operando por medio de WebSocket. Los precios han sido optimizados: el modelo de interacción en tiempo real se ofrece con una reducción de hasta un 85%, el TTS (síntesis de voz) con un descuento del 70% y el ASR (reconocimiento de voz) con una reducción de hasta un 95%. La estructura de precios es clara: cada millón de tokens de entrada de audio cuesta $6.4, mientras que cada millón de tokens de texto cuesta $0.8. Para la salida, el costo asciende a $24 por millón de tokens, aunque no se aplica cargo por la salida textual. El límite de uso permite 60 solicitudes y 100 mil tokens por minuto, con un contexto total de 262 mil tokens, de los cuales 245 mil son para entrada y 16 mil para salida.
La arquitectura interna se basa en dos modelos que comparten un mismo codificador de audio y diseño de red neuronal. Uno de ellos actúa como un decisor que evalúa si continuar escuchando, hablar, detenerse o reanudar la conversación. El segundo convierte el contenido generado en texto, que luego es transformado en voz mediante un rendidor de voz sensible al contexto. Este sistema toma en cuenta historial de conversación, señales de voz y condiciones acústicas. El entrenamiento se organiza en tres capas: "Piensa", "Actúa" y "Habla", cada una con funciones específicas. La capa "Piensa" utiliza datos de escucha de millones de horas para reafirmar la conexión entre audio y texto, mientras que el enfoque multimodal amplía la comprensión del contenido. Además, se integra un modelo de texto como mentor y un archivo de audio fijo como referencia.
Para el sector peruano, este avance en inteligencia artificial representa una oportunidad real para mejorar servicios en sectores como atención al cliente, educación o salud. Las empresas locales pueden adoptar soluciones de voz agente a costos reducidos, facilitando la automatización sin necesidad de inversiones masivas. Aunque el modelo no está disponible en formato abierto, su integración a través de APIs permite que pequeñas y medianas empresas prueben tecnologías avanzadas sin barreras técnicas. El enfoque en eficiencia y escalabilidad puede ser clave para adaptar soluciones digitales a entornos donde el acceso a tecnologías de vanguardia ha sido históricamente limitado.